
論文が扱う課題
対象はAli Hatamizadeh、Yejin Choi、Jan Kautzによる「Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention」です。arXiv:2605.22791v1は2026年5月21日投稿、PDFの日付は5月22日です。査読誌への掲載を示すものではなく、プレプリントとして扱います。CC BY 4.0で公開されており、転載した構成図・表・処理量グラフの出典は同著者らおよびNVIDIAです。
問いは、小さく圧縮した記憶を、他の対応関係を壊さずにどう修正するかです。単に記憶を大きくするのではなく更新を細かく制御します。以下では論文の報告結果と、技術・特許実務上の解釈を区別します。
増えるキャッシュから固定状態へ
Softmax attentionは過去のトークンを直接参照できますが、KVキャッシュは系列長とともに増えます。再帰型の線形注意は、キーと値の対応を固定サイズの行列へ蓄積します。キーは対応関係を指定し、値は内容を担い、クエリーは状態から読み出します。保存量の増大を抑える一方、多くの情報を共有空間に圧縮すると干渉が生じます。
DeltaNetは、新しい値と現在の読出し値との差を更新します。Gated DeltaNetは学習可能な忘却を加え、Kimi Delta Attention(KDA)は忘却をチャネル別にします。ただし、既存内容を消す強さと新しい値を書く強さは、なお単一スカラーbetaに結び付いていました。
二つの軸で独立に判断する
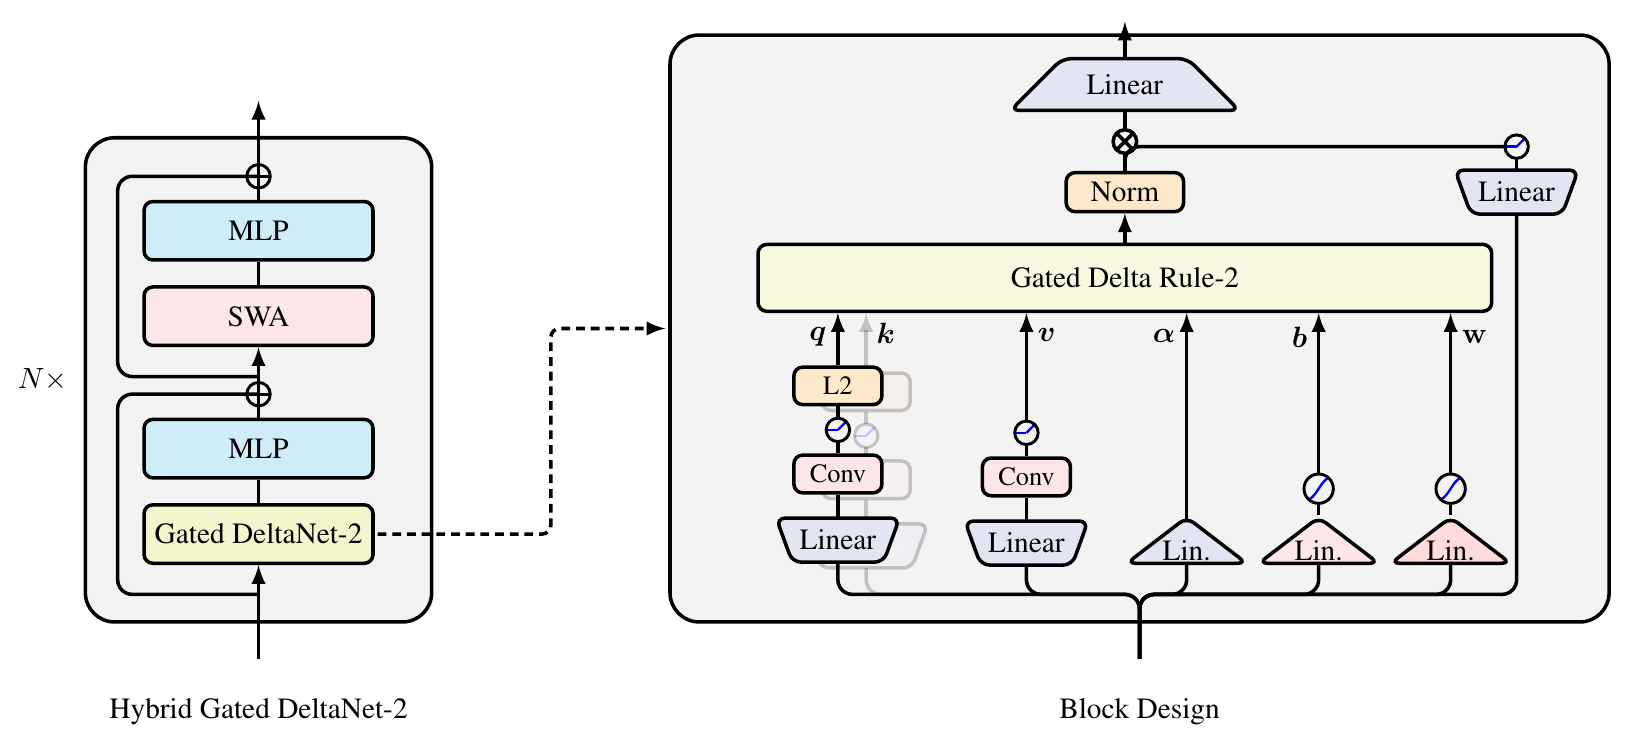
Gated DeltaNet-2はチャネル別減衰alphaを維持しつつ、独立した線形射影とシグモイドで入力依存の消去ゲートbと書込みゲートwを生成します。bはキーのチャネル、wは値のチャネルに作用し、e = b ⊙ k、z = w ⊙ vを作ります。
減衰後の状態をSbar = D Spreviousとすると、r = Sbarᵀeを読み、S = Sbar + k(z − r)ᵀで更新します。クエリーは更新後の状態を参照します。両ゲートを同じスカラーbetaにすればKDA、減衰もスカラーにすればGated DeltaNetに戻ります。二つのゲートという数より、各軸と更新項の関係が技術的な違いです。
トークン処理と並列学習
クエリーとキーは線形射影、短い因果畳込み、SiLU、L2正規化を通ります。値は射影、畳込み、SiLUを通り、再帰更新の出力にはRMS正規化、別の出力ゲート、射影を施します。この出力ゲートと書込みゲートは別物です。
学習は64トークンのチャンク単位のWY形式を使います。チャネル別の累積減衰を非対称な消去因子へ組み込み、チャンク内を三角連立方程式の求解と行列積で処理します。逆伝播ではゲートを掛けたキーと値を勾配累積に含める必要があり、スカラーbetaのように外へくくり出せません。減衰のFP32計算や状態・求解の精度も実装上重要です。
比較の条件
主な実験は13億パラメータ、FineWeb-Eduの1000億トークン、学習長4Kです。Mamba-2、Gated DeltaNet、KDA、Mamba-3のSISO・MIMO等を比較し、再帰型とハイブリッド型を分けて評価しました。後者は窓幅2Kのスライディングウィンドウ注意を追加します。
16ヘッド、キー・値各128次元なら、再帰状態は層ごと・バッチ要素ごとに262,144個の値です。モデル全体の必要メモリーではありません。ハイブリッド型には有限窓の注意キャッシュもあり、遠い履歴の圧縮と近傍のより正確な参照を組み合わせます。
言語・推論課題の結果
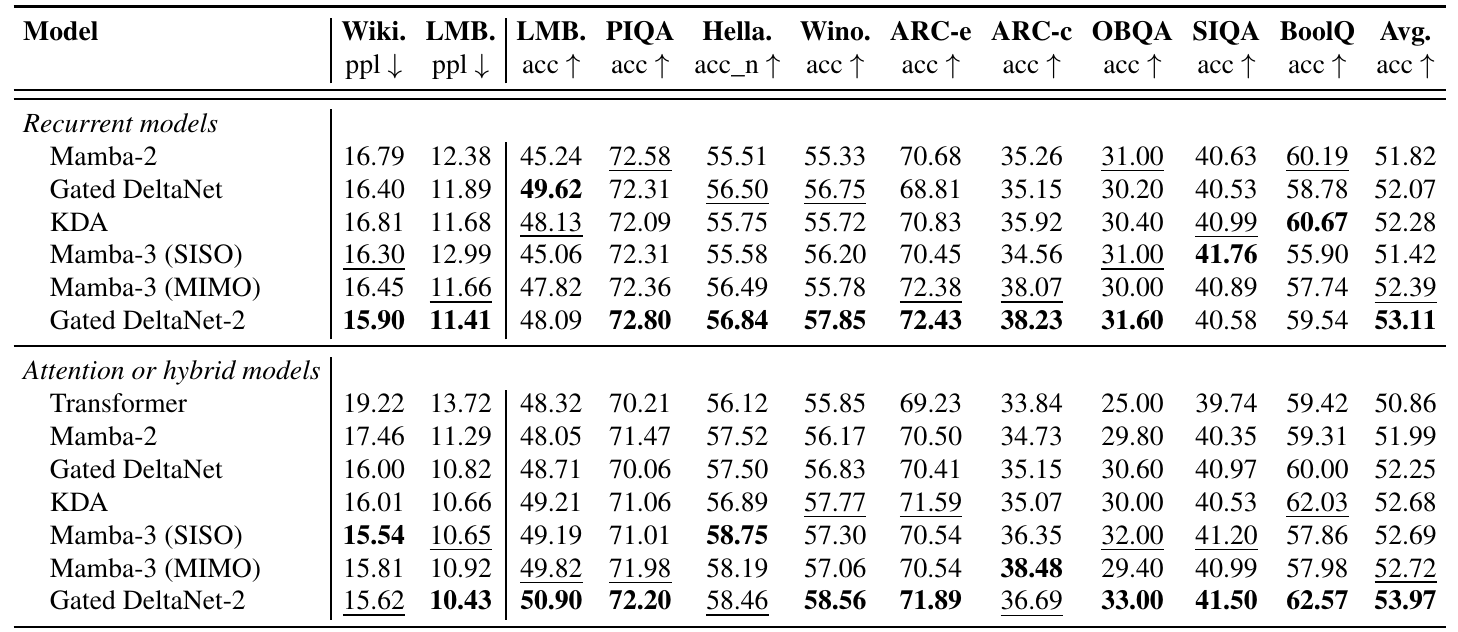
表2の平均はLAMBADA正解率と掲載された常識推論課題の正解率から計算されています。再帰型は53.11で、KDAの52.28、Gated DeltaNetの52.07を上回りました。ハイブリッド型は53.97で、比較値は52.68、52.25です。KDAとの差はそれぞれ0.83、1.29ポイントでした。
平均の改善は全課題での優位を意味しません。再帰型のLAMBADA正解率は48.09で、Gated DeltaNetの49.62より低い値です。ハイブリッド型のWikiText perplexityは15.62で、値が小さいほどよいこの指標ではMamba-3 SISOの15.54が上回ります。
検索性能の改善と残る誤り
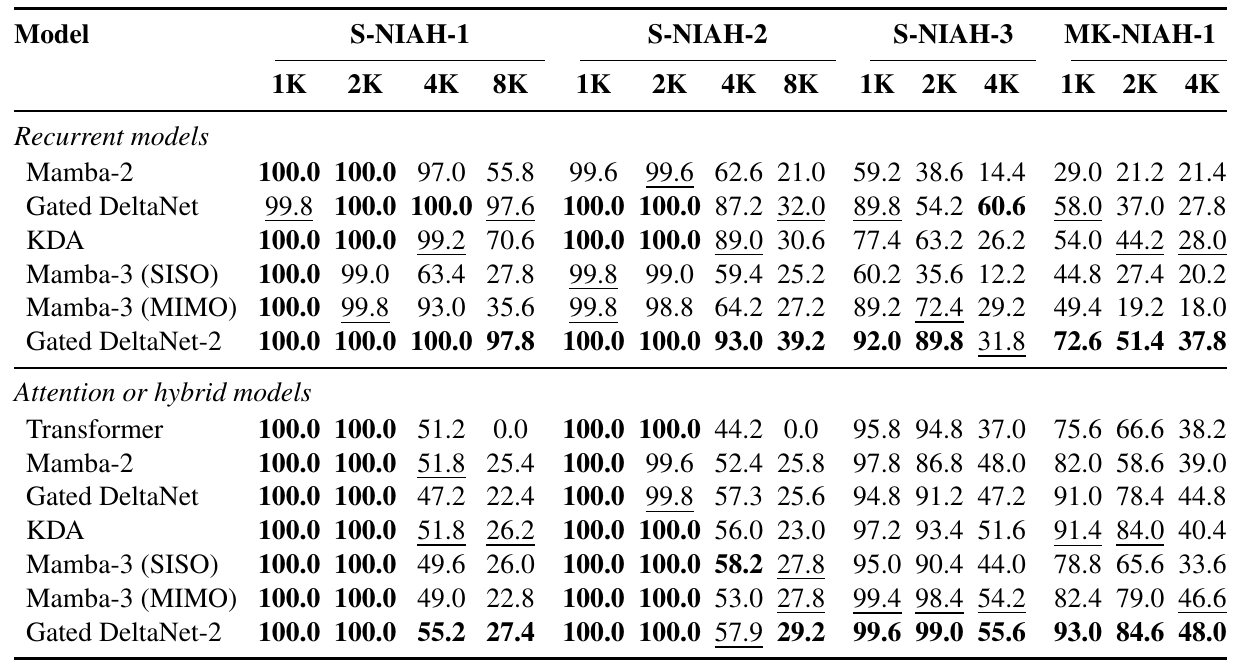
RULERの4K MK-NIAH-1では、再帰型が37.8%、KDAが28.0%、Gated DeltaNetが27.8%でした。ハイブリッド型は48.0%でKDAは40.4%です。再帰型の9.8ポイント改善は干渉低減を示唆しますが、37.8%は高信頼な検索とはいえません。再帰型S-NIAH-3は2Kで89.8%から4Kで31.8%へ低下し、Gated DeltaNetの4Kは60.6%でした。
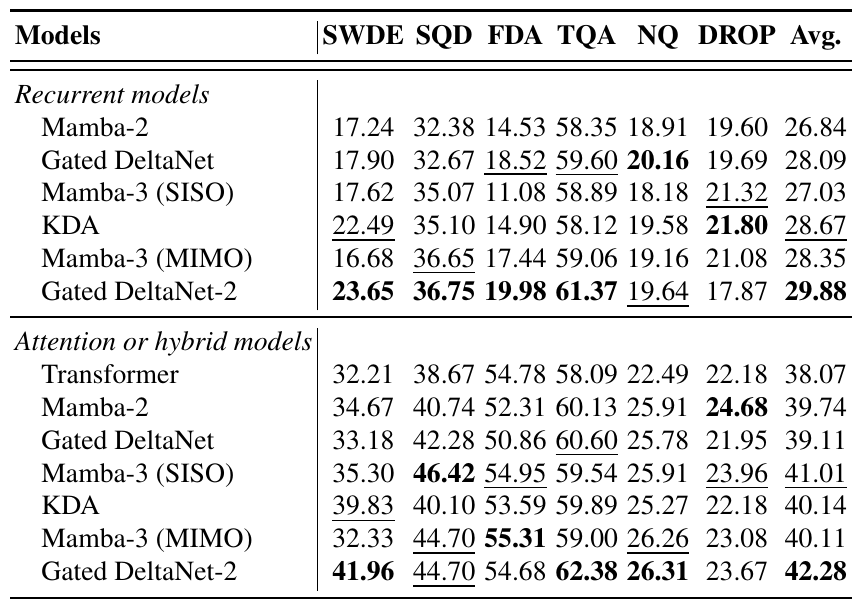
表4はSWDEのHTML抽出、FDAのPDFキー・値抽出、SQuAD、TriviaQA、Natural Questions、DROPを扱い、入力は2Kに切り詰めています。平均は再帰型29.88対KDA28.67、ハイブリッド型42.28対40.14でした。ただしDROPでは17.87対21.80とKDAを下回ります。数十万トークンの文書から正確に検索できることを実証した結果ではありません。
ゲート制限実験と学習処理量
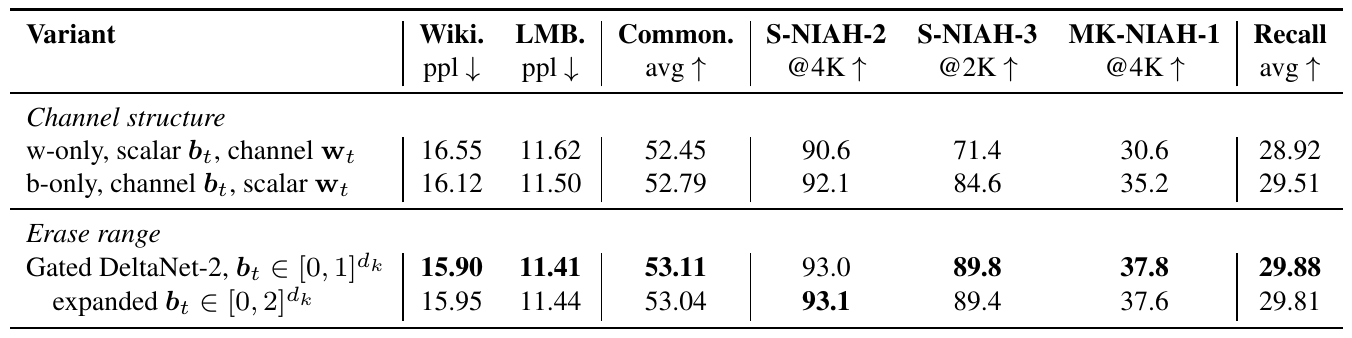
制限実験では射影の重みを残し、実行時に片方のゲートをチャネル平均したため、パラメータ数は同じです。4K MK-NIAH-1は書込み側のみチャネル別で30.6、消去側のみで35.2、両方で37.8でした。消去範囲を[0,1]から[0,2]へ拡大しても37.6で、一貫した追加改善はありません。両方の構造が寄与し、消去側のみの方が改善幅を多く回復しました。
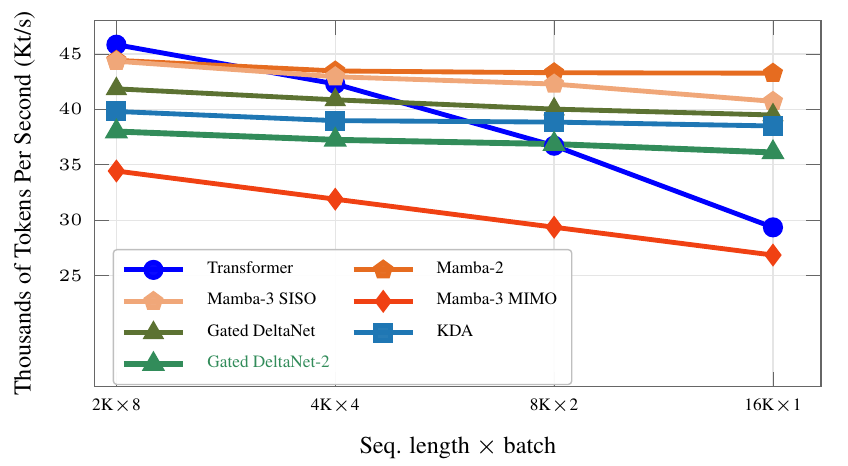
図2はH100一基で13億パラメータのハイブリッド型を学習し、総トークン数を揃えた測定です。2K×8で毎秒38.0千トークン、16K×1で36.1千トークンでした。KDAの方が若干速く、細かな制御には追加計算が伴います。推論サービスの遅延や導入費用全般を示す数値ではありません。
検証範囲を超えない
固定状態に長い履歴を蓄積するモデルや、近距離・遠距離の情報を分担する構成への応用は考えられますが、これは構成からの解釈です。韓国語特許明細書の分析、法律文書検索、特定の産業サービスで効果を検証した論文ではありません。
主要な根拠は13億パラメータと1000億学習トークンの条件に集中します。大規模化、他言語、より長い実文脈は別途確認が必要です。表には反復学習の変動や信頼区間もありません。固定状態の容量制約は残り、精密な更新が無損失保存を実現するわけではありません。
特許実務から見る構成の結合
具体的課題は、限られた再帰状態に多数の対応関係を圧縮する際の干渉と、キー側の消去・値側の書込みを一つのスカラーに縛る制約です。解決手段は、チャネル別減衰と独立ゲートを同じデルタ更新に組み込むことにあります。KDAとの差は、非対称な並列形式とゲートを考慮した勾配計算にも及びます。
技術説明では、各軸、中間値、状態更新での役割を学習計算と対応付けるべきです。効果は同等の状態サイズ、制限実験、H100条件に結び付け、課題別の弱点や追加負荷も示します。これは技術的解釈であって、特許性が立証されたとの結論ではありません。
設計上の示唆
Gated DeltaNet-2は、固定された記憶をより選択的に修正する方法です。消去と書込みを独立に学習し、その違いを再帰処理と並列学習の双方へ反映します。
重要なのは、干渉という課題、協調した更新式、測定された効果のつながりです。最高点だけに注目せず、限界と一緒に読むことで次の設計判断に役立ちます。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
Gated DeltaNet-2論文・第1版 · CC BY 4.0