
IPLEX特許法律事務所の韓国弁理士、キム・ヨンドクによる技術論文の解説です。
同じ単語でも、前後の文脈によって指す対象は変わります。AIが対話の履歴を圧縮して記憶する場合も、この違いを残す必要があります。異なる文脈を一つの記憶に詰め込むと、情報を取り出す際に対応関係が干渉することがあります。
Switching Linear Attention(SwiLA)は、固定サイズの記憶を複数の線形回帰成分に分け、入力と既存の記憶との関係に応じて更新の配分を調整する手法です。記憶領域を際限なく増やさず、情報を読み出す関数の表現力を高めることが狙いです。
1. 論文の基本情報と対象バージョン
論文名はSwitching Linear Attention、著者はHyun Dong Lee、Xavier Gonzalez、Nicolas Zucchet、E. Kelly Buchanan、Emily B. Fox、Scott W. Lindermanです。所属はStanford Universityと記載されています。Xavier Gonzalezについては、研究当時はStanfordに所属し、現在はUnconventional AIに在籍する旨の脚注があります。
本稿の対象は2026年9月30日公開のarXiv:2609.39034v1です。DOIは10.48550/arXiv.2609.39034で、原文PDFにはCOLM 2026の会議論文であることが明記されています。以下の数値と図表は、このv1に基づきます。
原文はCC BY 4.0で公開されています。掲載する図表の出典はLeeほか『Switching Linear Attention』(2026年)で、キャプションに原文の図表番号を示します。本解説の執筆者と、論文の研究者は別です。
2. なぜ読み出し方が重要なのか――履歴の保持と状態への圧縮
一般的なソフトマックスアテンションは、過去のトークンのキーとバリューをKVキャッシュに保存します。クエリと各キーの関係を計算して必要なバリューを組み合わせるため柔軟ですが、文脈が長くなるほどキャッシュも増えます。
線形アテンションは、過去の情報を固定サイズの状態行列に蓄積します。毎回履歴全体を開く代わりに、要約した台帳から答えを読み出すイメージです。ただし、クエリとバリューを一つの線形変換で結び付ける方式では、文脈ごとに異なる対応関係の表現に限界があります。
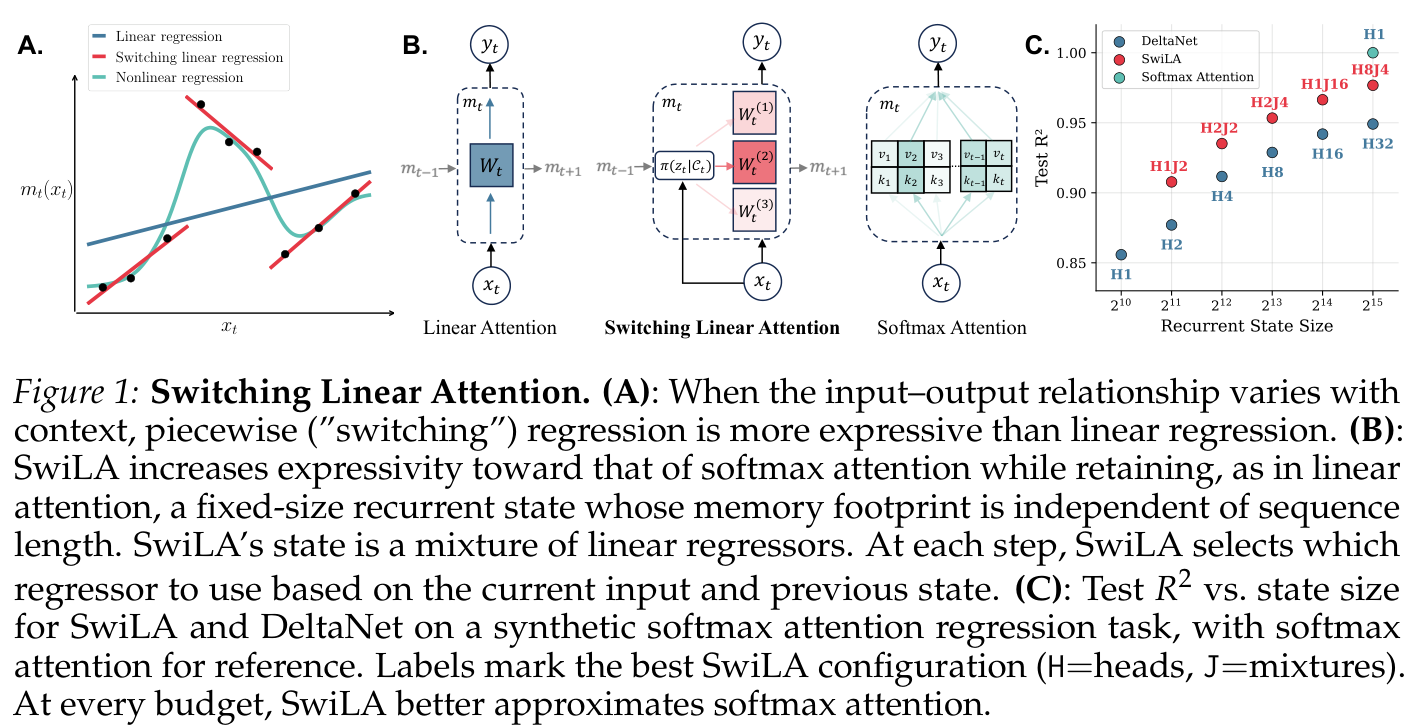
例えばHarryという名前から読み出すべき情報は、音楽家を扱う段落と、物語の魔法使いを扱う段落とでは異なります。SwiLAは、同じ手掛かりが文脈によって別の値を指す状況に、複数の回帰モデルの混合で対応します。
3. 中心となる考え方――複数の回帰モデルによる記憶
研究者らは、記憶への書き込みをキーからバリューへの関数を学習する回帰問題、検索をその関数にクエリを入力する処理として捉えています。これがテスト時回帰(TTR)です。トークンを読むたびに変わるのは文脈内の高速重みの状態であり、言語モデル全体を毎回再学習するわけではありません。
DeltaNetの基本的な読み出しは、一つの状態行列Wにクエリqを掛ける形です。SwiLAでは状態をJ個の線形回帰成分に分け、出力次元ごとに混合比率を設定します。複数の専門的な台帳を用意し、問いに応じて各台帳の寄与を変える仕組みに相当します。
出力は、各成分の予測にクエリ側の混合重みを掛けて足し合わせます。したがって、Switchingという名称でも、常に一つのエキスパートだけを選ぶハードルーティングを意味するわけではありません。入力によって混合比率が変わるため、検索関数全体は単一の線形変換より豊かな表現を持ちます。
出力次元をDとすると、成分選択の組合せはJ^D通りになりますが、実際に保存する重みの規模はJ×D²です。組合せの数と記憶容量は区別する必要があります。固定サイズの状態に過去の情報をすべて損失なく保存できるという主張ではありません。
4. 一つのトークンを処理する流れ――予測誤差による更新配分
まず、入力トークンからクエリ、キー、バリューと混合比率を計算します。次に、各回帰成分が既存の状態を使って現在のキーに対応するバリューを予測し、実際のバリューとの差、すなわち予測誤差を求めます。
続いて、入力から得た事前の比率と各成分の予測誤差を組み合わせ、負担率(responsibility)を計算します。同じ入力でも、記憶に何が保存されているかによって負担率が変わり得ます。この点が、入力だけで配分するルーターとの違いです。
各成分の高速重みは、学習率×負担率×予測誤差×キーに比例する量で更新します。その後、更新済みの各成分にクエリを適用し、クエリ側の比率で合算して出力を得ます。この流れは、線形回帰混合モデルに対するオンラインEMから導かれています。
EMは潜在的な成分への所属確率を推定してモデルを更新する枠組みです。本論文の実装では、トークンごとに収束まで長い最適化を繰り返すのではなく、高速重みに対する一段階の確率的勾配更新で漸化式を構成しています。
5. 文脈の持続と忘却――Temporal SwiLAとGated SwiLA
Temporal SwiLAは、文脈が連続するトークンにわたって持続することを考慮します。前時点の成分確率分布と現在の入力から得た分布を混合し、次の時点へ引き継ぎます。これは隠れマルコフモデルのフィルタリングを計算しやすく近似した構成で、段落内で文脈の手掛かりが繰り返されなくても成分の選択傾向を保てます。
Gated SwiLAは、入力に応じて古い状態を減衰させる忘却ゲートを備えます。論文では負担率の計算前に減衰させる式と計算後に減衰させる式を区別し、実際のGated SwiLAでは減衰後の状態から予測誤差と負担率を計算する式を採用しています。
成分を増やしても、一部に更新が集中すると残りは使われません。研究者らは、成分全体の利用の均衡とトークンごとの専門化を促す補助損失を導入しています。入力依存のノイズも提案していますが、374M言語モデルの主要実験ではルーターと時間ゲートのノイズを無効にしています。すべての提案手法をすべての実験で併用しているわけではありません。
6. 合成課題での効果――同じキーが文脈ごとに異なる値を指す場合
ソフトマックス近似実験では、次元32、長さ512の合成系列を用い、学習系列65,536件、テスト系列2,048件で評価します。同じ再帰状態の予算でDeltaNetと比較すると、各予算で最良のSwiLA構成のテストR²が高くなりました。特定の合成入力と構成探索の結果であり、あらゆる入力で同等の近似精度を保証するものではありません。
文脈依存の連想再生課題(CDAR)では、四つの文脈それぞれに32組のキー・バリュー、合計128個の対応を提示します。同じキーでも文脈ごとに値が変わり、文脈トークンも繰り返し出現しないため、対応関係と現在の文脈の両方を保持する必要があります。系列長は1,024です。
Figure 2Aでは、ヘッド数1、次元32、混合成分数4のTemporal SwiLAが、ほぼ完全な正解率に達する最小構成で、状態サイズは4,096です。ただしグラフは学習率と乱数シードの探索で得た最高正解率を示します。平均的な学習の安定性や実サービスの成功率として読むことはできません。
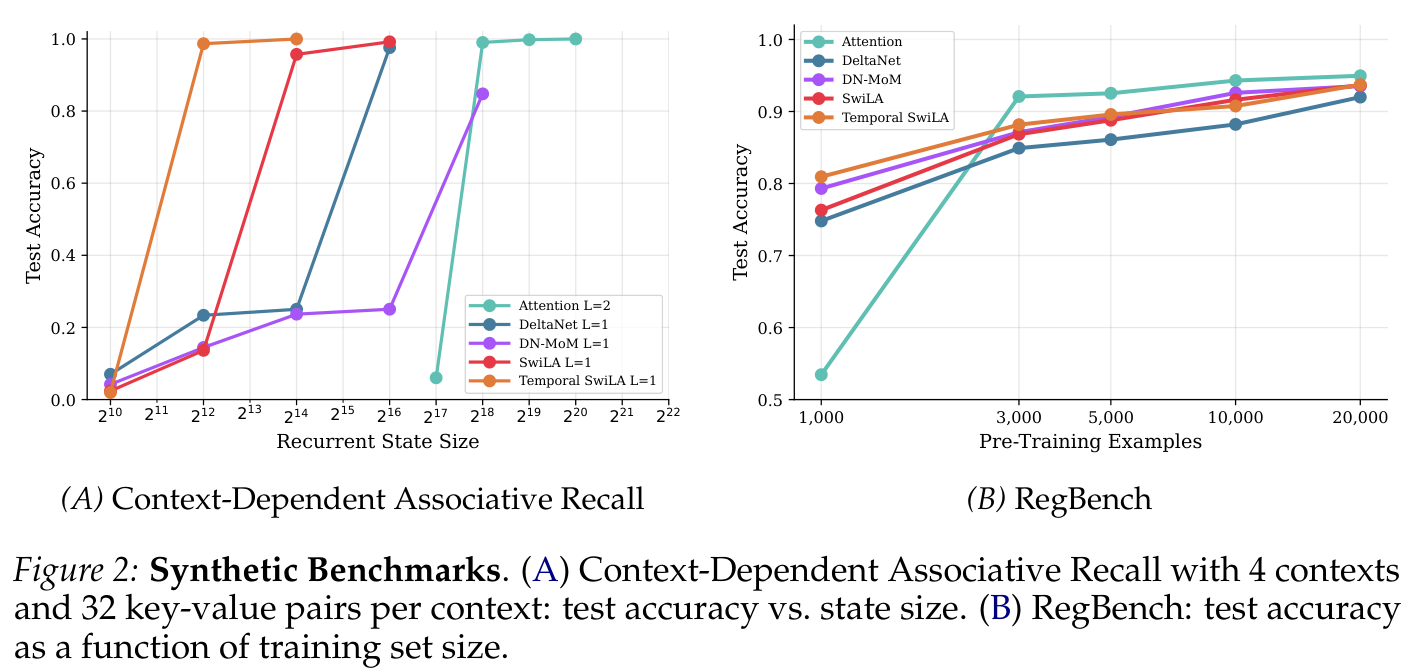
RegBenchは、ランダムな確率的有限オートマトンが生成した文字列の例から、次トークン分布を文脈内で学習する課題です。8層のモデルを比較し、再帰モデルの各層の状態サイズを16,384に揃えています。学習データが少ない領域ではTemporal SwiLAとDN-MoMが強い一方、データが増えるとTransformerが最高正解率に達します。全データ規模でSwiLAが上回る結果ではありません。
7. 言語モデルの結果――モデル規模と学習条件を揃えた比較
主要実験は、約3億7,400万(374M)パラメータ、24層、隠れ次元1,024のモデルを、FineWeb-Eduの約150億(15B)トークンで学習するものです。学習系列長は4,096、GPUはH100を8基使用します。総パラメータ数を揃えるため、フィードフォワード層の中間次元をモデルごとに少し調整しています。
SwiLA系は8ヘッド、ヘッド当たり4成分、キーとバリューの次元64で、各層の主要な再帰状態は131,072個のスカラーです。DeltaNet、GDN、KDAも同じ主要状態数に揃えています。ただし、主要状態のサイズが同じでも、実行時の総メモリや計算量まで同じとは限りません。
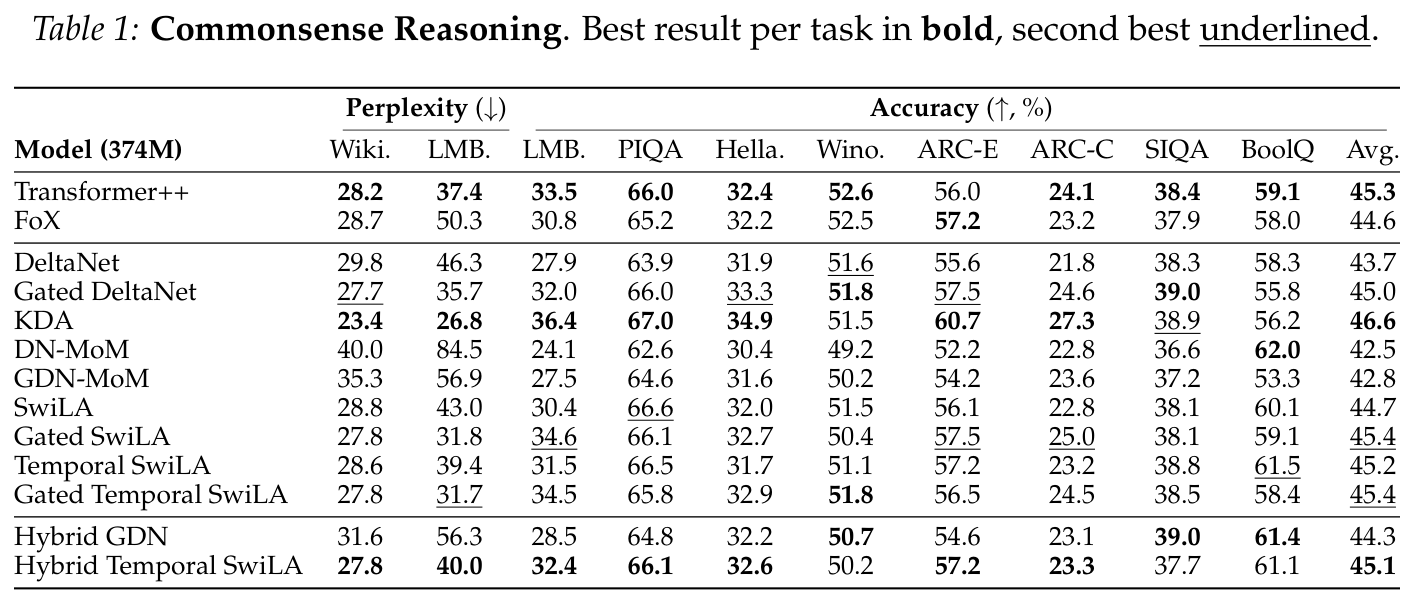
常識推論の平均正解率はTransformer++が45.3%、DeltaNetが43.7%、Gated DeltaNetが45.0%、KDAが46.6%です。SwiLAは44.7%、Gated SwiLAとGated Temporal SwiLAはそれぞれ45.4%です。ゲート付き変種はTransformer++を0.1ポイント上回りますが、KDAの方が高くなっています。この小差を統計的に確定した優位性や、より大規模なモデル一般の優位性に広げる根拠は示されていません。
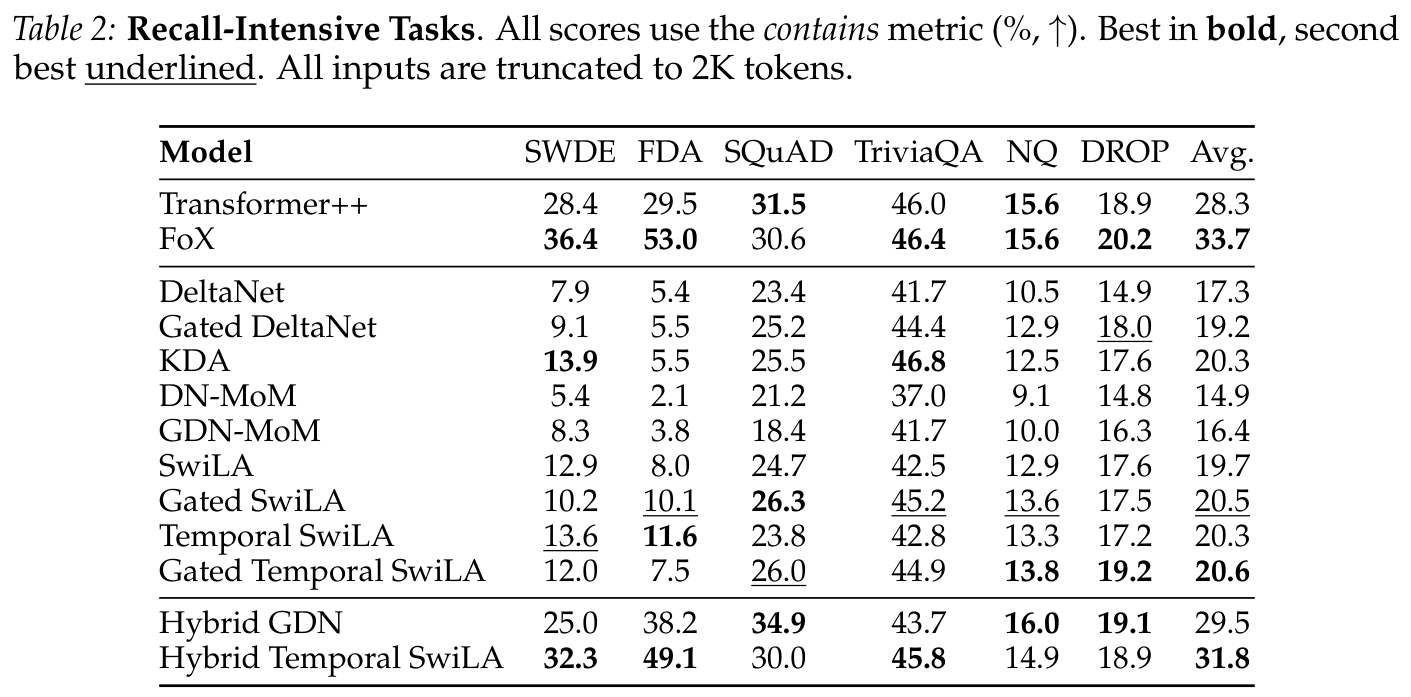
情報再生課題の平均はDeltaNetが17.3%、Gated DeltaNetが19.2%、KDAが20.3%、Gated Temporal SwiLAが20.6%です。Transformer++は28.3%、FoXは33.7%で、なお大きな差があります。固定状態内で再生性能を改善したことと、全KVキャッシュを保持するモデルを完全に代替したことは別です。
再帰層3層に対してソフトマックスアテンション層1層を配置するHybrid Temporal SwiLAは31.8%で、Hybrid GDNの29.5%、Transformer++の28.3%を上回ります。ただし、全アテンション層にはKVキャッシュが残ります。純粋なSwiLAの固定状態という性質を、ハイブリッドモデル全体に当てはめることはできません。
8. 高速化の条件――学習速度と推論スループットは別の指標
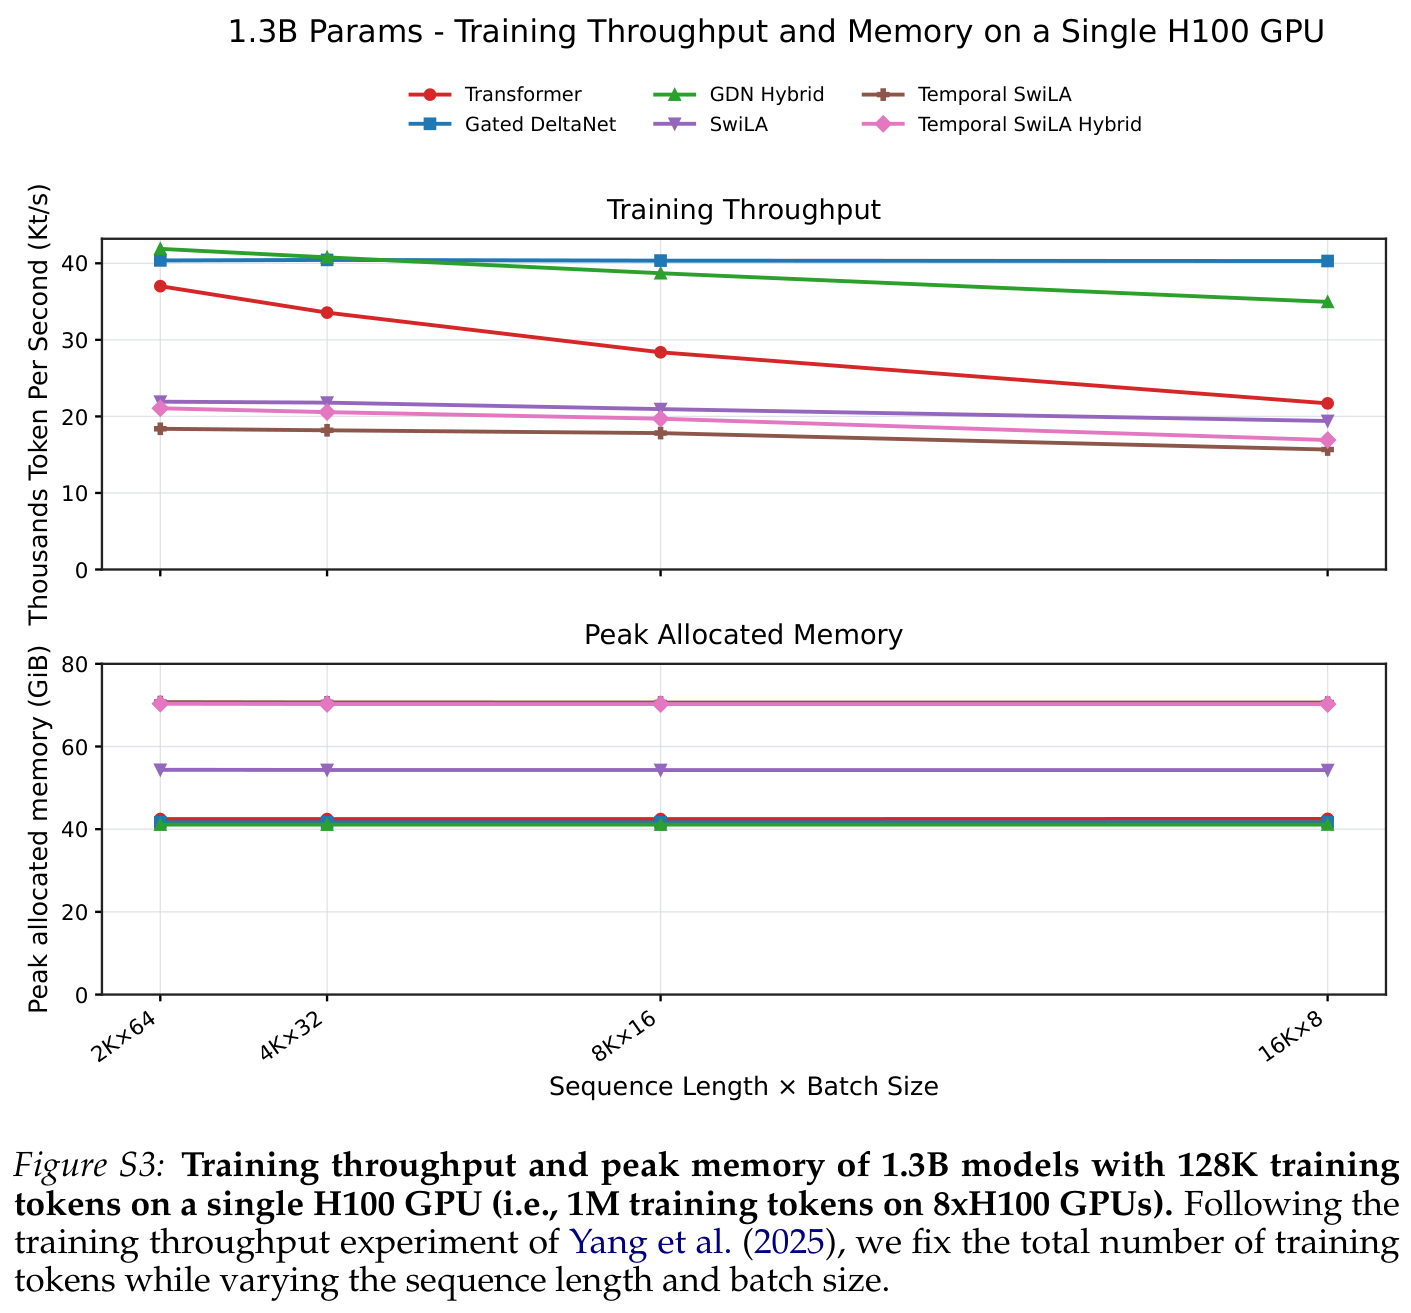
スループット実験は精度評価とは異なり、13億(1.3B)パラメータのモデルをH100一基で測定します。学習系列長2K、4K、8K、16Kに対してバッチサイズを64、32、16、8とし、更新当たりのトークン数を131,072に固定します。順伝播だけでなく、逆伝播、勾配クリッピング、AdamW更新まで計測に含めます。
推論では2,048トークンの合成プロンプトから貪欲復号で128トークンを生成し、バッチサイズを1から128まで増やします。プリフィルとデコードを含む生成全体の時間を測定し、メモリ不足が発生した構成およびそれより大きいバッチは完了測定の対象から除きます。
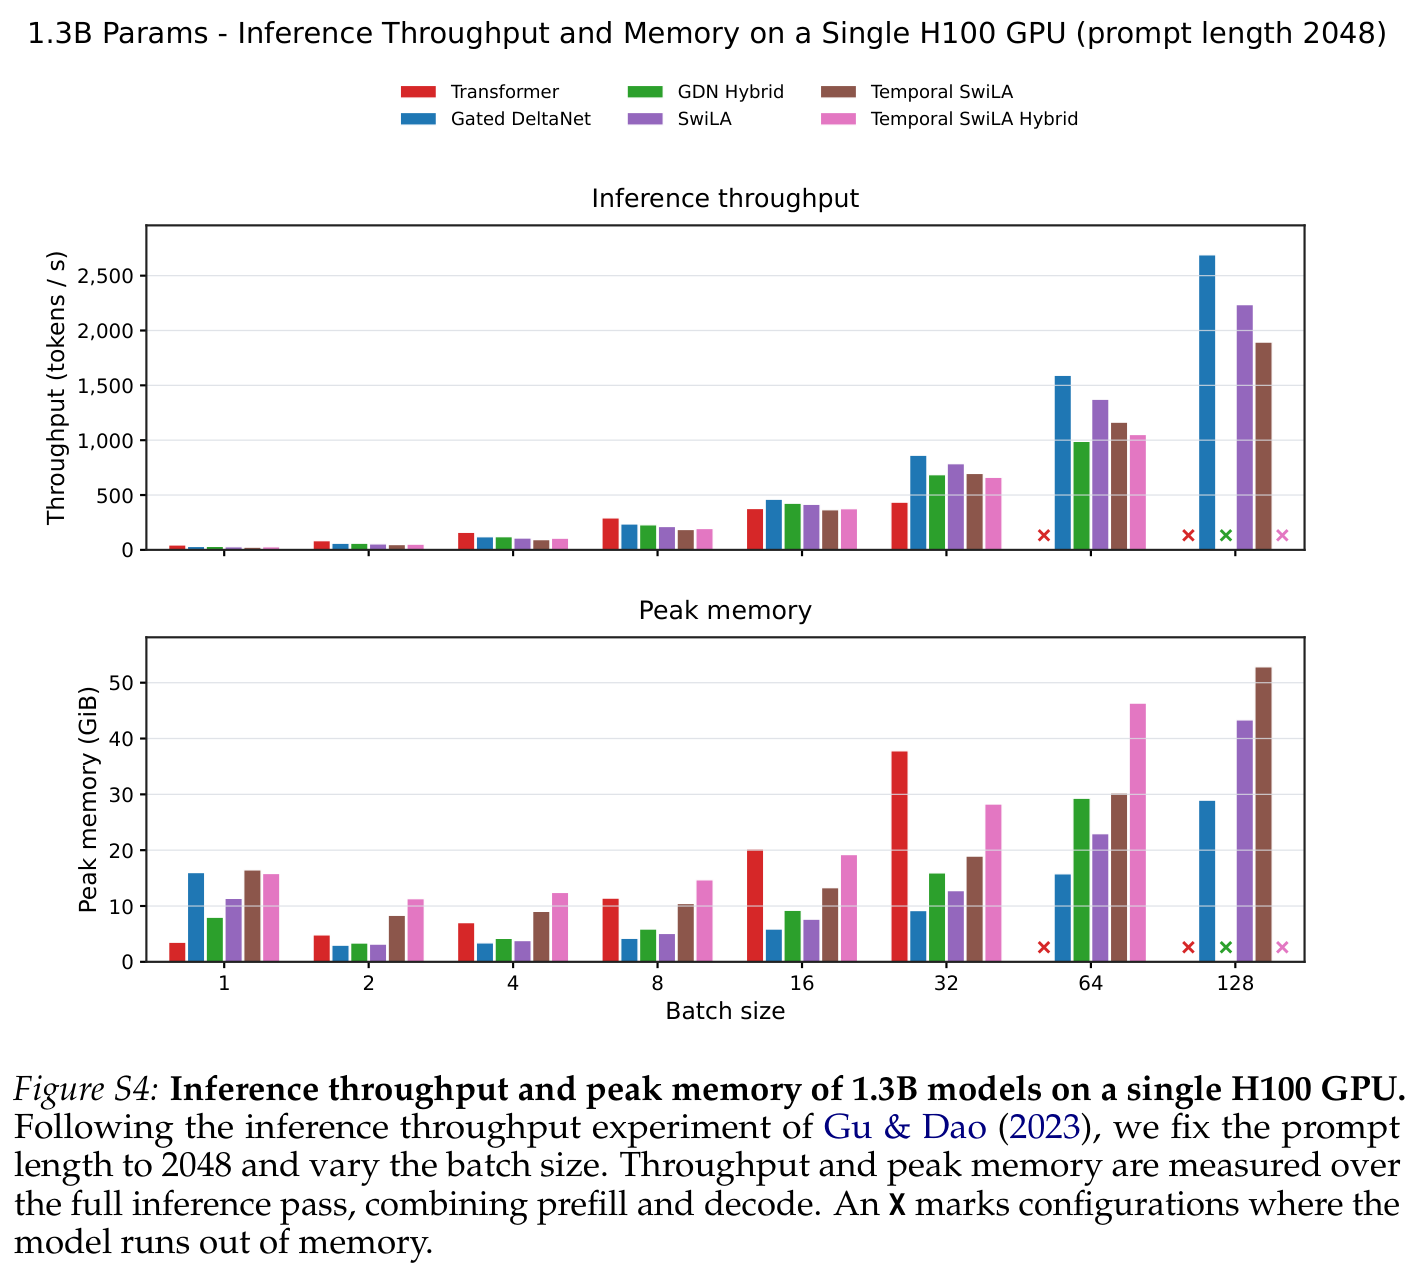
研究者らは、Transformerに対する推論全体のスループットが4〜5倍になったと報告しています。KVキャッシュを持たず、より大きなバッチを扱える効果を含む結果です。全バッチで4〜5倍速い、あるいは一人の利用者への応答が同じ比率で速くなるという意味ではありません。一方、GDNに比べると学習は約2倍、推論は約1.25〜1.5倍遅く、メモリ使用量も多くなります。
9. 残る限界と適用条件
第一に、記憶容量は固定されたままです。文脈が長くなっても容量は増えず、情報間の干渉や容量制約は解消されません。とくに原文の再生評価は入力を2Kトークンに制限しており、この結果だけで超長文書における精度を判断することは困難です。
第二に、既存の状態によって負担率が変わる非線形な再帰は、学習の並列化を難しくします。実験では高速な逐次実行のTritonカーネルを使用しています。付録にはニュートン反復やチャンク単位の並列化が提案されていますが、それが主要実験ですでに学習速度の問題を解消したとはいえません。
第三に、エキスパートを増やすだけでは性能は向上しません。別途行った115Mパラメータ・5Bトークンのアブレーションでは、同じ状態予算で成分数を4から16に増やすと各成分の射影次元が小さくなり、性能がやや低下しました。成分数と一成分当たりの表現容量の均衡が必要です。
第四に、基本形のSwiLAにはエキスパート崩壊の問題があります。アブレーションでは、補助損失を加えるとテストパープレキシティが36.769から16.807に低下しました。Temporal SwiLAではそれぞれ16.718と16.715で差は小さくなっています。これらは別のアブレーションの結果であり、主要な374M実験と混同して比較してはいけません。
10. 弁理士の視点から捉える技術的相違
技術的課題は、限られた再帰状態の中で、文脈によって異なるキー・バリューの対応をより正確に保持して読み出すことです。解決手段は、線形回帰成分の混合、出力次元ごとの重み、既存状態の予測誤差を反映した負担率、その負担率に基づく状態更新の組合せとして整理できます。
入力だけに基づくメモリ選択と比べると、SwiLAは現在の記憶が入力をどの程度説明できるかを配分に反映します。Temporal構成は文脈の持続性、Gated構成は記憶の減衰を加えます。各構成の役割と結合関係を区別することが、技術の相違を正確に説明する上で重要です。
確認された効果は、一定の状態予算における合成課題の性能と、374M実験での情報再生の改善です。同時に、学習・推論コストの増大や全アテンションとの再生性能の差も残ります。筆者は、単なるメモリ分割よりも、更新則と検索関数を一貫した確率モデルの下で設計した点に意義があると考えます。これは技術構造の解説であり、特許性や侵害の成否を判断するものではありません。
11. まとめ
SwiLAは線形アテンションの固定サイズの記憶を維持しつつ、複数の回帰成分を文脈に応じて組み合わせることで検索の表現力を高めます。既存状態の予測誤差が次の更新配分に影響することと、文脈の持続性を明示的に扱うことが要点です。
実験は固定状態でも情報再生を改善できることを示していますが、履歴全体を保存するアテンションとの容量差と、逐次学習のコストは残ります。実際の採用に当たっては、必要な文脈長、再生精度、バッチスループット、学習コストを併せて評価する必要があります。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
IPLEXのAI技術・特許分析を見る
論文原文:Switching Linear Attention