
Статья и постановка задачи
Ali Hatamizadeh, Yejin Choi и Jan Kautz предложили Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention. Разбор относится к arXiv:2605.22791v1, поданному 21 мая 2026 года; на PDF указано 22 мая. Это препринт, а не утверждение о журнальной публикации. Статья доступна по CC BY 4.0; воспроизведённые схема, таблицы и график принадлежат указанным авторам и NVIDIA.
Главный вопрос — как исправлять сжатую память, не нарушая другие связи. Предлагается точнее управлять обновлением, а не просто увеличивать объём памяти. Ниже результаты авторов отделены от нашей технической интерпретации и выводов для патентной практики.
От растущего кэша к фиксированному состоянию
Softmax-внимание обращается к предыдущим токенам напрямую, но KV-кэш растёт с длиной последовательности. Рекуррентное линейное внимание накапливает связи ключ–значение в матрице фиксированного размера. Ключ задаёт обращение к связи, значение несёт содержание, запрос считывает состояние. Экономия хранения сопровождается интерференцией: множество связей разделяет ограниченное пространство.
DeltaNet обновляет разность между новым значением и текущим считыванием. Gated DeltaNet добавляет обучаемое забывание, а Kimi Delta Attention (KDA) делает затухание поканальным. Однако единый скаляр beta по-прежнему связывает интенсивность стирания старого содержания и записи нового.
Независимое управление по двум осям
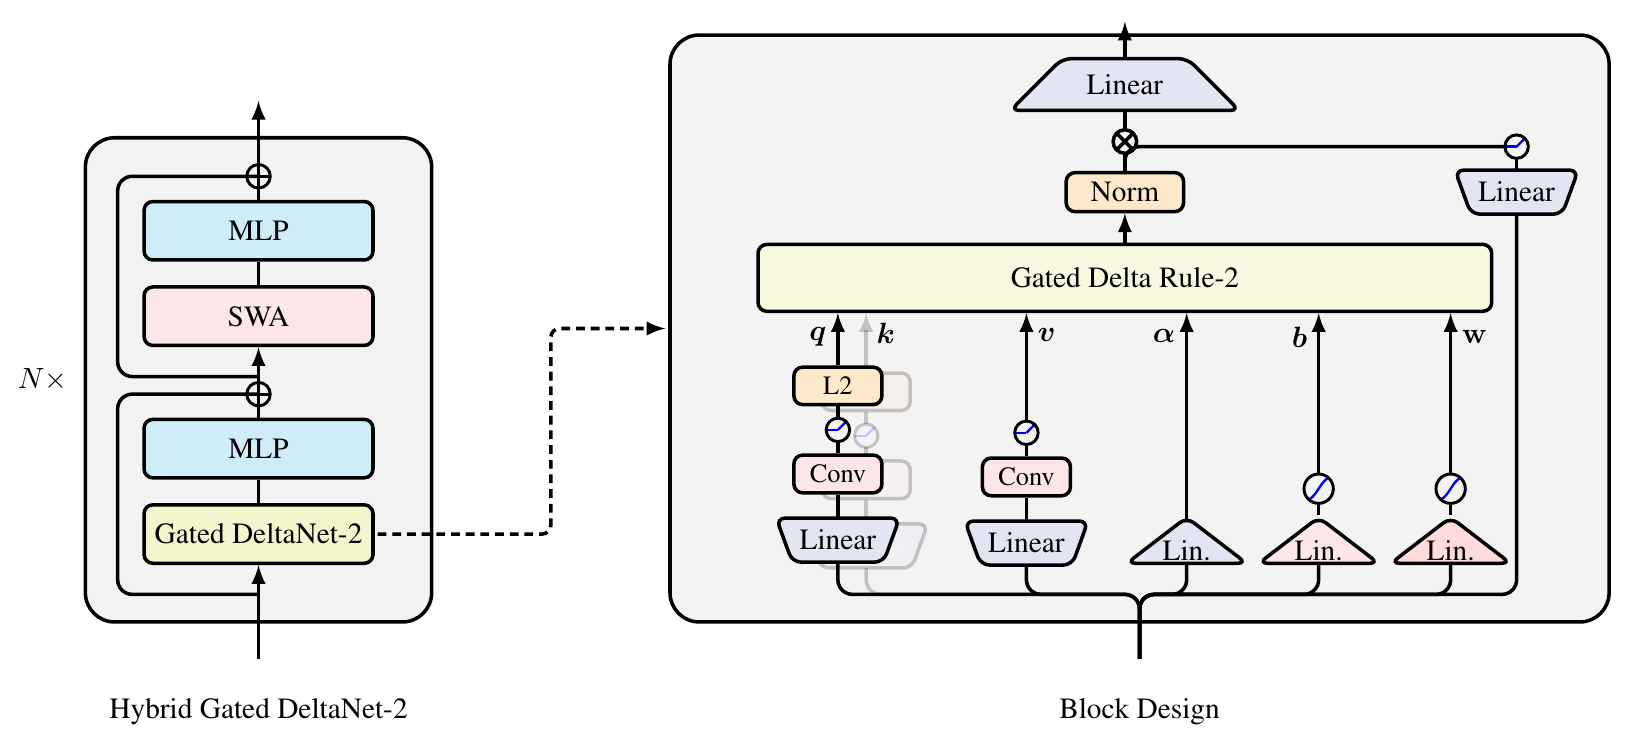
Gated DeltaNet-2 сохраняет поканальное затухание alpha, но независимыми линейными проекциями и сигмоидами формирует зависящие от входа вентили стирания b и записи w. Первый действует на каналы ключа, второй — значения: e = b ⊙ k, z = w ⊙ v.
После затухания Sbar = D Sprevious считывается r = Sbarᵀe и выполняется S = Sbar + k(z − r)ᵀ. Запрос читает обновлённое состояние. Если оба вентиля свести к одному скаляру beta, получается KDA; если сделать скалярным и затухание — Gated DeltaNet. Отличие определяется связью осей и членов обновления, а не самим количеством вентилей.
Обработка токена и параллельное обучение
Запрос и ключ проходят линейную проекцию, короткую причинную свёртку, SiLU и L2-нормализацию; значение — проекцию, свёртку и SiLU. Выход рекуррентного оператора обрабатывается RMS-нормализацией, отдельным выходным вентилем и проекцией. Выходной вентиль не следует смешивать с вентилем записи.
Для обучения используется блочная WY-форма с блоками по 64 токена. Накопленное поканальное затухание включается в асимметричные множители стирания, сохраняя внутри блока решение треугольных систем и плотные матричные произведения. При обратном проходе градиенты накапливаются с учётом уже модулированных ключей и значений: поканальные множители нельзя вынести подобно скаляру beta. Существенны вычисление затухания в FP32 и точность состояния и решения систем.
Условия сравнения
Основные эксперименты выполнены для моделей с 1,3 млрд параметров на 100 млрд токенов FineWeb-Edu при длине обучения 4K. Сравнивались Mamba-2, Gated DeltaNet, KDA и варианты Mamba-3 SISO/MIMO. Рекуррентные и гибридные семейства оценивались отдельно; гибрид добавляет внимание со скользящим окном 2K.
При 16 головах и размерностях ключа и значения 128×128 состояние содержит 262 144 значения на слой и элемент пакета. Это не общий объём памяти модели. Гибрид дополнительно хранит ограниченный локальный кэш, сочетая сжатую дальнюю историю с более точными локальными взаимодействиями.
Языковые задачи и рассуждение
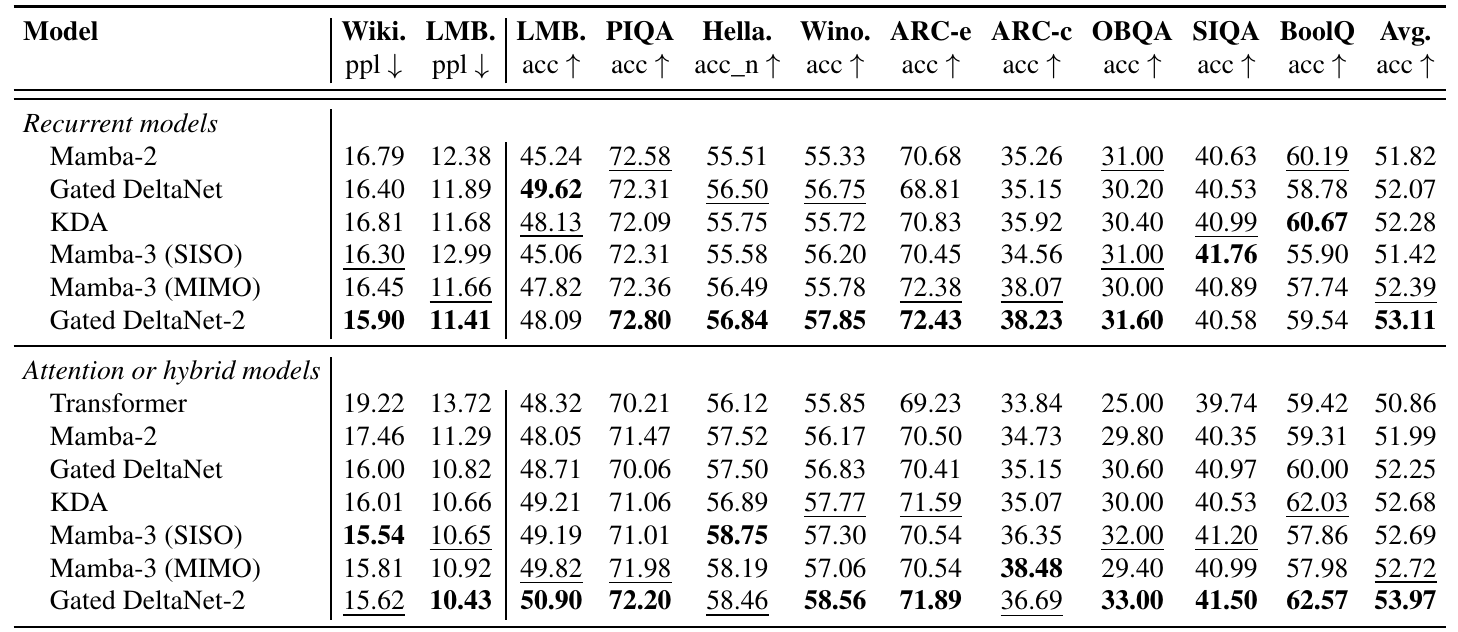
Среднее в таблице 2 включает точность LAMBADA и перечисленных задач на здравый смысл. Рекуррентная модель получила 53,11 против 52,28 у KDA и 52,07 у Gated DeltaNet. Гибридная — 53,97 против 52,68 и 52,25. Преимущество над KDA составляет 0,83 и 1,29 процентного пункта в условиях этого опыта.
Лидерство по среднему не означает победу во всех задачах. Рекуррентная точность LAMBADA равна 48,09 против 49,62 у Gated DeltaNet. Перплексия WikiText у гибрида — 15,62, тогда как Mamba-3 SISO даёт 15,54; здесь меньшее значение лучше.
Извлечение информации: улучшение не устраняет ошибки
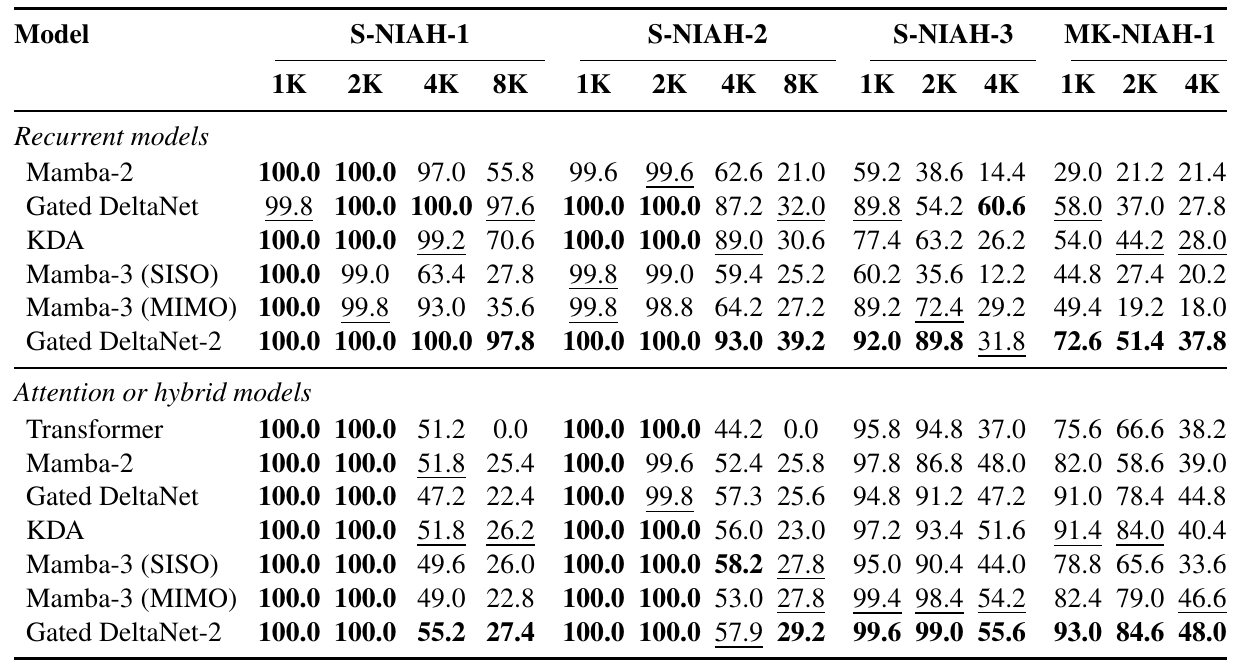
На MK-NIAH-1 из RULER при 4K рекуррентная модель достигает 37,8%, KDA — 28,0%, Gated DeltaNet — 27,8%. Гибрид достигает 48,0% против 40,4% у KDA. Прибавка 9,8 пункта у рекуррентной модели указывает на снижение интерференции, но 37,8% далеко от надёжного извлечения. Её S-NIAH-3 падает с 89,8% при 2K до 31,8% при 4K; Gated DeltaNet при 4K даёт 60,6%.
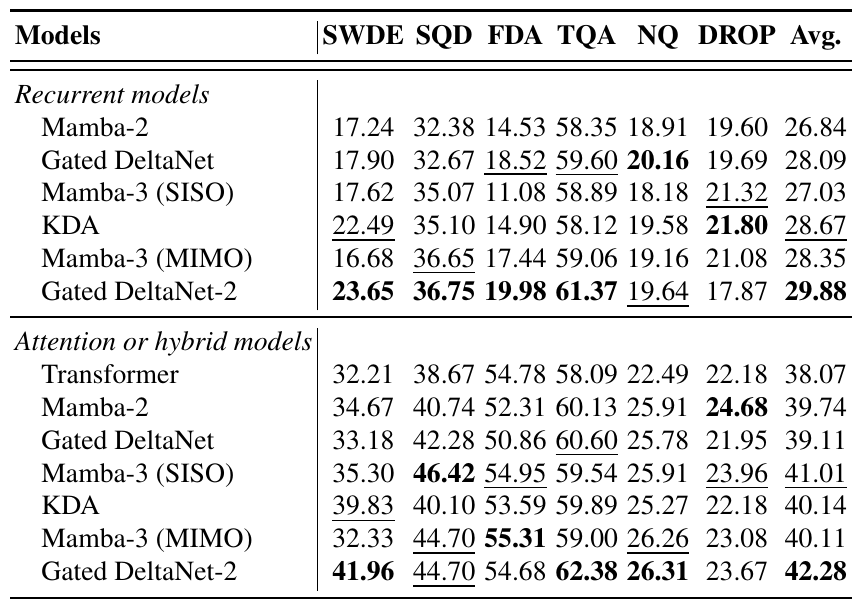
В таблице 4 рассматриваются извлечение из HTML в SWDE, пары ключ–значение из PDF в FDA, SQuAD, TriviaQA, Natural Questions и DROP, причём вход обрезан до 2K токенов. Средние: 29,88 против 28,67 у KDA для рекуррентных моделей и 42,28 против 40,14 для гибридных. На DROP рекуррентная модель уступает KDA: 17,87 против 21,80. Это не проверка точного поиска в документах на сотни тысяч токенов.
Абляции и скорость обучения
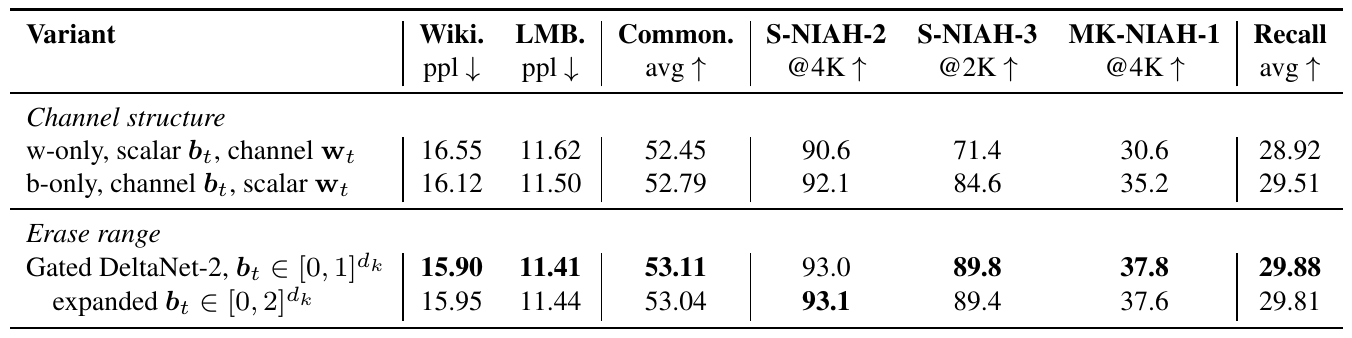
В абляциях веса проекций сохранялись, а один вентиль усреднялся по каналам во время исполнения: число параметров оставалось прежним. На MK-NIAH-1 при 4K только поканальная запись даёт 30,6, только поканальное стирание — 35,2, оба — 37,8. Расширение диапазона стирания с [0,1] до [0,2] даёт 37,6 без устойчивой дополнительной выгоды. Оба механизма вносят вклад, но сохранение лишь поканального стирания возвращает большую часть улучшения.
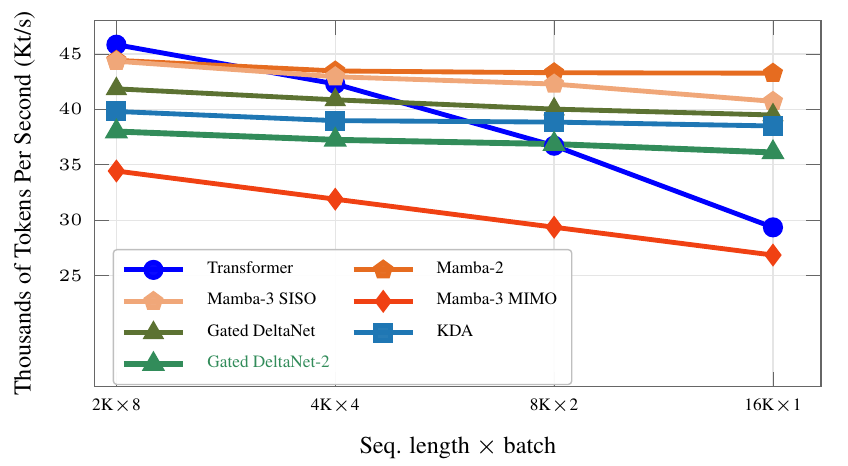
Рисунок 2 показывает обучение гибридных моделей с 1,3 млрд параметров на одной H100 при фиксированном бюджете токенов. Скорость Gated DeltaNet-2 меняется с 38,0 тыс. токенов/с при 2K×8 до 36,1 при 16K×1. KDA немного быстрее. Более точное управление требует дополнительных вычислений; результат нельзя переносить напрямую на задержку инференса или стоимость внедрения.
Границы доказательств
Архитектура может быть полезна для накопления длинной истории в ограниченном состоянии и разделения близкого и далёкого контекста. Это вывод из устройства модели. Статья не проверяет анализ корейских патентных описаний, поиск юридических документов или конкретный промышленный сервис.
Основные результаты относятся к 1,3 млрд параметров и 100 млрд обучающих токенов. Другие масштабы, языки и более длинные реальные контексты требуют проверки. В таблицах нет разброса между повторными обучениями и доверительных интервалов. Фиксированное состояние остаётся ограниченным по информационной ёмкости; точное редактирование не превращает его в хранение без потерь.
Взгляд патентной практики
Конкретная задача — интерференция множества связей в сжатом рекуррентном состоянии и ограничение, создаваемое общим скаляром для стирания по оси ключа и записи по оси значения. Решение объединяет поканальное затухание и независимые вентили в одном дельта-обновлении. Отличие от KDA связано также с асимметричной параллельной формой и соответствующим накоплением градиентов.
В техническом описании следует совместно раскрывать оси, промежуточные величины, их роль в обновлении и соответствующие вычисления обучения. Эффекты необходимо привязывать к одинаковому размеру состояния, абляциям и условиям H100, включая слабые результаты отдельных задач и накладные расходы. Это технический анализ, а не заключение о патентоспособности.
Что даёт такой подход
Gated DeltaNet-2 позволяет избирательнее редактировать фиксированную память: стирание и запись обучаются независимо, а их разделение сохраняется в рекуррентном обновлении и параллельном обучении.
Полезно рассматривать вместе проблему интерференции, согласованное обновление и измеренные эффекты. Такая связь с учётом ограничений информативнее, чем представление отдельного лучшего результата как всеобщего превосходства.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Связанная практика: патенты в области ИИ
Статья Gated DeltaNet-2, версия 1 · CC BY 4.0