
论文研究什么问题
本文分析Ali Hatamizadeh、Yejin Choi、Jan Kautz的《Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention》。所依据的是arXiv:2605.22791v1,提交日期为2026年5月21日,PDF标注5月22日。该文为预印本,不据此宣称已在期刊发表。论文采用CC BY 4.0许可,转载的架构图、表格和吞吐量图归属于上述作者及NVIDIA。
核心问题是如何修改容量有限的压缩记忆,同时尽量不干扰已有的其他关联。改进点在于更有选择性的更新,而非单纯扩大记忆。下文区分论文报告的结果与我们从技术、专利实务角度作出的解读。
从增长的缓存到固定状态
Softmax注意力可直接访问历史词元,但KV缓存随序列增长。循环线性注意力则将键值关联累积到固定大小的矩阵中:键提供寻址线索,值承载内容,查询从状态中读取信息。这抑制了存储量增长,却会因多种关联共享有限空间而产生干扰。
DeltaNet根据新值与当前读取值之间的差更新记忆。Gated DeltaNet加入可学习的遗忘,Kimi Delta Attention(KDA)进一步按通道控制衰减。然而,擦除旧内容与写入新内容的强度仍由同一个标量beta控制。
在两个维度上独立控制
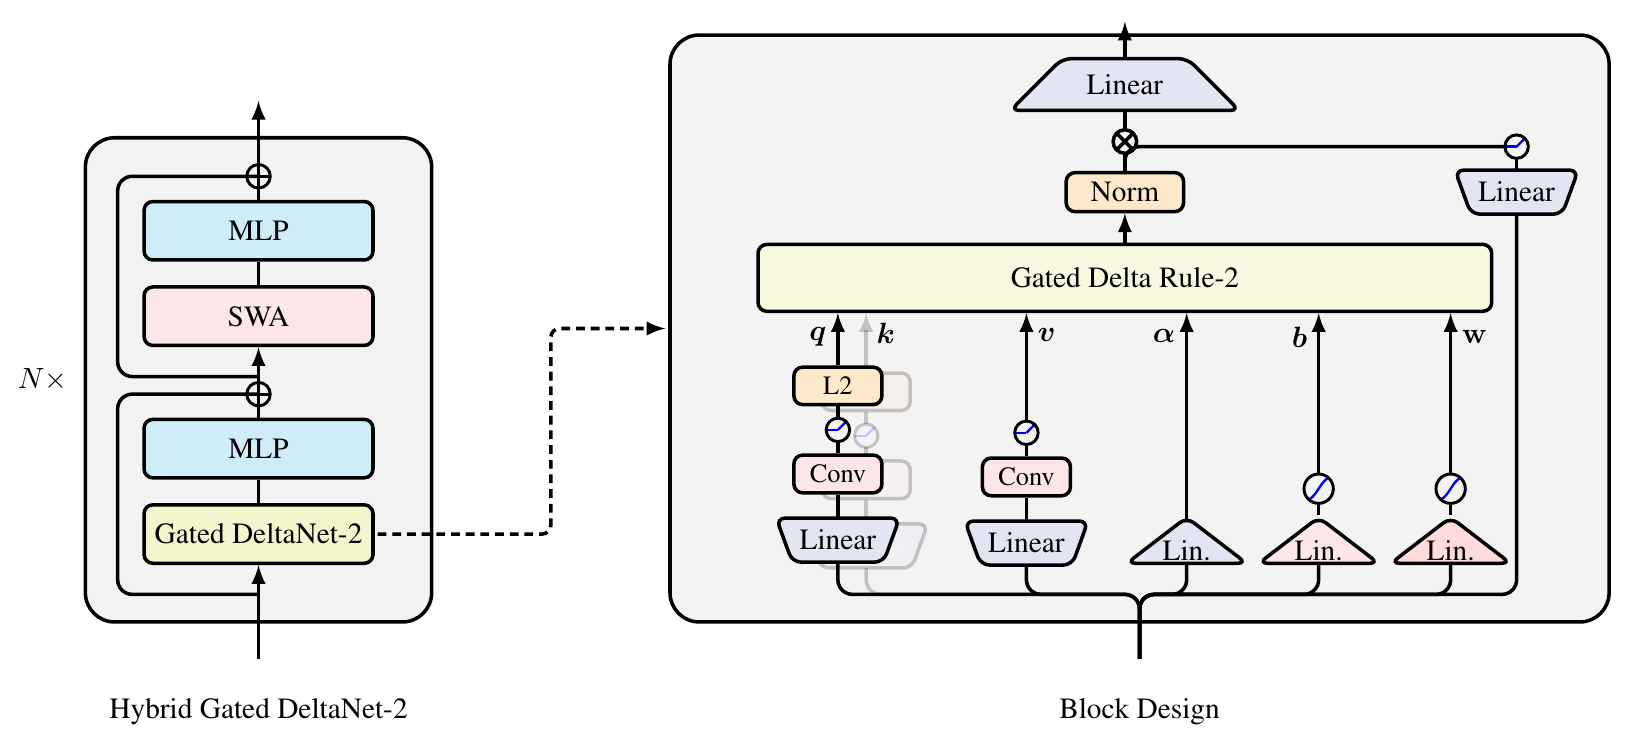
Gated DeltaNet-2保留逐通道衰减alpha,同时通过独立线性投影及sigmoid生成输入相关的擦除门b和写入门w。b作用于键通道,w作用于值通道,得到e = b ⊙ k和z = w ⊙ v。
先衰减得到Sbar = D Sprevious,再读取r = Sbarᵀe,按S = Sbar + k(z − r)ᵀ更新,查询使用更新后的状态。若两个门退化为同一标量beta,即回到KDA;若衰减也为标量,则回到Gated DeltaNet。技术差异在于作用维度及更新项的关系,而不只是多了两个门。
词元路径与并行训练
查询和键依次经过线性投影、短因果卷积、SiLU和L2归一化;值经过投影、卷积和SiLU。循环算子输出再经RMS归一化、独立输出门和投影。输出门并非写入门。
训练采用64词元分块的WY形式,将逐通道累积衰减吸收到非对称擦除因子中,在块内使用三角方程求解与稠密矩阵乘法。反向传播必须用已经门控的键和值累积梯度,不能像标量beta那样简单移到运算外。FP32衰减计算、状态与求解精度也是实现要点。
实验比较的边界
主要实验使用13亿参数模型、1000亿FineWeb-Edu训练词元和4K训练长度,对比Mamba-2、Gated DeltaNet、KDA以及Mamba-3的SISO、MIMO版本。循环与混合架构分别评估,混合架构另加窗口为2K的滑动窗口注意力。
在16个头、键和值各128维的设置下,每层、每个批次元素的循环状态含262,144个数值。这不是整个模型的总内存。混合模型还保留有界的局部注意力缓存,以压缩远处信息并更精确地处理局部关系。
语言建模与推理成绩
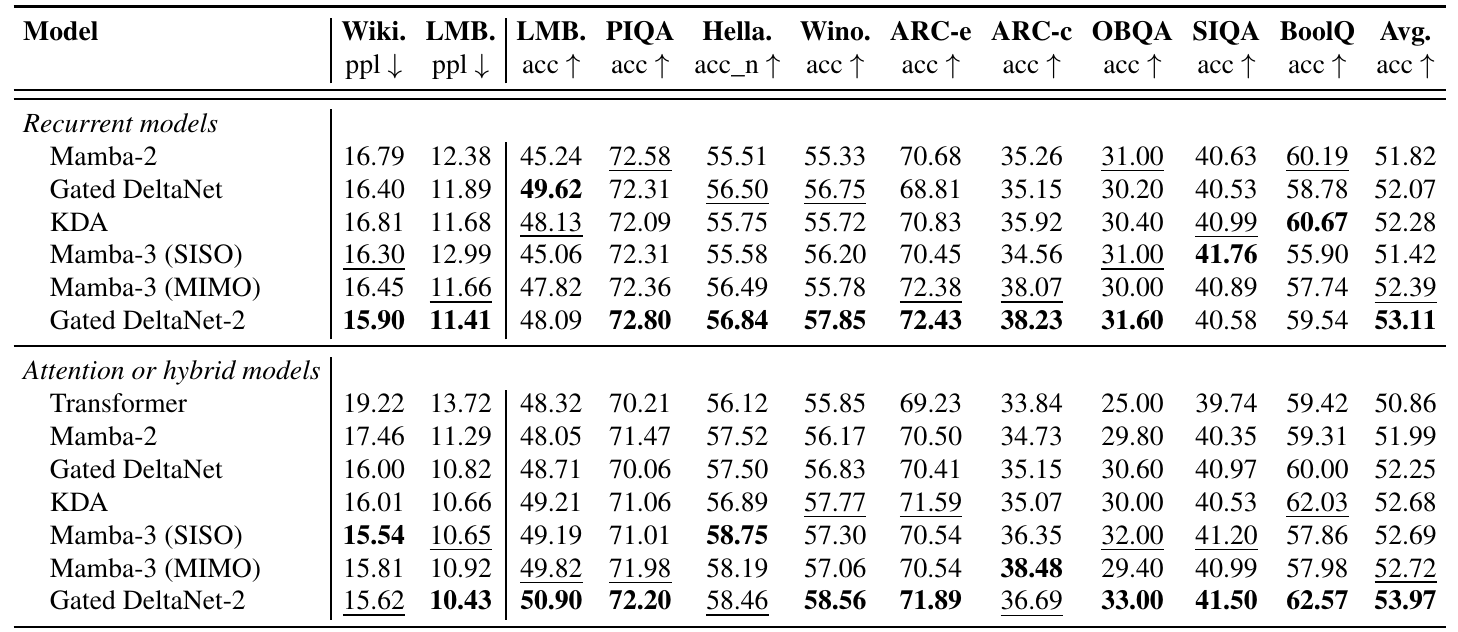
表2的平均值由LAMBADA准确率及所列常识推理任务构成。循环模型为53.11,KDA为52.28,Gated DeltaNet为52.07;混合模型为53.97,后二者分别为52.68和52.25。相对KDA提高0.83与1.29个百分点,结论限于该实验条件。
平均领先并不代表每项领先。循环模型LAMBADA准确率48.09,低于Gated DeltaNet的49.62。混合模型WikiText困惑度15.62,而Mamba-3 SISO为15.54,该指标越低越好。
检索改善仍伴随明显错误
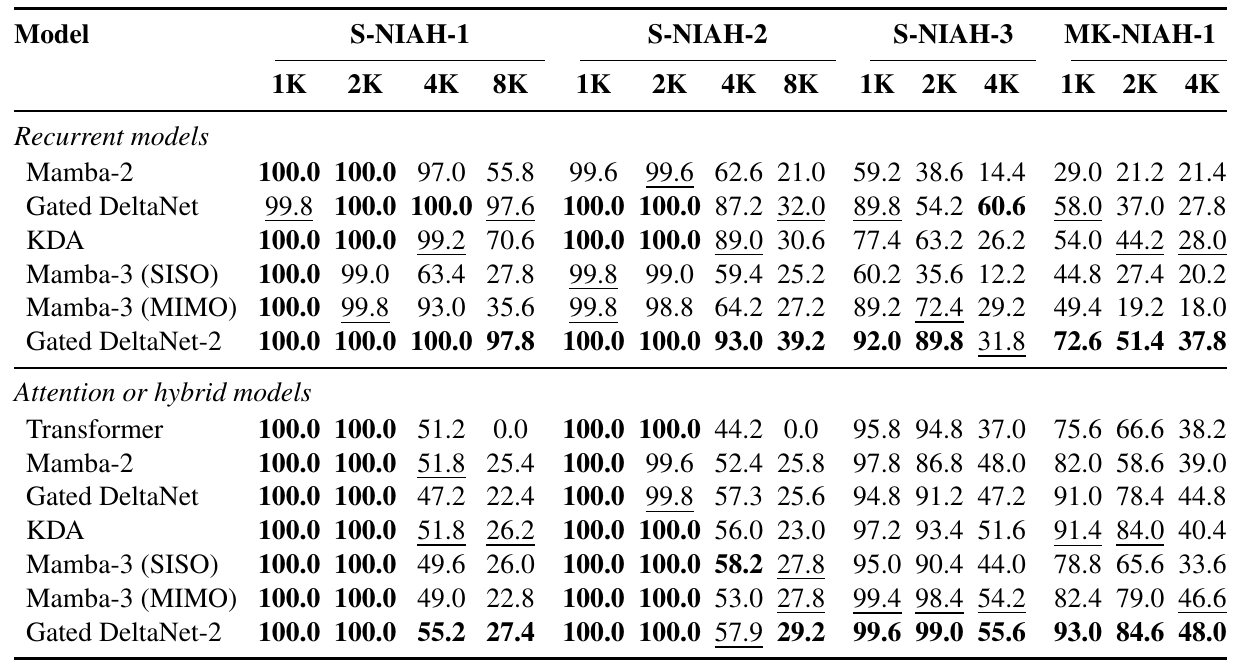
RULER的4K MK-NIAH-1任务中,循环模型准确率37.8%,KDA为28.0%,Gated DeltaNet为27.8%;混合模型为48.0%,KDA为40.4%。循环模型提升9.8个百分点,支持其减轻干扰的作用,但37.8%远非可靠检索。循环模型S-NIAH-3从2K的89.8%降至4K的31.8%,Gated DeltaNet在4K为60.6%。
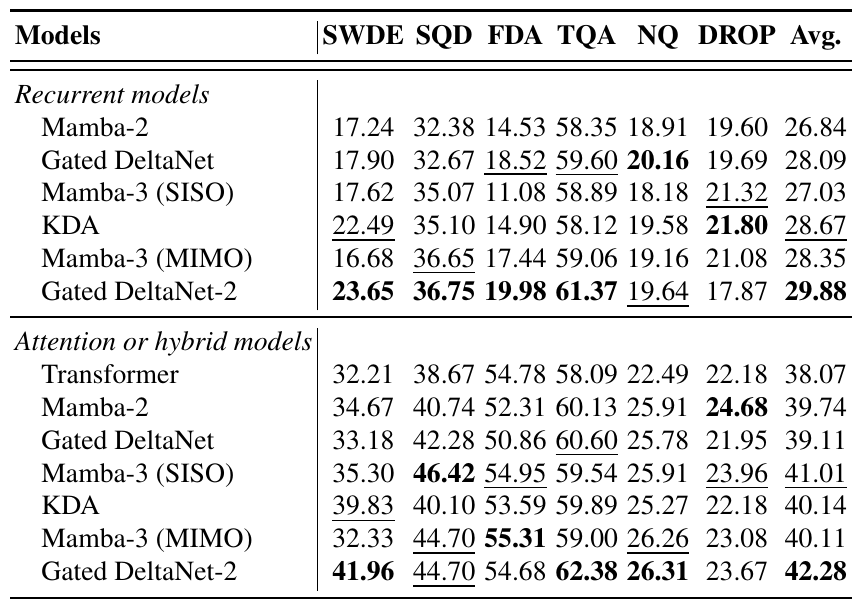
表4包括SWDE的HTML抽取、FDA的PDF键值抽取、SQuAD、TriviaQA、Natural Questions和DROP,输入均截断至2K。循环平均29.88,对比KDA的28.67;混合平均42.28,对比40.14。但循环模型DROP仅17.87,低于KDA的21.80。这并非对数十万词元文档高准确检索的验证。
消融实验与训练吞吐量
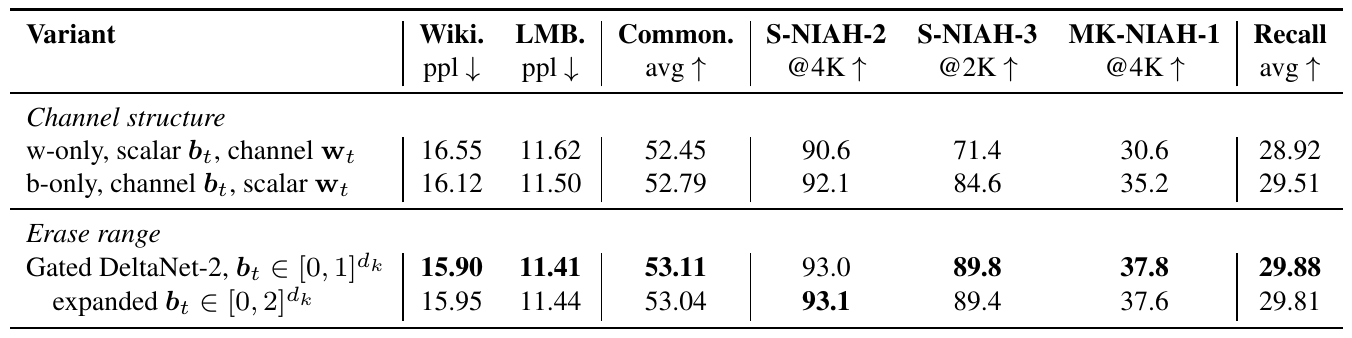
消融保留原投影参数,只在运行时将一个门沿通道求平均,因此参数量不变。4K MK-NIAH-1中,仅写入门逐通道得30.6,仅擦除门逐通道得35.2,两个门均逐通道得37.8。擦除范围由[0,1]扩至[0,2]时为37.6,没有一致的额外收益。两侧通道结构都有贡献,擦除侧单独保留时恢复了更多收益。
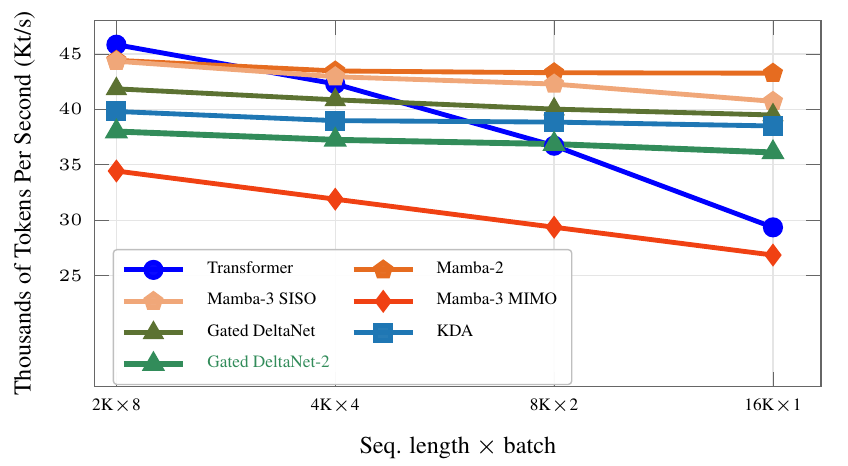
图2是在单张H100上、固定词元预算下测量13亿参数混合模型的训练吞吐量:从2K×8时每秒38.0千词元,到16K×1时36.1千词元。KDA略快,说明更精细的控制具有额外计算成本。不能将这一训练结果直接解释为推理延迟或部署费用的普遍优势。
哪些结论尚未验证
该结构可为有界状态下积累长历史、分开处理近邻与远程信息的系统提供参考,这是基于设计的推论。论文并未验证韩文专利说明书分析、法律文档检索或某个具体工业服务。
主要证据集中在13亿参数、1000亿训练词元的规模,更大模型、其他语言及更长真实上下文需另行测试。表中未给出重复训练波动或置信区间。固定状态仍有信息容量限制,精细编辑不会使它变成无损存储。
专利实务如何描述技术关系
具体问题是有限循环状态中的关联干扰,以及键侧擦除与值侧写入受同一标量约束。解决手段是在同一个delta更新中结合逐通道衰减、独立擦除门与写入门。区别于KDA的不仅是门结构,还包括对应的非对称并行计算和门控梯度累积。
技术文件应说明作用轴、中间量及其在状态更新中的角色,并交代与训练计算的对应关系。效果应联系相同状态规模下的指标、消融与H100条件,同时保留单项劣势和开销。此处属于技术分析,不等于认定论文已证明可专利性。
设计启示
Gated DeltaNet-2展示了更有选择性地修改固定记忆的方法:分别学习擦除与写入,并让这种分工贯穿循环更新和并行训练。
值得关注的是干扰问题、协调更新和实测效果之间的联系。将这些联系与限制共同理解,比用某个最高分证明全面优越更有价值。
图中保留原始标注与形态,相关内容在正文中说明。
Gated DeltaNet-2论文第一版 · CC BY 4.0