
El artículo y su pregunta
Ali Hatamizadeh, Yejin Choi y Jan Kautz presentan Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention. Este análisis se basa en arXiv:2605.22791v1, enviado el 21 de mayo de 2026; el PDF lleva fecha del 22 de mayo. Se trata de un preprint, sin afirmar su publicación en una revista. La licencia es CC BY 4.0; los diagramas, tablas y gráfico reproducidos se atribuyen a sus autores y a NVIDIA.
La pregunta es cómo modificar una memoria comprimida sin alterar otras asociaciones. La propuesta mejora la selectividad de la actualización, en lugar de limitarse a ampliar la memoria. Distinguimos los resultados comunicados por el artículo de nuestra interpretación técnica y de práctica de patentes.
De una caché creciente a un estado fijo
La atención softmax permite consultar tokens anteriores, pero su caché KV aumenta con la secuencia. La atención lineal recurrente acumula asociaciones clave–valor en una matriz de tamaño fijo: la clave identifica una asociación, el valor aporta contenido y la consulta lee el estado. Se reduce el crecimiento del almacenamiento, a costa de interferencias entre asociaciones que comparten un espacio limitado.
DeltaNet actualiza la diferencia entre el valor entrante y la lectura actual. Gated DeltaNet añade olvido aprendido; Kimi Delta Attention (KDA) introduce decaimiento por canal. Sin embargo, un único escalar beta sigue vinculando la intensidad del borrado con la de la escritura.
Decisiones independientes en dos ejes
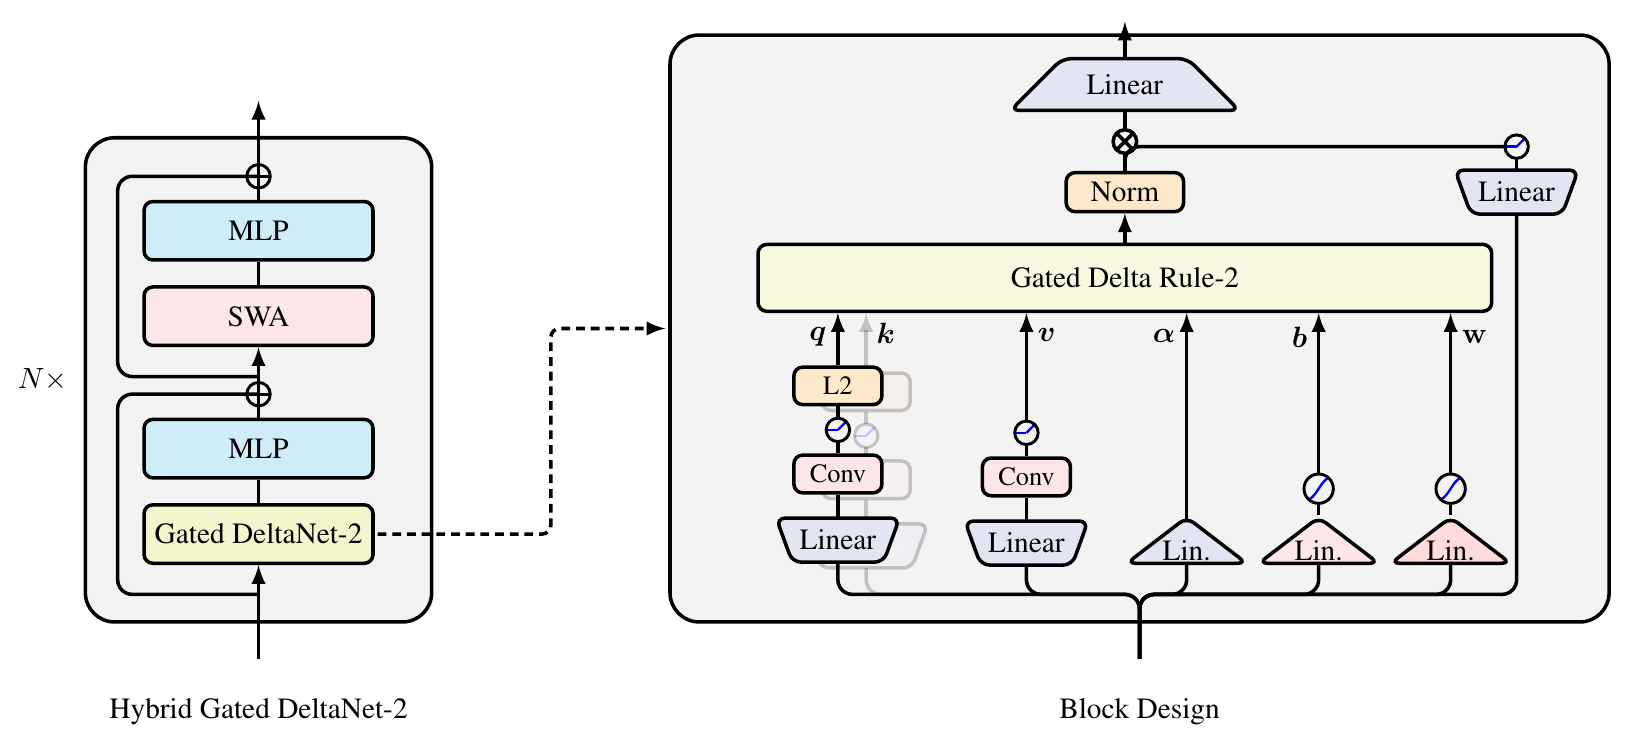
Gated DeltaNet-2 conserva el decaimiento alpha por canal y genera, mediante proyecciones lineales independientes y funciones sigmoides, una compuerta de borrado b y otra de escritura w dependientes de la entrada. La primera actúa sobre canales de claves y la segunda sobre canales de valores: e = b ⊙ k y z = w ⊙ v.
Tras el decaimiento Sbar = D Sprevious, se obtiene la lectura r = Sbarᵀe y se actualiza S = Sbar + k(z − r)ᵀ. La consulta utiliza el estado actualizado. Si ambas compuertas se igualan al mismo escalar beta se recupera KDA; si el decaimiento también es escalar, Gated DeltaNet. Lo distintivo es la relación entre ejes y términos de actualización, no solo el número de compuertas.
Procesamiento del token y entrenamiento paralelo
Consultas y claves pasan por proyección lineal, convolución causal corta, SiLU y normalización L2. Los valores pasan por proyección, convolución y SiLU. La salida recurrente recibe normalización RMS, una compuerta de salida independiente y una proyección. Esa compuerta de salida no es la de escritura.
El entrenamiento emplea una formulación WY por bloques de 64 tokens. El decaimiento acumulado por canal se incorpora a factores de borrado asimétricos, manteniendo resolución de sistemas triangulares y productos matriciales densos dentro de cada bloque. En la retropropagación deben intervenir claves y valores ya modulados: los factores por canal no se pueden extraer como un escalar beta. También importan el cálculo del decaimiento en FP32 y la precisión del estado y de la resolución.
Condiciones de comparación
Los experimentos principales utilizan modelos de 1.300 millones de parámetros, 100.000 millones de tokens FineWeb-Edu y longitud de entrenamiento de 4K. Se comparan Mamba-2, Gated DeltaNet, KDA y Mamba-3 SISO/MIMO. Las familias recurrente e híbrida se evalúan por separado; la híbrida añade atención de ventana deslizante de 2K.
Con 16 cabezas y dimensiones de estado de 128 por 128, hay 262.144 valores por capa y elemento del lote. No es la memoria total del modelo. La variante híbrida mantiene además una caché local acotada, combinando contexto distante comprimido con interacciones locales más precisas.
Lenguaje y razonamiento
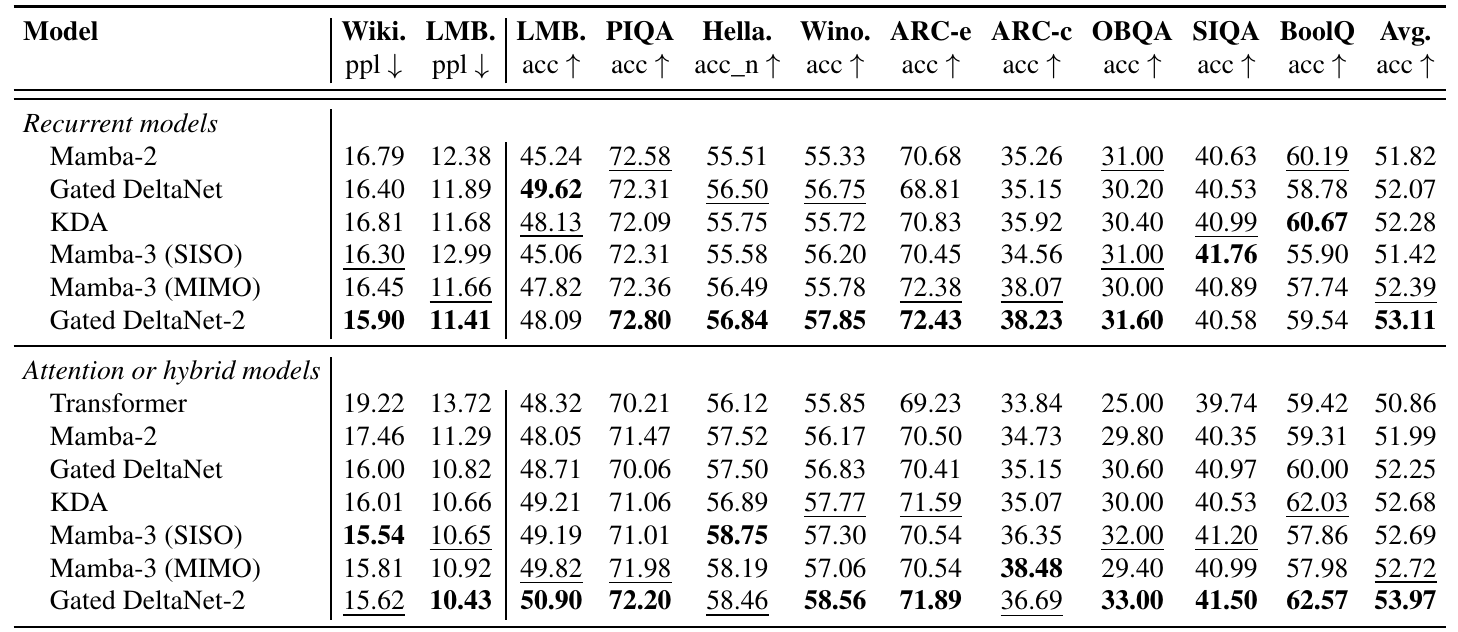
La media de la tabla 2 comprende la exactitud de LAMBADA y las tareas de razonamiento de sentido común indicadas. El modelo recurrente obtiene 53,11, frente a 52,28 de KDA y 52,07 de Gated DeltaNet. El híbrido obtiene 53,97, frente a 52,68 y 52,25. Las mejoras respecto de KDA son 0,83 y 1,29 puntos porcentuales en esas condiciones.
Una media superior no implica liderar todas las tareas. La exactitud recurrente en LAMBADA es 48,09, frente a 49,62 de Gated DeltaNet. La perplejidad híbrida en WikiText es 15,62; Mamba-3 SISO obtiene 15,54, mejor al tratarse de un indicador que debe minimizarse.
Recuperación con errores todavía relevantes
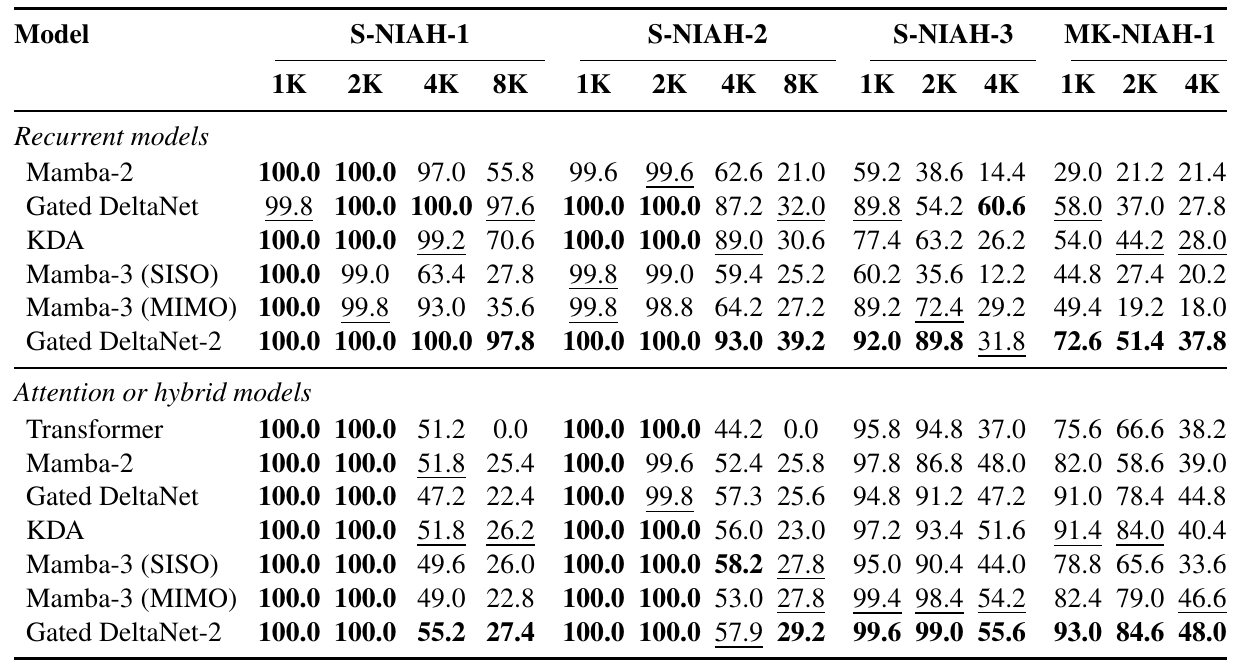
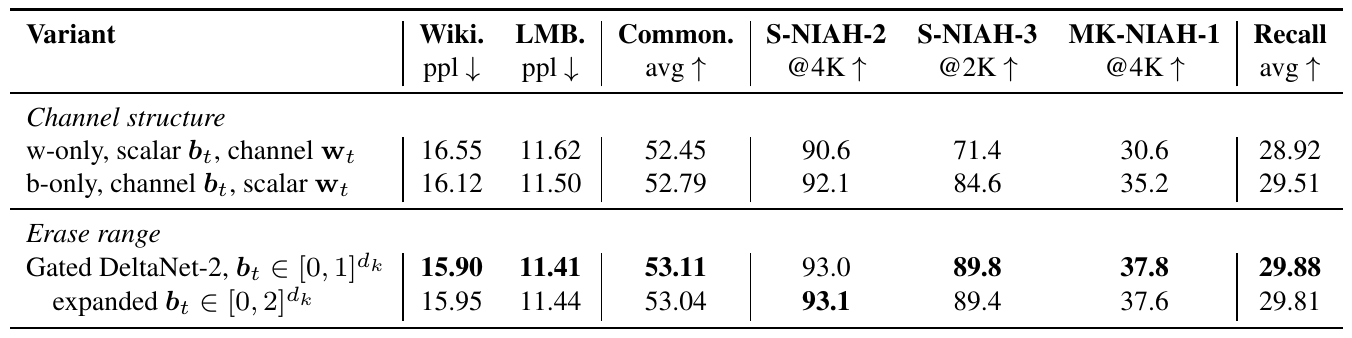
En MK-NIAH-1 de RULER a 4K, la variante recurrente alcanza el 37,8%, frente al 28,0% de KDA y al 27,8% de Gated DeltaNet. La híbrida alcanza el 48,0%, frente al 40,4% de KDA. La mejora recurrente de 9,8 puntos respalda una menor interferencia, pero el 37,8% dista de una recuperación fiable. En S-NIAH-3, cae del 89,8% a 2K al 31,8% a 4K; Gated DeltaNet alcanza el 60,6% a 4K.
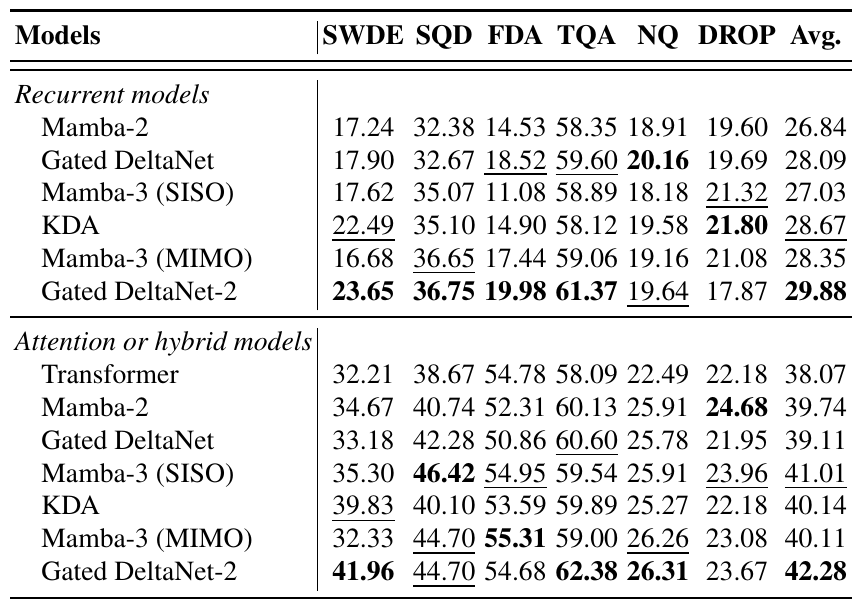
La tabla 4 incluye extracción HTML en SWDE, extracción clave–valor de PDF en FDA, SQuAD, TriviaQA, Natural Questions y DROP, con entradas truncadas a 2K tokens. Las medias son 29,88 frente a 28,67 de KDA en recurrentes y 42,28 frente a 40,14 en híbridos. En DROP, la recurrente queda por debajo de KDA: 17,87 frente a 21,80. No se demuestra recuperación precisa en documentos de cientos de miles de tokens.
Ablaciones y velocidad de entrenamiento
Las ablaciones conservan los pesos de proyección, pero promedian una compuerta entre canales durante la ejecución: el número de parámetros no cambia. En MK-NIAH-1 a 4K, mantener solo escritura por canal da 30,6; solo borrado, 35,2; ambas, 37,8. Ampliar el rango de borrado de [0,1] a [0,2] da 37,6, sin mejora adicional consistente. Ambas estructuras contribuyen, con mayor recuperación de la ganancia al conservar solo el borrado por canal.
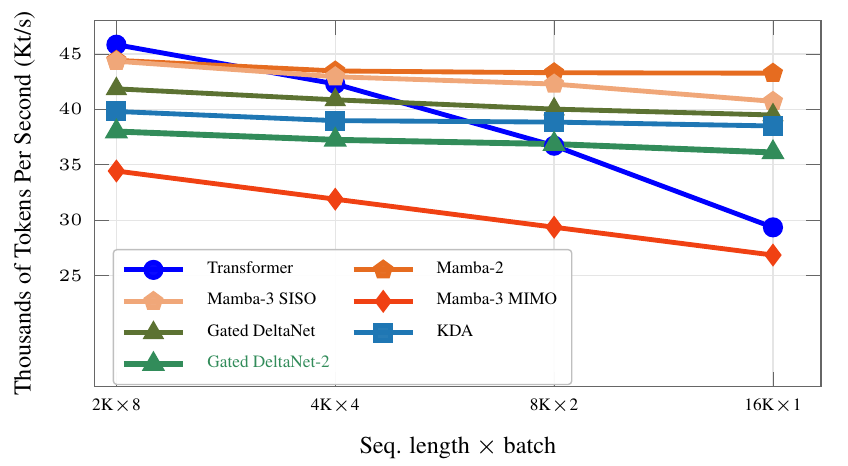
La figura 2 mide entrenamiento de modelos híbridos de 1.300 millones de parámetros en una H100 y con presupuesto fijo de tokens. Gated DeltaNet-2 pasa de 38,0 mil tokens/s con 2K×8 a 36,1 con 16K×1. KDA sigue siendo algo más rápido. Hay un coste de cálculo adicional; estas cifras no acreditan una ventaja general en latencia de inferencia o coste de despliegue.
Alcance y límites
La arquitectura puede orientar sistemas que acumulen historiales largos en un estado acotado o separen información cercana y distante. Es una inferencia del diseño: el artículo no valida análisis de patentes en coreano, recuperación de documentos jurídicos ni un servicio industrial concreto.
La evidencia principal se concentra en 1.300 millones de parámetros y 100.000 millones de tokens. Otras escalas, idiomas y contextos reales más largos requieren evaluación. Las tablas no aportan variabilidad entre entrenamientos ni intervalos de confianza. Un estado fijo conserva límites de capacidad; editarlo mejor no lo convierte en almacenamiento sin pérdida.
Lectura desde la práctica de patentes
El problema concreto es la interferencia entre asociaciones en memoria recurrente comprimida, agravada por vincular borrado sobre claves y escritura sobre valores a un escalar. La solución integra decaimiento por canal y compuertas independientes en la misma actualización delta. La diferencia respecto de KDA se extiende a la formulación paralela asimétrica y al cálculo de gradientes que incorpora las compuertas.
La documentación técnica debe explicar ejes, magnitudes intermedias y su función en la actualización, junto con el cálculo de entrenamiento correspondiente. Los efectos deben ligarse a las comparaciones con igual estado, ablaciones y condiciones H100, incluyendo debilidades por tarea y sobrecoste. Esta lectura técnica no constituye una conclusión de patentabilidad.
La aportación de diseño
Gated DeltaNet-2 permite editar una memoria fija de forma más selectiva: aprende borrado y escritura por separado y mantiene esa separación en la recurrencia y en el entrenamiento paralelo.
La conexión entre problema de interferencia, actualización coordinada y efectos medidos resulta más útil que presentar una puntuación máxima como prueba de superioridad universal. Esa conexión debe leerse junto con sus límites.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Servicio relacionado: patentes de IA
Artículo Gated DeltaNet-2, versión 1 · CC BY 4.0