
研究が扱う課題
YandexのArtem Matveev、Vladislav Tytskiy、Sergei Makeev、Sergei LiamaevによるGated Bidirectional Linear Attention for Generative Retrievalは、長い行動履歴を効率よく利用する研究です。本稿はSIGIR 2026採択論文のarXiv第2版(2026年6月8日)を対象とします。生成型検索が出力するのは候補アイテムの意味的IDであり、通常の文章回答ではありません。
履歴は双方向、出力は自己回帰
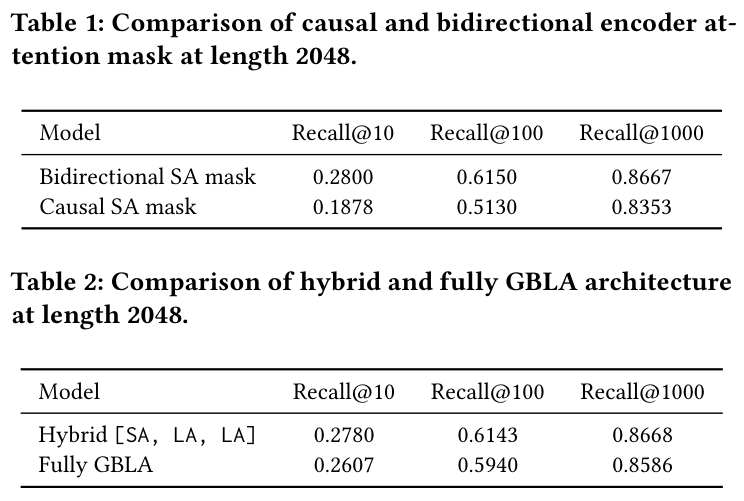
エンコーダは予測時点で既に観測された履歴内を双方向に参照し、デコーダはアイテムIDのトークンを自己回帰的に生成します。観測済み履歴内の双方向性は、将来の正解ラベルを利用することではありません。産業データの履歴長2,048では、双方向自己アテンションのRecall@1000が0.8667、因果マスクが0.8353で、差は3.14ポイントでした。
線形化する計算と三つの追加機構
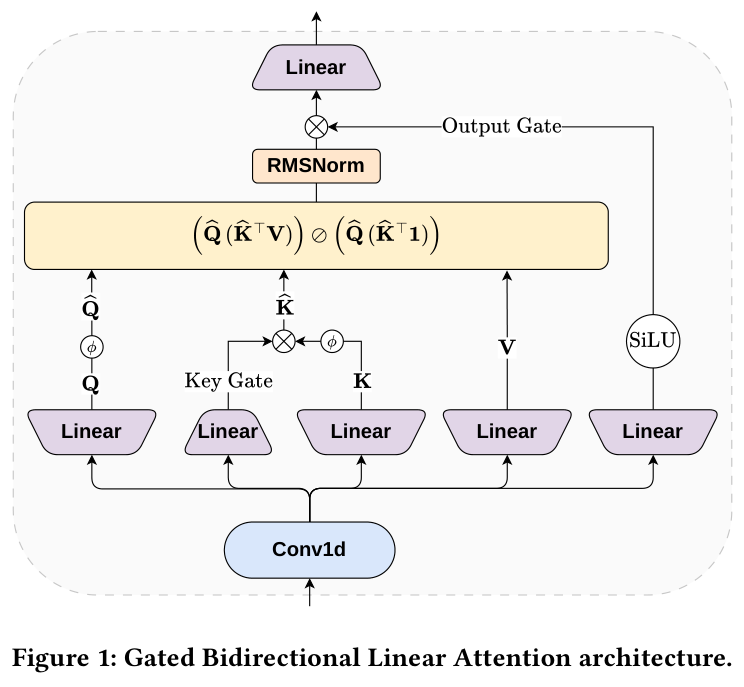
通常のアテンションの計算量は系列長に対してL²dhに比例します。カーネル型の双方向線形アテンションは、ELU+1などの正の特徴写像を用い、φ(Q)(φ(K)ᵀV)をφ(Q)(φ(K)ᵀ1)で正規化する形に並べ替えます。主要計算はLdh²となり、特徴幅dhを固定した場合にLに対して線形です。
GBLAはQ/K/V射影前の局所的な因果Conv1D、系列位置全体で正規化するスカラーのキーゲート、RMSNormとSiLUを組み合わせた出力ゲートを加えます。キーゲートは集約特徴と分母の双方に作用する重み付けであり、二値の削除や再帰的な忘却係数ではありません。実験の畳み込みカーネル幅は4です。
自己アテンションを残す理由
複数ハッシュの埋め込みを連結・射影してエンコーダに入力し、クロスアテンションを持つデコーダにつなぎます。9層のエンコーダでは[自己アテンション、GBLA、GBLA]を反復し、3層を残して6層を置き換えます。したがってモデル全体が完全に線形になるわけではありません。履歴長2,048でのRecall@1000はハイブリッド0.8668、全層GBLA0.8586で、0.82ポイントの差でした。
産業データの結果と構成要素の寄与
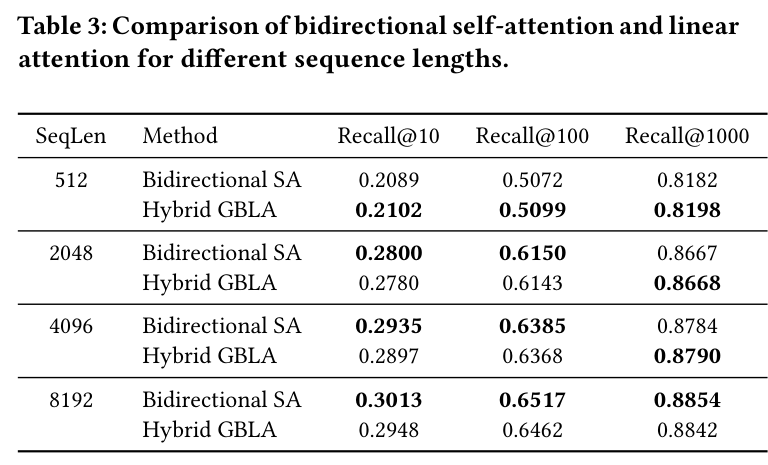
非公開のYandexデータでは7日間・約4億件を学習し、翌日を評価しました。エンコーダは9層、幅1,024、16ヘッド、因果デコーダは1層です。有効バッチサイズはそろえていますが、最大学習率は自己アテンション7×10⁻⁴、ハイブリッド5×10⁻⁴と異なります。Recall@1000は後段ランキングに渡す候補の捕捉率であり、クリック率や売上ではありません。
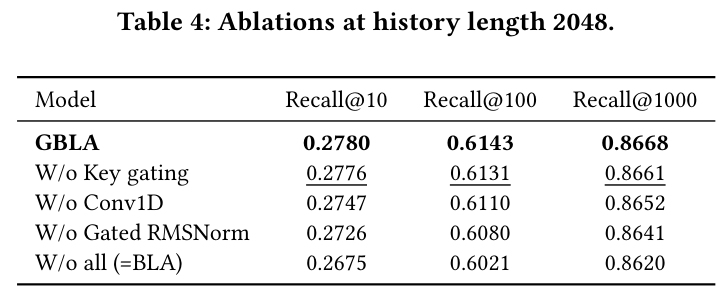
自己アテンション/ハイブリッドのRecall@1000は、長さ2,048で0.8667/0.8668、4,096で0.8784/0.8790、8,192で0.8854/0.8842でした。8,192のRecall@10は0.3013/0.2948で、すべての指標が改善したわけではありません。2,048でキーゲート、畳み込み、ゲート付きRMSNormを除くと、Recall@1000は0.8668から各0.8661、0.8652、0.8641に下がり、通常の線形アテンションは0.8620でした。そのRecall@10は0.2675で、GBLAの0.2780を下回ります。点推定だけで統計的有意差は断定できません。
単一層の高速化と学習全体を区別する
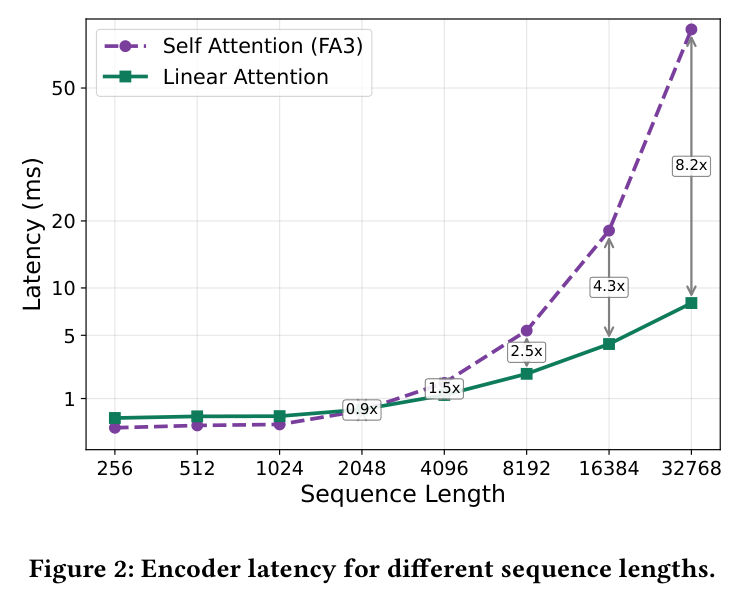
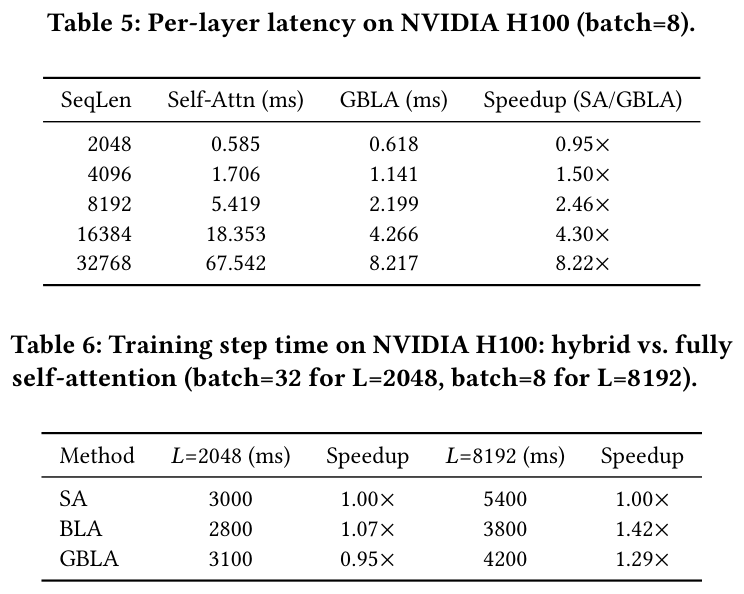
H100上の単一層比較は、バッチ8、10回平均でFlashAttention-v3と比較しています。長さ2,048ではGBLA0.618msに対して基準0.585msで、むしろ遅くなりました。4,096では1.50倍、8,192では2.46倍、32,768では8.22倍(8.217ms対67.542ms)です。「8.2倍」はこの単一層条件の値で、サービス全体の倍率ではありません。
学習全体では長さ8,192・バッチ8で5,400msから4,200msとなり、約1.29倍でした。2,048・バッチ32では3,100ms対3,000msです。通常の線形アテンションは8,192で3,800msとさらに速い一方、精度との交換条件があります。長さによってバッチが異なるため、各行を系列長だけの影響として比較することもできません。
公開ベンチマークの限界
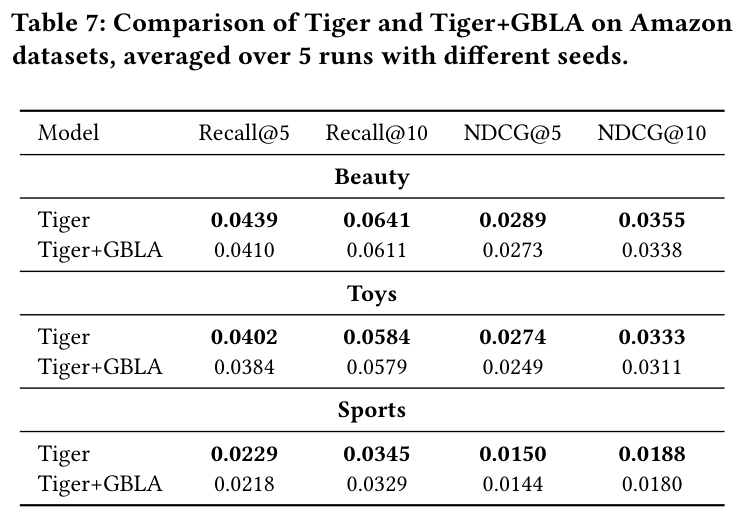
Amazon Beauty、Toys、SportsではGRID/Tigerに従い、5-core処理後の最後の行動をテスト、直前を検証に使いました。Flan-T5埋め込みとRK-Meansの意味的ID、最大128件の履歴を用い、5シードで平均しています。Tiger/GBLAのRecall@10は順に0.0641/0.0611、0.0584/0.0579、0.0345/0.0329でした。
報告されたRecallとNDCGはGBLAがわずかに低く、数値が近いことだけで同等性を証明したとはいえません。短い履歴での速度測定も行われていません。産業データは非公開であり、効果はハードウェア、モデル構成、評価条件の範囲で理解する必要があります。
特許実務から読む技術的構成
長い履歴という課題に対し、局所混合、キー重み付け、出力ゲート、残した自己アテンションがどのような組合せで働くのかが重要です。個々の部品と組合せを区別し、請求項に必要な構成と効果を裏付ける実験を対応させて検討します。
論文の存在だけで新規性や特許性を肯定できません。先行技術、権利範囲、開示の充足性は別途検討が必要です。実装では候補検索の精度、後段ランキング、メモリ、処理全体の遅延を併せて評価します。原図表を保持し、内容を日本語で説明しています。出典論文とCC BY 4.0の表示は下記に記載します。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
論文・図表:Matveevら、GBLA v2、2026(CC BY 4.0) · CC BY 4.0