작성자: 김용덕 변리사
안녕하세요. 아이피렉스 특허법률사무소, 김용덕 변리사입니다.
긴 문서를 읽는 인공지능은 앞서 등장한 정보를 얼마나 정확하게 기억할 수 있을까요? 모든 토큰을 따로 보관하는 대신 일정한 크기의 기억 공간에 내용을 압축하면 비용을 줄일 수 있습니다. 그러나 서로 다른 정보가 같은 공간에 쌓이면서, 필요한 내용을 고치려다가 다른 내용을 흐트러뜨리는 문제가 생깁니다.
이번에 살펴볼 Gated DeltaNet-2는 이 압축된 기억을 편집하는 방법에 관한 논문입니다. 기존 내용을 지우는 조절과 새 내용을 쓰는 조절을 분리하고, 각 조절을 여러 채널에 걸쳐 세밀하게 수행합니다. 핵심은 기억 공간을 무작정 늘리는 것이 아니라, 같은 크기의 공간을 갱신하는 규칙을 바꾸는 데 있습니다.
1. 논문 기본 정보
논문 제목: Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention
논문 저자: Ali Hatamizadeh, Yejin Choi, Jan Kautz. 원문에는 세 저자의 NVIDIA 이메일과 NVIDIA 저작권 표시가 기재되어 있습니다.
식별자: arXiv:2605.22791v1 / DOI: 10.48550/arXiv.2605.22791. arXiv 최초 제출일은 2026년 5월 21일이며 PDF 표지 날짜는 2026년 5월 22일입니다. 이 글은 v1을 기준으로 분석합니다. 확인한 arXiv 기록에 학회·저널 게재 정보가 표시되지 않아 프리프린트로 소개합니다.
원문은 arXiv에서 CC BY 4.0으로 제공됩니다. 아래 도표는 Hatamizadeh·Choi·Kautz의 원문 도표이며, 설명은 김용덕 변리사의 분석입니다.
2. 기술적 배경: 작은 기억장부를 어떻게 고칠 것인가
전체 기록을 보관하는 방법과 요약 장부를 갱신하는 방법
일반적인 소프트맥스 어텐션은 과거 토큰의 키와 값을 보관하고 현재 토큰과 비교합니다. 문맥이 길어지면 학습 중 비교량이 커지고, 생성 시 유지하는 KV 캐시도 증가합니다. 선형 순환 어텐션은 과거 정보를 고정 크기의 행렬 상태 S에 압축합니다. 새 토큰이 들어올 때 이 상태를 고치고, 질문에 해당하는 쿼리로 필요한 내용을 읽습니다.
키는 정보를 찾는 단서, 값은 저장할 내용, 쿼리는 지금 찾으려는 질문에 가깝습니다. 이를 작은 기억장부에 비유하면, 모든 원문을 그대로 붙여 두는 대신 여러 정보를 정해진 칸에 겹쳐 기록하는 셈입니다. 공간은 일정하지만 정보가 간섭할 수 있으므로, 무엇을 남기고 어떻게 수정할지가 중요해집니다.
기존 델타 규칙에 남아 있던 제약
DeltaNet 계열은 새로운 값을 단순히 더하는 대신, 현재 기억에서 읽어 낸 값과 새 값의 차이를 반영합니다. Gated DeltaNet은 여기에 학습된 망각 조절을 더하고, Kimi Delta Attention(KDA)은 키 채널마다 다른 감쇠를 적용합니다.
그런데 Gated DeltaNet과 KDA의 능동적인 수정 부분에는 여전히 하나의 스칼라 게이트 β가 쓰입니다. 이전 내용을 지우는 정도와 새 내용을 쓰는 정도가 같은 수치에 묶이는 것입니다. 낡은 정보는 많이 고쳐야 하지만 새 입력의 일부만 남기고 싶은 상황을, 하나의 손잡이로 조절해야 하는 제약으로 이해할 수 있습니다. 이 비유는 구조를 이해하기 위한 설명이며 별도 실험 결과를 뜻하지 않습니다.
3. 핵심 아이디어: 감쇠·지우기·쓰기를 나누다
Gated DeltaNet-2는 KDA의 채널별 감쇠를 유지하면서 수정 경로를 두 갈래로 나눕니다. 지우기 게이트 b는 키 쪽 채널에, 쓰기 게이트 w는 값 쪽 채널에 작용합니다. 각 게이트는 입력으로부터 독립적인 선형 변환과 시그모이드 함수를 거쳐 만들어집니다.
감쇠는 기존 상태 전체의 각 키 채널이 얼마나 남을지를 조절합니다. 지우기는 감쇠된 상태에서 어떤 키 방향의 기존 내용을 읽어 제거할지 조절합니다. 쓰기는 새로운 값의 어떤 채널을 얼마만큼 기록할지 조절합니다. 따라서 감쇠와 지우기는 모두 과거 정보에 영향을 주지만, 계산에서 맡는 역할과 작용 위치가 다릅니다.
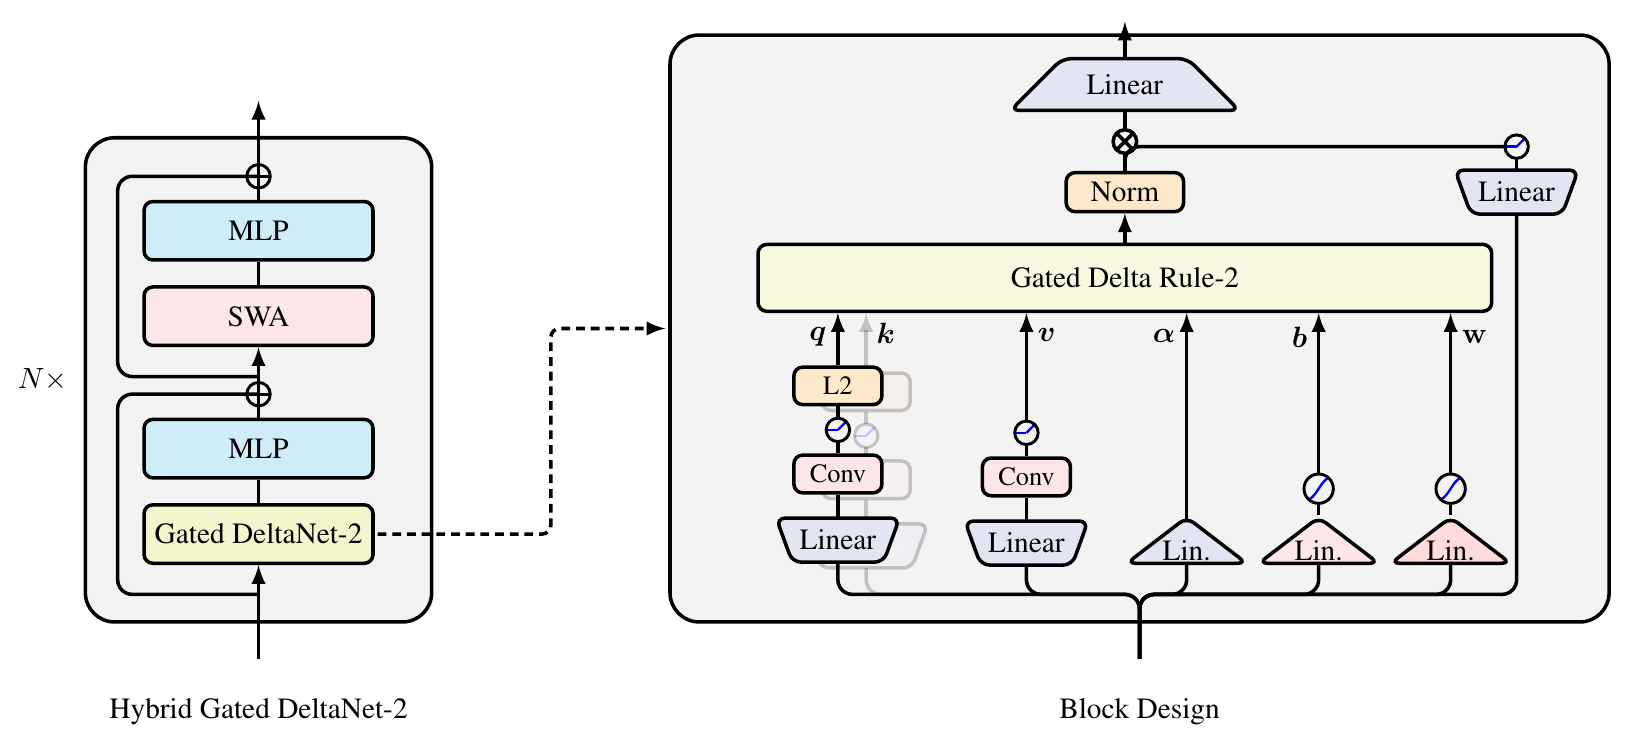
그림 1. 원문 Figure 1: 하이브리드 구조와 Gated DeltaNet-2 블록. α, b, w가 서로 다른 경로로 생성되어 중심 갱신 연산에 들어갑니다.
그림 오른쪽에서는 쿼리·키·값 경로와 감쇠·지우기·쓰기 경로가 구분됩니다. 쿼리와 키에는 짧은 인과 합성곱, SiLU, L2 정규화가 적용되고 값에는 합성곱과 SiLU가 적용됩니다. 갱신 결과에는 RMS 정규화와 별도의 출력 게이트를 적용한 뒤 모델 차원으로 되돌립니다. 여기서 출력 게이트는 기억에 값을 기록하는 쓰기 게이트와 다른 구성입니다.
두 게이트를 동일한 스칼라 β로 제한하면 KDA의 갱신식이 되고, 감쇠까지 스칼라로 제한하면 Gated DeltaNet의 식으로 돌아갑니다. 기존 방식과 완전히 무관한 기억장치를 만든 것이 아니라, 기존 갱신 규칙에 묶여 있던 자유도를 확장한 구조라는 점을 확인할 수 있습니다.
4. 토큰 하나가 들어왔을 때의 처리 순서
① 입력에서 쿼리 q, 키 k, 값 v와 감쇠·지우기·쓰기 게이트를 계산합니다. ② 기존 기억 S에 채널별 감쇠 D를 적용해 감쇠된 기억을 만듭니다. ③ 키에 지우기 게이트를 곱한 방향 e = b ⊙ k로 기존 내용을 읽습니다. ④ 값에 쓰기 게이트를 곱해 기록할 목표 z = w ⊙ v를 만듭니다. ⑤ 목표와 기존 읽기값의 차이를 키 방향으로 반영해 기억을 갱신합니다. ⑥ 갱신된 기억을 쿼리로 읽어 출력을 얻습니다.
핵심 식을 간단히 쓰면 ‘새 기억 = 감쇠된 기억 + 키 × (쓰기 목표 − 지우기 방향으로 읽은 기존 값)의 전치’입니다. 여기서 ⊙는 대응하는 채널끼리 곱한다는 뜻입니다. 사람처럼 특정 문장을 명시적으로 선택해 삭제하는 기능이 아니라, 학습된 벡터 연산으로 행렬 상태를 조절하는 방식입니다.
학습은 작은 묶음으로 병렬화한다
토큰을 하나씩 순서대로 계산하는 식만으로는 GPU 학습을 충분히 빠르게 만들기 어렵습니다. 연구진은 누적 감쇠를 지우기 연산의 두 인자에 흡수하고, WY 형태의 묶음 계산으로 바꿉니다. 부록의 구현에서는 청크 크기를 64로 고정하고, 청크 안에서는 삼각행렬 풀이와 행렬 곱을 사용합니다.
역전파도 함께 바뀌어야 합니다. 서로 다른 채널에 적용되는 b와 w는 하나의 스칼라처럼 행렬 곱 바깥으로 빼낼 수 없습니다. 연구진은 게이트가 반영된 키와 값이 기울기 누적 계산에 직접 들어가도록 구현했습니다. 모델 수식의 자유도 확장과 이를 올바르게 학습시키는 계산 경로가 함께 제시된 것입니다.
5. 실험은 어떤 조건에서 비교했나
주요 비교는 약 13억 개 파라미터 모델을 FineWeb-Edu의 1,000억 토큰으로 학습한 조건입니다. 학습 길이는 4K 토큰이며, 하이브리드 모델의 슬라이딩 윈도 어텐션(SWA)은 2K 범위를 사용합니다. 순환 모델만 사용하는 경우와 순환 모델에 SWA를 결합한 경우를 구분해 비교했습니다.
비교 대상은 Mamba-2, Gated DeltaNet, KDA, Mamba-3의 SISO·MIMO 변형 등입니다. 부록은 파라미터 수뿐 아니라 주요 순환 상태 크기도 맞췄다고 설명합니다. Gated DeltaNet 계열은 16개 헤드에 키·값 차원 각각 128을 사용해, 레이어당 배치 항목 하나에 262,144개의 상태 값을 유지합니다. 이는 전체 모델 메모리 사용량과 같은 의미는 아닙니다.
하이브리드 모델은 압축된 순환 기억으로 긴 범위의 정보를 다루면서 SWA로 가까운 토큰 간 상호작용을 보완합니다. 따라서 하이브리드 결과를 순수 순환 갱신만의 효과로 읽거나, 제한된 윈도 캐시까지 없는 구조라고 이해해서는 안 됩니다.
6. 언어모델링과 상식 추론 결과
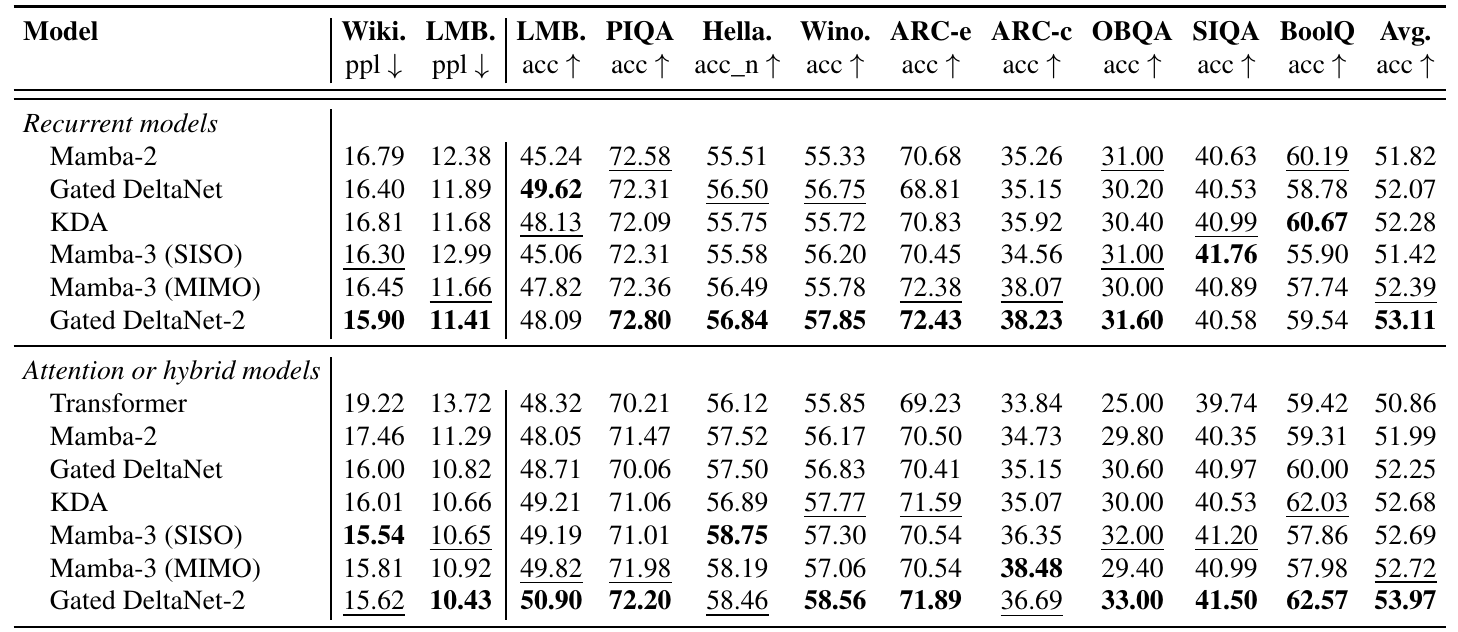
표 1. 원문 Table 2: 언어모델링 및 제로샷 상식 추론 비교. 정확도는 높을수록, 퍼플렉서티(ppl)는 낮을수록 좋습니다.
원문의 Avg.는 LAMBADA 정확도와 표에 열거된 추론 정확도의 평균입니다. 순환 모델에서 Gated DeltaNet-2는 53.11%, KDA는 52.28%, Gated DeltaNet은 52.07%입니다. KDA 대비 차이는 0.83%포인트입니다. 하이브리드에서는 각각 53.97%, 52.68%, 52.25%로, Gated DeltaNet-2와 KDA의 차이는 1.29%포인트입니다.
평균이 가장 높다는 결과를 모든 세부 과제에서 최고라는 뜻으로 확대할 수는 없습니다. 예를 들어 순환 모델의 LAMBADA 정확도는 Gated DeltaNet이 49.62%로 Gated DeltaNet-2의 48.09%보다 높습니다. 하이브리드 WikiText 퍼플렉서티도 Mamba-3 SISO가 15.54로 Gated DeltaNet-2의 15.62보다 낮습니다. 개선의 범위는 평균 성능과 과제별 수치를 함께 보아야 합니다.
7. 검색 성능: 여러 정보가 경쟁하는 상황에서의 변화
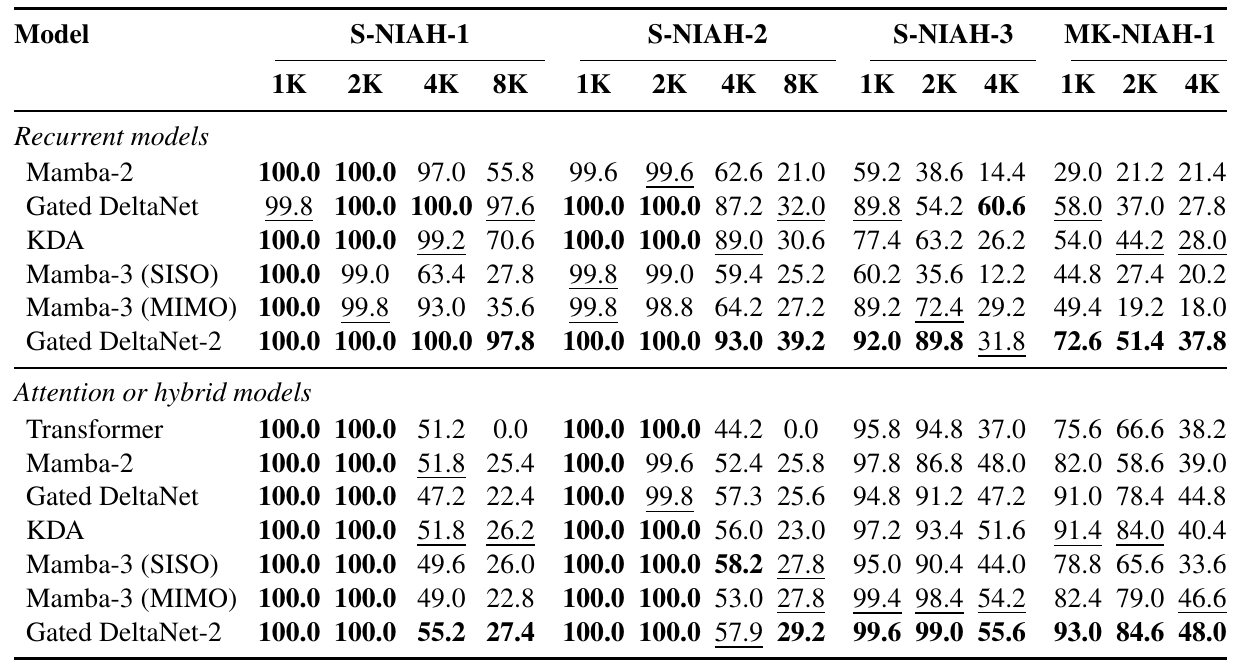
표 2. 원문 Table 3: RULER의 단일·다중 키 검색 정확도. 위쪽 순환 모델과 아래쪽 하이브리드 모델을 구분해 읽어야 합니다.
Needle-In-A-Haystack은 긴 문맥에 섞인 특정 정보를 찾아내는 평가입니다. MK-NIAH-1은 여러 방해 키·값 쌍이 있는 상황에서 요청한 키의 값을 반환하도록 합니다. 순환 모델의 4K 조건에서 Gated DeltaNet-2는 37.8%, KDA는 28.0%, Gated DeltaNet은 27.8%입니다. KDA 대비 9.8%포인트 개선이지만, 절대 정확도가 100%에 가까워진 것은 아닙니다.
같은 MK-NIAH-1의 하이브리드 4K 조건에서는 Gated DeltaNet-2가 48.0%, KDA가 40.4%입니다. 다만 길이 증가와 과제 유형에 따른 한계도 남아 있습니다. 순환 모델의 S-NIAH-3에서 Gated DeltaNet-2는 2K의 89.8%에서 4K의 31.8%로 낮아지고, 이 4K 항목은 기존 Gated DeltaNet의 60.6%보다 낮습니다. ‘긴 문맥을 완벽하게 기억한다’는 결론은 이 표와 맞지 않습니다.
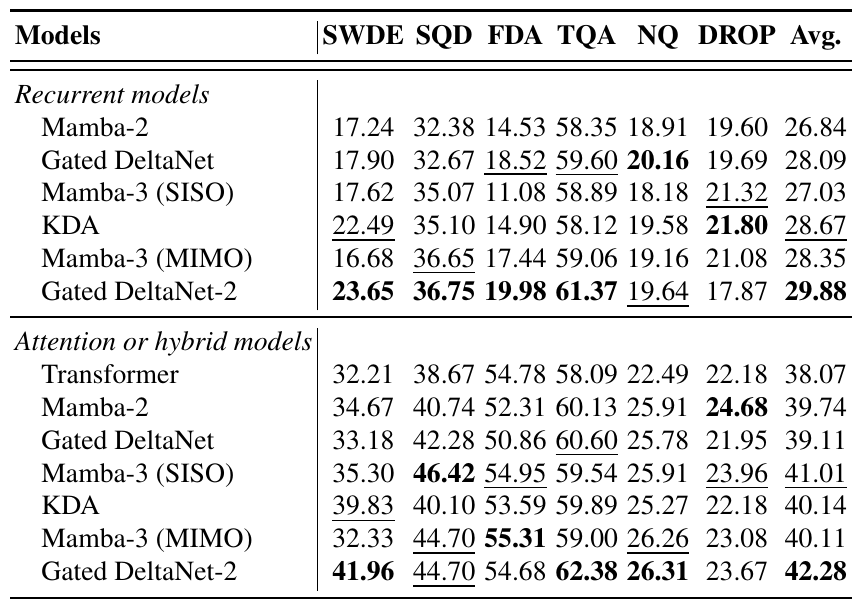
표 3. 원문 Table 4: 실제 자료 기반 검색·질의응답 평가. 입력을 2K 토큰으로 잘라 평가한 결과입니다.
실제 자료 기반 평가에는 HTML에서 관계를 추출하는 SWDE, PDF의 키·값을 찾는 FDA, SQuAD·TriviaQA·Natural Questions·DROP 등이 포함됩니다. 평균은 순환 Gated DeltaNet-2 29.88%, KDA 28.67%, 하이브리드 Gated DeltaNet-2 42.28%, KDA 40.14%로 보고됩니다.
여기에서도 평균과 개별 결과는 다릅니다. 순환 모델의 DROP은 Gated DeltaNet-2가 17.87%, KDA가 21.80%입니다. 또한 입력이 2K로 제한된 실험이므로, 이 수치만으로 수십만 토큰의 실제 문서를 안정적으로 처리한다고 주장할 수 없습니다.
8. 두 게이트는 모두 필요한가, 속도 비용은 얼마인가
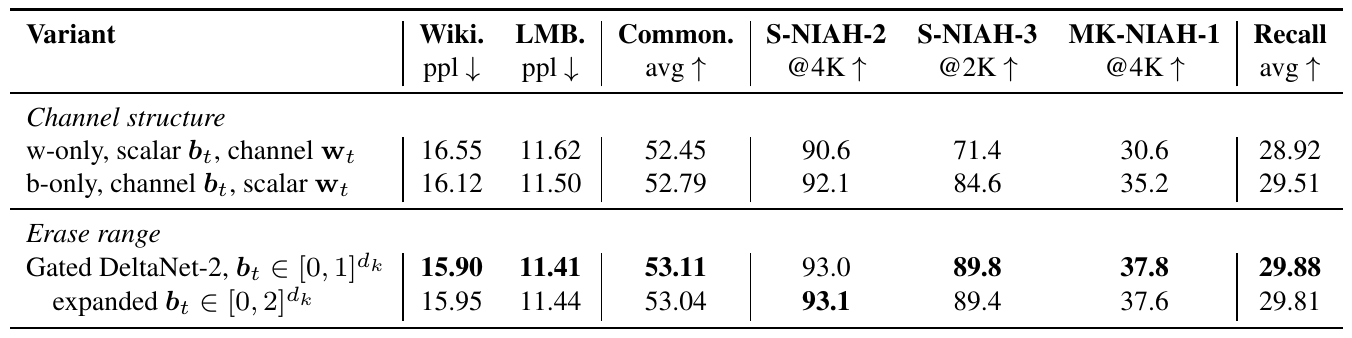
표 4. 원문 Table 5: 게이트의 채널별 변화를 제한한 실험과 지우기 범위를 확장한 실험. 순환 모델 조건입니다.
연구진은 투영층은 그대로 둔 채 한 게이트를 채널 평균으로 바꾸어 모든 채널에 같은 값을 적용했습니다. 따라서 이 비교는 파라미터 수를 줄인 실험이 아니라, 채널마다 달라지는 조절의 기여를 확인하는 실험입니다.
4K MK-NIAH-1에서 쓰기 게이트만 채널별로 유지한 경우는 30.6%, 지우기 게이트만 채널별로 유지한 경우는 35.2%, 두 게이트 모두 유지한 완전한 모델은 37.8%입니다. 이 조건에서는 양쪽 모두 기여하며 지우기 쪽의 기여가 더 크게 나타납니다. 지우기 범위를 [0,1]에서 [0,2]로 확장한 변형은 37.6%로, 일관된 추가 이득을 보여 주지 않았습니다.
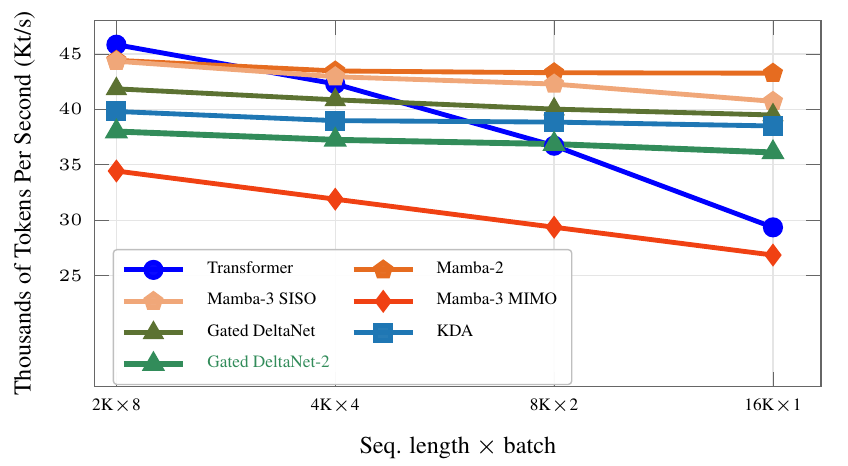
그림 2. 원문 Figure 2: H100 한 대에서 측정한 하이브리드 1.3B 모델의 학습 처리량. 가로축은 문맥 길이와 배치의 조합, 세로축은 초당 천 토큰(Kt/s)입니다.
고정된 토큰 예산에서 문맥 길이와 배치를 2K×8에서 16K×1로 바꿀 때, Gated DeltaNet-2의 학습 처리량은 38.0 Kt/s에서 36.1 Kt/s로 완만하게 감소합니다. 그림에서는 KDA가 이보다 조금 더 빠릅니다. 세밀한 기억 조절을 얻는 대신 일정한 연산 부담이 추가된다는 의미입니다.
이 결과는 해당 GPU·모델·배치 조건의 학습 처리량입니다. 사용자 서비스의 응답 지연이나 모든 장치에서의 비용 절감을 직접 측정한 결과가 아닙니다. 구현에서는 누적 감쇠와 순환 상태 등에 fp32를 사용하며 삼각행렬 풀이의 정밀도도 관리합니다. 단순한 수식 변경만으로 같은 처리량이 자동으로 나오는 것은 아닙니다.
9. 적용 가능성과 남은 한계
기술적으로는 긴 입력을 제한된 상태에 누적하는 언어모델, 가까운 정보와 먼 정보를 나누어 처리하는 하이브리드 모델에 참고할 수 있는 구조입니다. 이는 논문 구조를 바탕으로 한 해석입니다. 이 논문 자체가 법률 문서 검색, 한국어 특허 명세서 분석 또는 특정 산업 서비스에서 효과를 검증한 것은 아닙니다.
주요 검증은 1.3B 규모와 100B 학습 토큰 조건에 집중되어 있습니다. 더 큰 모델, 다른 언어·데이터, 더 긴 실제 문맥에서의 결과를 별도로 확인해야 합니다. 표에는 반복 학습 간 변동이나 신뢰구간이 함께 제시되지 않아, 작은 수치 차이의 통계적 안정성까지 단정하기 어렵습니다.
또한 고정 크기의 상태라는 장점은 정보 용량의 제약과 함께 존재합니다. 이 연구는 그 공간을 더 유연하게 편집하지만, 원문 전체를 손실 없이 저장하는 구조로 바꾸지는 않습니다. 검색 과제에서 남은 오류와 하이브리드 결합에 따른 차이를 함께 이해해야 합니다.
10. 변리사 관점에서 본 기술적 과제와 해결수단
기술적 과제
과제는 한정된 순환 상태에 많은 연관 정보를 압축할 때 생기는 간섭을 줄이는 것입니다. 특히 기존 내용을 지우는 키 측 연산과 새 정보를 기록하는 값 측 연산이 하나의 스칼라에 묶여 있어, 서로 다른 채널 패턴으로 조절하기 어려웠다는 점이 구체적인 출발점입니다.
해결수단과 구성의 결합관계
해결수단은 채널별 감쇠, 독립적인 키 측 지우기 게이트, 값 측 쓰기 게이트를 하나의 델타 갱신식에 결합하는 것입니다. 감쇠된 상태에서 b ⊙ k 방향으로 읽은 기존 값과 w ⊙ v로 만든 새 목표를 비교하고 그 차이를 키 방향으로 기록합니다. 두 게이트를 추가했다는 개수보다, 어느 축에서 어떤 값을 만들고 어떻게 같은 상태 갱신에 들어가는지가 중요한 기술적 내용입니다.
차별성이 드러나는 지점
KDA의 채널별 망각은 유지하되, 능동적인 기억 수정까지 채널별로 분리했다는 점이 구별됩니다. 아울러 이 비대칭 갱신을 청크 단위 병렬 계산으로 옮기고, 게이트가 포함된 기울기 누적을 구현한 내용이 연결됩니다. 저는 이 논문의 기술적 특징을 ‘기억 편집의 자유도 확장과 학습 계산의 대응’이라는 결합으로 해석합니다.
실험으로 확인된 기술적 효과
보고된 효과는 동일한 주요 상태 크기에서 평균 언어·추론 성능과 여러 검색 지표가 개선되고, H100 학습에서 길이 증가에 따른 처리량 저하가 비교적 작게 유지된다는 것입니다. 게이트 제한 실험은 채널별 조절이 결과에 기여함을 뒷받침합니다. 다만 과제별 우열, 낮은 절대 검색 정확도, 추가 연산 비용이 있으므로 효과의 범위를 표에 나타난 조건과 함께 설명하는 것이 정확합니다.
11. 마무리
Gated DeltaNet-2는 AI의 기억을 더 크게 만드는 대신 더 세밀하게 고치는 방법을 보여 줍니다. 과거 내용을 지우는 과정과 새 내용을 쓰는 과정을 독립적으로 조절하고, 그 차이를 실제 상태 갱신과 병렬 학습 계산에 반영한 것이 핵심입니다.
이 연구의 의미는 하나의 최고 점수보다 기술적 과제와 해결수단의 연결에 있습니다. 압축된 기억에서 발생하는 간섭에 대응하는 구조가 어떤 조건에서 효과를 내고 어디에서 한계를 보이는지를 함께 읽을 때, 선형 어텐션의 다음 설계 방향을 더 정확하게 이해할 수 있습니다.
Gated DeltaNet-2 논문 제1판 · CC BY 4.0