
下記の記事でご覧いただくと、機器の故障を予測するためにAIも活用できます。
「予報の1時間で一休みするつもりです。
新聞記事画面に接続するには、ボックスをクリックしてください。
通常、故障予測を行うため、産業設備に設置したセンサーから得られたデータが必要になります。 センサーから得られたデータは、異常検知と呼ばれる機器の故障を予測するために解析することができます。 この投稿では、異常検知についてお話します。
[異常検知]
異常検知とは、通常の異常と異常(またはoutliers、単数)の区別を指します。なるほど。
Anomalyの検出は製造業の装置失敗(か後で)を、Anomalyの検出が私達の顧客によって主に使用される製造のセクターで予測するのに使用されています。 つまり、製造装置に設置されたセンサーは、感心したデータを分析し、故障を予測できるということです。 また、Vinoが取り扱っている医療画像解析の分野では、悪質な腫瘍を検知するために異常な検出を使用することができます。
異常検知は、多くの領域で使用できます。
[異常検知のための学習方法]
異常検知モデルの学習方法はたくさんあります。 学習、半監修の学習、未指導の学習さまざまな方法で異常検知モデルを学習できます。
- 教師トレーニング(上級学習)
教師の訓練のポスト リンク
前回の投稿で先生に説明しました。 異常検知の実行方法を見てみましょう。
学習データセットでは、通常のデータと異常なデータと区別してセットされた学習データをラベル付けしなければなりません。
一般的には、教師学習は、他の学習方法と比較して高精度で特徴付けられます。 そのため、精度が要求されると、多くの教師のトレーニングが使われます。 しかし、異常検知が適用される一般産業現場では、異常な条件で測定したデータの量が異常な条件で測定されるデータ量以上である。 つまり、 クラスバランスの問題は、通常のラベル付きデータ量が多すぎます。 クラスバランスの問題が発生した場合は、異常検知の精度が低下します。.. . バランスの取れた方法でデータを取得できないため、教師学習でモデルを訓練する問題があります。
- セミ・監修の学習
以前説明したように、教師学習による異常検知モデルの学習における最大の問題は、異常な条件に関連したデータを取得するのが難しいことです。
製造では、通常のデータの取得時に異常なデータが1つしか取得できないケースがよくあります。 一流の分類(または半指示された学習)は、クラスバランスが厳しいとき、通常の状態に関連するデータを使用してモデルを訓練するために使用されます。
サポートベクターマシン(SVM)などを使用して、州の状態に関連するデータの境界を決定し、決定された境界の外側のデータが異常と見なされるすべての学習方法です。
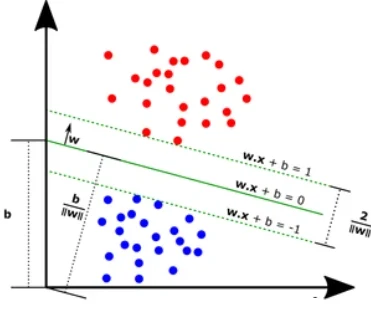
サポートベクトル機械
コンセプト それは少し正確ではありませんが、モデルをdisproportionateデータで訓練するときに有効です。です。
- (未熟な学習)
アンチティーチャー学習で説明する方法は、取得されたデータが正常なデータであることを比較学習が仮定し、ラベルを取得せずに学習を実行する通常のデータのためのラベルを固定するプロセスを必要とします。 オートエンコーダを使うと、コンパレータを学ぶことができます。
- タグ付き投稿 ‘Autoencoder’
- 理解できるようにするには、コンテンツの若干変更により、実際のオートコーダとの違いがあります。
自動エンコーダは、入力データを圧縮し、圧縮されたデータを復元するプロセスを実行します。
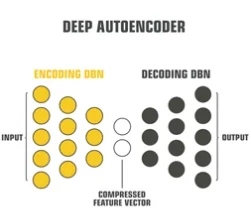
具体的には、自動エンコーダは、入力を潜在変数(圧縮機能)に圧縮するエンコーダ(DBNのエンコード)と、元のデータに潜在変数を復元するデコードDBNで構成されています。 オートエンコーダを使うと、データラベルなしで、データの主要コンポーネントである安定した状態の特徴がわかります。
一方、学習オートエンコーダが入力に入った場合、入力データと同一のデータがデコーダから出力されます。
そのため、データが自動エンコーダに入ったらどうなりますか?
自動エンコーダのエンコーダとデコーダは、異常な状態のデータが入力されると、自動エンコーダは適切に圧縮され、復元することはできません。 そのため、デコーダから出力された最終出力データは入力データとは異なる。
結果として、 入力データ(x)を自動エンコーダに入力し、最終出力データの差分(x')は、入力データが正常な状態や異常な状態に関連しているかどうかを確認するためにチェックされます。.
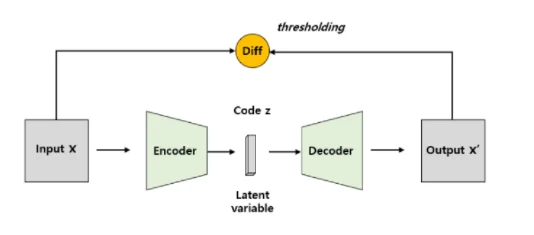
Autoencoder、2019、arXivに構造的類似性を適用することにより、監視されていない欠陥の認知を改善
- 自動エンコーダを用いた特許
製造施設の異常検知を自動エンコーダーで行う方法については、まちならけの特許を見てみましょう。
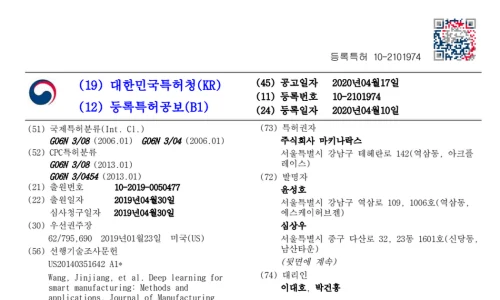
画像をクリックすると登録特許が確認できます。
安定した状態データは、各レシピに異なるパターンがあります。 各レシピの異なるオートエンコーダを学習する必要性は、従来の技術の制限でした。 それから、複数の自動エンコーダーを学ぶために、複数の製造レシピから各データを使用して、それは時間とコストの問題だけである。
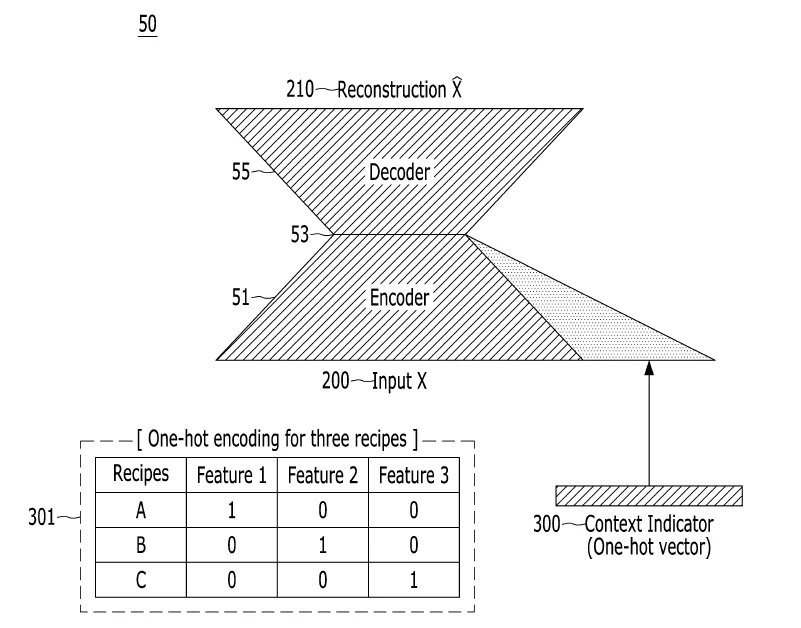
McKinney は、これらの問題を解決します。. 自動エンコーダを訓練するときは、製造レシピの引数をセンシングデータで自動エンコーダに入力します。提供しました。 具体的には、現在の製造レシピのどれがセンシングデータがセンシングデータでオートエンコーダに入力されているかを示す機能値(コンテキストインジケータ)です。 自動エンコーダは、入力に入力したセンシングデータと同じデータを出力するために訓練されます。 これを学ぶことで、ひとつのオートエンコーダは、様々な製造レシピデータの正常性と異常性を判断することができます。 具体的には、コンテキストインジケータとセンシングデータ(X)は、学習したオートエンコーダの入力に置き、出力値(X)とセンシングデータ(X)の違いが計算されます。 差分の値がセット値より小さい場合、通常は決定され、差分がセット値よりも多ければ異常に決定されます。
通常、特許出願のアイデアを作成するときに、次のメソッドが使用されます。
特定の分野(製造分野)における慣習的な技術(自動エンコーダー)の使用の問題は、いくつかの問題(各製造のレシピは、別の自動エンコーダーを必要とする)があることであり、これらの問題を解決するために、従来の技術(自動エンコーダー)の変更方法を考えることによって、我々は多くのアイデアを作成します。 この方向にアイデアが作成されると特許出願が提出されると、特許登録率が大幅に高くなります。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。