
近年、人工知能による医学的画像の分析と疾患の診断技術が急速に成長しています。 Buno、Lunett、J.Kなどのスタートアップ多数。 検査は技術の勉強をしており、分析の精度を高めるために研究が積極的に行われています。 この記事では、AIベースの医療画像解析の精度を高める技術に関するロネット特許について説明したいと思います。
画像をクリックすると登録特許が確認できます。
特許。
人工知能を使用して、細胞によって撮影された画像の類似の分裂セルを見つけるには、現在の発明の重要な側面です。 現在の発明で使用されるAIモデルは、従来のニューラルネットワーク(CNN)です。 現在の発明で用いられる複雑なニューラルネットワークモデルは、撮影した画像の擬似分割細胞と正常な細胞を分類することができます。 一方、より正確な予測を実行するために、現在の発明は2つの学習プロセス(ステップ1の訓練とステップ2の訓練)を受けます。
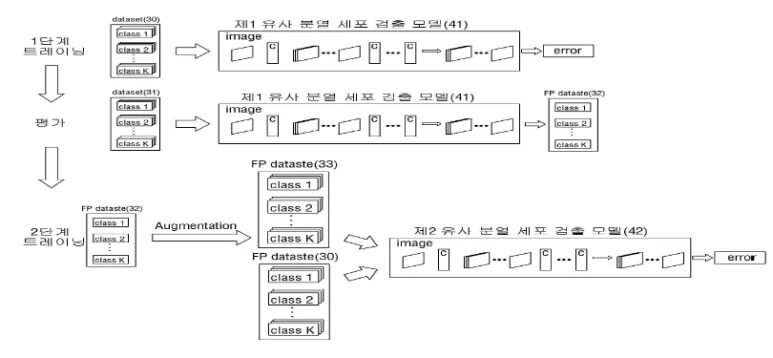
レベル1トレーニング
模倣セルまたは正常な細胞を指す分類結果として、病理学者が指定した一組の第一線データを用いてモデルの第1段階の訓練を実施します。 ここまではよくあります。
ステージ2のトレーニングの準備
最初のレベルトレーニングを完了した後、第2レベルのトレーニングのために設定されたデータを準備します。 具体的には、第一段階のトレーニングが完了すると、モデルは偽陽性データセット(擬似分割セル、通常のセルに分類されるデータセット)を収集するために評価されます。 また、FPデータセットのデータセットのデータ集計(画像回転、騒音追加等)を行なってFPデータセットの量を増加させます。 最初のトレーニングデータセットと強化されたFPデータセットを準備して、第1段階のトレーニングを実行します。 ここでは、FPデータセットは、AIモデルが分類されないデータセットです。 医療業界では、病気が起きる最悪のケースだからFPデータセットを収集し、FPエラー(偽正誤差)を削減することが重要です。
レベル2トレーニング
ステップ1で使用されるCNNモデルの重みを初期化します。 初期化せずに初めてのトレーニングで使用するCNNモデルを使うと、フィルタウェイトがファインチューニングされます。 この場合、精度があまり改善されていないため、重みの初期化が必要です。 CNNモデルの重みを初期化する場合、準備されたデータセット(最初のトレーニングデータセット+強化されたFPデータセット)は、CNNモデル(第2レベルのトレーニング)を再学習するために使用されます。 完成したCNNモデルで画像が分類されている場合、FPエラーが大幅に低減されます。
特許に関する意見
AIモデルの設計プロセスでは、モデルの精度を高めるために、誤った正誤差(FP)を減らすことが重要です。 しかし、多くのAI特許を扱う経験の中で、私はLunitの特許について少し疑問を抱えています。 Lunett の特許によると、CNN のモデルを学ぶと、モデルの精度が悪い可能性があります。 実際には、既存のデータセットでモデルを再学習するためにFPデータセットを拡張する場合、トレーニングデータセットはFPデータセットに偏光されることがあります。 しかしながら、FPエラーを削減するためには、この方法を考慮することは可能です。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。