
Como se puede ver en el artículo siguiente, IA también se puede utilizar para predecir el fallo del equipo.
“Va a descomponerse en una hora debido a la previsión.
Haga clic en la casilla para conectarse a la pantalla del artículo del periódico.
Por lo general, para realizar la predicción de fallas, se requieren datos obtenidos de sensores instalados en instalaciones industriales. Los datos obtenidos del sensor pueden ser analizados para predecir el fallo del equipo, que se llama detección de anomalías. En este post hablaremos de detección de anomalías.
[Detección de anomalías]
La detección de anomalías se refiere a la distinción entre lo normal y lo anormal (o fueraliers, singularidades).Sí.
La detección de anomalías se utiliza para predecir la falla del equipo de fabricación (o más tarde) en el sector manufacturero, donde se utiliza la detección de anomalías, principalmente por nuestros clientes. Esto significa que el sensor instalado en el equipo de fabricación puede analizar los datos sensoriales y predecir fallos. Además, en el campo del análisis de imágenes médicas con el que se ocupa Vino, la detección de anomalías se puede utilizar para detectar tumores malignos.
La detección de anomalías se puede utilizar en muchas áreas.
[Metodos de aprendizaje para detección de anomalías]
Hay muchas maneras de aprender el modelo de detección de anomalías. Aprendizaje supervisado, aprendizaje semisupervisado y aprendizaje no supervisadoUsted puede aprender el modelo de detección de anomalías de una variedad de maneras.
- Aprendizaje supervisado
Enlace al artículo sobre aprendizaje supervisado
El artículo anterior explicó el aprendizaje supervisado. Ahora examinamos cómo utilizarlo para detectar anomalías.
Con un conjunto de datos de aprendizaje, el diseñador modelo debe etiquetar los datos de aprendizaje establecidos mediante la distinción entre datos normales y anormales, que se llama etiquetado.
En general, el aprendizaje supervisado se caracteriza por una alta precisión en comparación con otros métodos de aprendizaje. Por lo tanto, si se requiere precisión, se utiliza un montón de formación de maestros. Sin embargo, en los sitios industriales generales donde se aplica la detección de anomalías, la cantidad de datos medidos en condiciones normales es más que la cantidad de datos medidos en las condiciones anormales. En otras palabras, Un problema de equilibrio de clase resulta en demasiados volúmenes de datos normalmente etiquetados. En caso de un problema de nivel de clase, se reduce la precisión de la detección de anomalías.. Debido a que los datos no pueden obtenerse de manera equilibrada, es problemático formar un modelo a través del aprendizaje supervisado.
- Aprendizaje semisupervisado
Como se explicó anteriormente, el mayor problema con el aprendizaje de un modelo de detección de anomalías a través del aprendizaje supervisado es que es difícil obtener datos relacionados con condiciones anormales.
En la fabricación, es a menudo el caso de que sólo se obtengan datos anormales durante la adquisición de millones de datos normales. La clasificación de una clase (o el aprendizaje semisupervisado) se utiliza para formar un modelo utilizando datos relacionados con su estado normal cuando el equilibrio de clase es severo.
Utilizando una máquina vectorial de soporte (SVM), etc., para determinar los límites de los datos relacionados con el estado del estado, los datos fuera de los límites determinados son todos los métodos de aprendizaje que se consideran anormales.
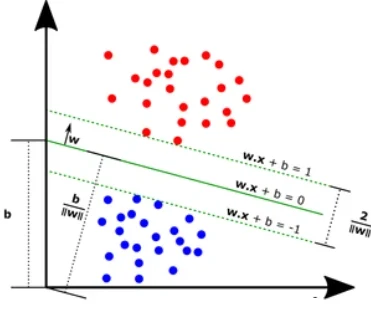
Soporte Vector Machine
Es... Es un poco menos preciso, pero es eficaz cuando entrenas modelos con datos desproporcionados.Lo es.
- (Aprendizaje no supervisado)
El método descrito en el aprendizaje anti-profesional requiere el proceso de asegurar una etiqueta para datos normales, donde el aprendizaje comparativo supone que los datos obtenidos son datos normales y realiza el aprendizaje sin obtener una etiqueta. Al utilizar el auto-encoder, es posible aprender comparador.
- Posts Tagged 'Autocodificador'
- Para ayudarle a entender, puede haber diferencias entre el autocodificador real modificando ligeramente el contenido.
El auto-encoder realiza un proceso de comprimir los datos de entrada y restaurar los datos comprimidos.
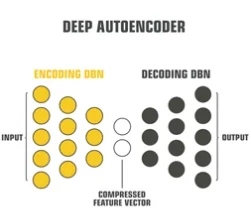
Específicamente, el auto-encoder consiste en un encoder (Encoding DBN) que comprime la entrada en una variable latente (Característica comprimida) y un DBN de decodificación que restaura la variable latente a los datos originales. Al utilizar un auto-encoder, usted aprenderá las características de un estado estable, que es el componente principal de los datos, sin etiquetar datos.
Por otro lado, si se introduce un auto-encoder de aprendizaje en una entrada, los datos de entrada y los mismos datos se obtienen del decodificador.
Entonces, ¿qué pasa si los datos entran en el auto-encoder?
Dado que los encoders y decodificadores de los autocodificadores han sido entrenados con datos de estado estables, cuando se introducen datos de estado anormales, los autocodificadores no pueden ser adecuadamente comprimidos y restaurados. Así, la salida final de los datos de salida del decodificador será diferente de los datos de entrada.
Como resultado, Los datos de entrada (x) introducidos en el auto-encoder y el diff de los datos de salida final (x') se verifican para ver si los datos de entrada están relacionados con el estado normal o con el estado anormal..
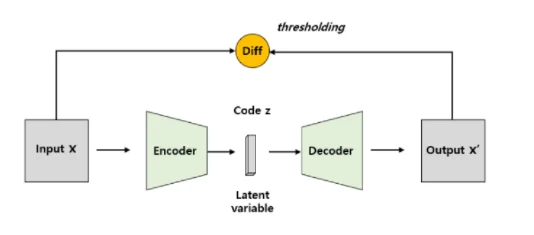
Mejora de la Cementación de Defecto No Supervisada aplicando la similitud estructural al Autocodificador, 2019, arXiv
- Patentes utilizando auto-encoder
Echemos un vistazo a la patente de Machinarak sobre cómo realizar una detección de anomalías de una instalación de fabricación utilizando un auto-encoder.
Si hace clic en la imagen, puede ver la patente de registro.
Los datos de estado estables tendrán diferentes patrones para cada receta. La necesidad de aprender diferentes autocodificadores para cada receta era una limitación de la tecnología convencional. Luego, utilizando cada uno de los datos de una serie de recetas de fabricación para aprender múltiples autocodificadores, es sólo una cuestión de tiempo y costo.
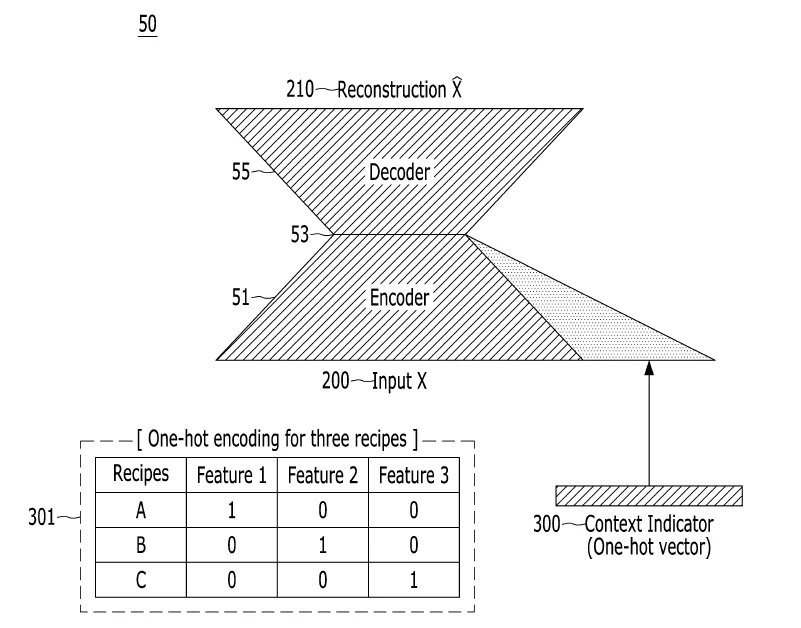
McKinney para resolver estos problemas. Cuando entrena un auto-encoder, ingrese los argumentos para la receta de fabricación en el auto-encoder con los datos de detecciónse ofreció a hacerlo. Específicamente, un valor de característica (indicador de texto) que indica cuál de las recetas de fabricación actuales son datos de detección se introduce en el autocodificador con los datos de detección. El auto-encoder se entrena para producir los mismos datos que los datos de detección introducidos en la entrada. Al aprender esto, un solo auto-encoder puede determinar la normalidad y la anormalidad de varios datos de recetas de fabricación. Específicamente, el indicador contextual y los datos de detección (X) se colocan en la entrada del auto-encoder aprendido, y se calcula la diferencia entre el valor de salida (X) y los datos de detección (X). Si el valor de la diferencia es inferior al valor establecido, normalmente se determina, y si la diferencia es más que el valor establecido, se determina anormalmente.
Por lo general, se utilizan los siguientes métodos cuando se crea una idea para una solicitud de patente:
El problema del uso de la tecnología convencional (auto-encoder) en un campo particular (en el campo de fabricación) es que hay algunos problemas (cada receta de fabricación requiere un auto-encoder separado), y para resolver estos problemas, creamos muchas ideas pensando en cómo modificar la tecnología convencional (auto-encodificadores). Si una solicitud de patente se presenta después de que la idea se crea en esta dirección, la tasa de registro de patentes será significativamente mayor.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.