
如下文所述,AI也可以用于预测设备故障.
“由于预测, 一小时后会崩溃。
点击框连接到报纸文章屏幕.
通常,为了进行断层预测,需要从工业设施安装的传感器中获得数据。 从传感器获得的数据可以进行分析以预测设备的故障,这被称为异常探测. 我们将会讨论异常点检测问题。
[异常检测]
异常检测是指区分正常和异常(或异常,奇数).没错。
异常检测可用于制造设备故障预测,例如分析设备传感器采集的数据;在医学影像领域,也可用于恶性肿瘤检测。原文分别以SUAlab、MakinaRocks及VUNO的业务场景作说明。
异常检测可以在许多地区使用.
[学习异常检测法]
学习异常探测模型的方法有很多种. 监督学习、半监督学习和无监督学习你可以通过多种方式学习异常检测模型.
- 教师培训(监督学习)
师范邮政联系
我之前曾向我老师解释此事, 让我们看看如何进行异常检测。
有了学习数据集,模型设计师必须通过区分正常数据与异常数据来给学习数据集贴上标签,这被称为标签.
一般而言,与其他学习方法相比,监督学习的特点是精度高。因此,如果需要准确性,就使用大量的师资培训。然而,在一般应用异常检测的工业场所,在正常条件下测得的数据量大于在异常条件下测得的数据量。换句话说 类平衡问题导致太多的数据卷通常被贴上标签。 如果出现类偏差问题,异常检测的精度会降低.由于难以均衡获取各类数据,直接采用监督学习训练模型会遇到困难。
- 半监督学习
如前所述,通过监督学习学习异常检测模型的最大问题是难以获得与异常条件相关的数据。
在制造中,在获取数百万正常数据的过程中往往只获得一个异常数据. 单级分类(或称半监督学习)用于在类平衡严重时使用与其正常状态相关的数据来训练一个模型.
使用辅助矢量机(SVM)等,确定与状态相关的数据边界,确定边界外的数据都是被认为是异常的学习方法.
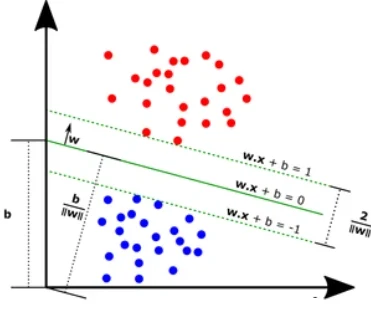
支持矢量机
其 类 它的准确性略低,但当用不相称的数据训练模型时是有效的.没错
- (无监督学习).
反监督学习中描述的方法需要为正常数据获得标签的过程,其中比较学习假设获得的数据是正常数据,并在没有获得标签的情况下完成学习。在使用自动编码器时,可以学习比较器。
- 标注“自编码器”
- 为了帮助你理解,实际上的自动编码器之间可能会通过略微修改内容而有所区别.
自动编码器执行压缩输入数据和恢复压缩数据的过程.
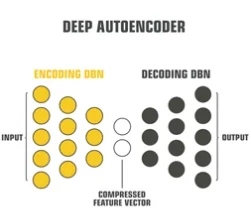
具体来说,自动编码器包括一个将输入压缩成潜在变量(压缩特性)的编码器(Encoding DBN)和一个将潜在变量还原到原始数据的解码器DBN. 在使用自动编码器时,您会学习一个稳定状态的特性,它是数据的主要组成部分,而不给数据贴标签.
另一方面,如果一个学习自动编码器被投入到一个输入中,输入数据和相同数据都是解码器输出的.
如果数据进入自动编码器会怎样?
由于自动编码器的编码器和解码器都接受了稳定状态数据的培训,当异常状态数据是输入时,自动编码器无法被适当压缩和恢复. 因此,解码器的最终输出数据输出将不同于输入数据.
结果, 在自动编码器中输入的输入数据(x)和最终输出输出数据(x')的diff被检查,以查看输入数据是否与正常状态或异常状态有关..
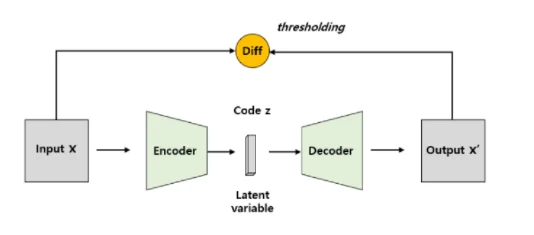
通过将结构相似性应用到自编码器上来改进无监督的减精,2019年,arXiv
- 使用自动编码器的专利
让我们看看Machinarak的专利如何对使用自动编码器的制造设施进行异常检测.
点击图像即可看到注册专利.
稳定的状态数据对每种食谱会有不同的模式. 需要为每种食谱学习不同的自动编码器,这是传统技术的局限性。 然后,利用来自一些制造配方的每一个数据来学习多个自动编码器,这仅仅是时间和成本的问题.
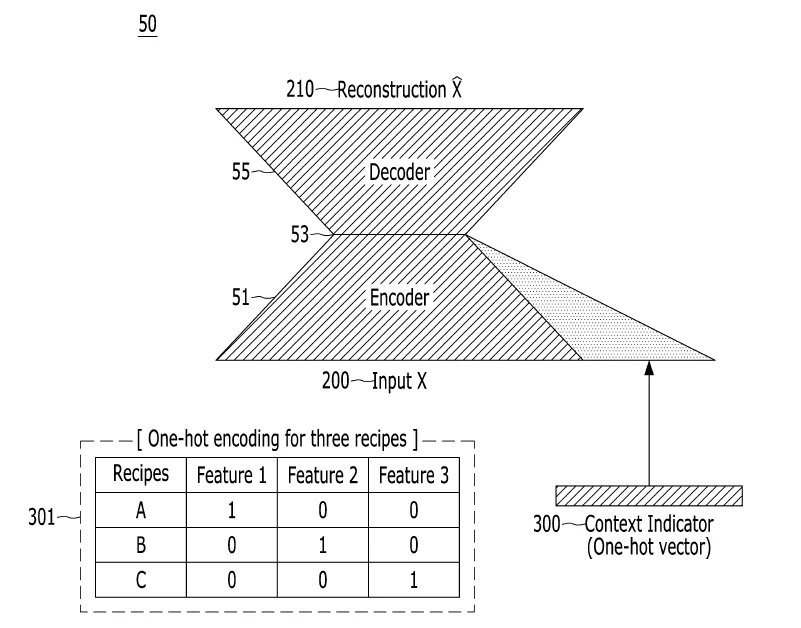
麦金尼来解决这些问题. 在培训自动编码器时,用感知数据将制造配方的论据输入自动编码器中该方案将表示当前制造配方的上下文指示量与传感数据共同输入自编码器,训练模型重构输入的传感数据,使同一自编码器能够判断不同制造配方数据的正常或异常状态。具体而言,将上下文指示量与传感数据X输入训练后的模型,计算输出X′与输入X之间的差值;差值小于设定值时判定为正常,大于设定值时判定为异常。
通常在为专利申请创建想法时使用以下方法: 1.
在特定领域(制造业领域)使用常规技术(自动编码器)的问题是存在一些问题(每个制造配方都需要单独的自动编码器),为了解决这些问题,我们通过思考如何修改常规技术(自动编码器)来创造很多想法. 如果在思想形成后向这一方向提出专利申请,专利登记率将显著提高.
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。