
弁理士の視点から論文を読む
執筆:IPLEX・韓国弁理士 金容德。Multi-Head Attention Residualsは、言語モデルが計算済みの表現をどのように再利用するかを扱う研究です。特徴のまとまりによって、必要とする過去の層の情報は異なり得ます。以下の実験結果は論文著者の報告であり、IPLEXが実施した実験ではありません。
対象はCheng Luo、Zefan Cai、Junjie HuによるMulti-Head Attention Residuals、arXiv:2607.27230v2(2026年7月31日改訂)です。著者所属はIndependent ResearcherおよびUniversity of Wisconsin–Madisonと記載されています。プレプリントおよび転載した研究図表の著者は上記のとおりであり、ライセンスはCC BY 4.0です。
残差ストリームから過去の表現の選択へ
一般的なpre-norm Transformerでは、各サブレイヤーの出力を残差ストリームに加算します。次のサブレイヤーが受け取るのは累積状態であり、過去の出力を個別に取り出せる集合ではありません。過去の情報が失われるという意味ではなく、その選択方法が問題となります。
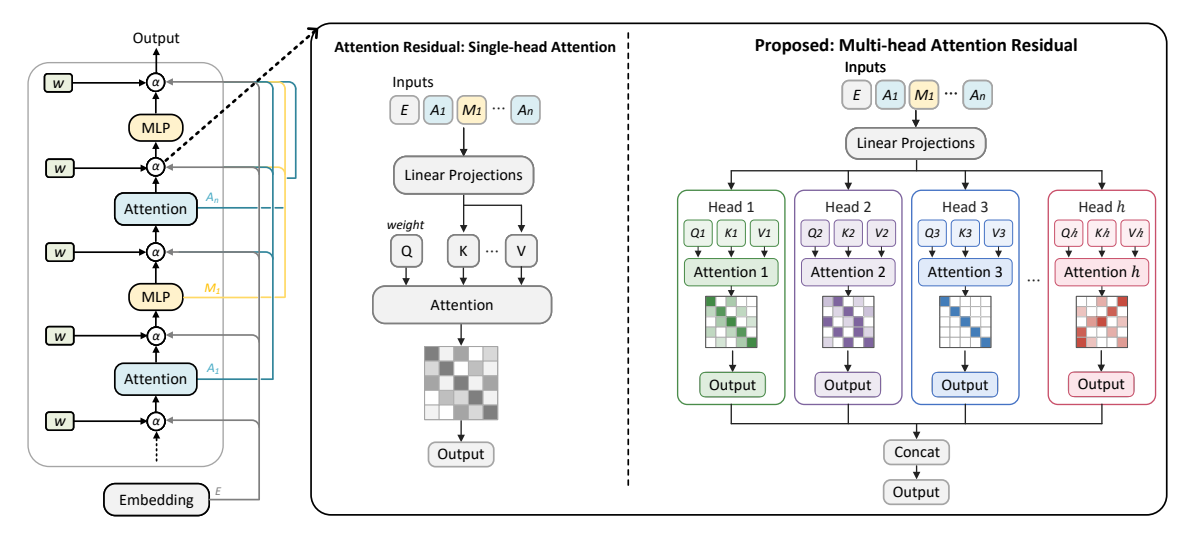
Attention Residualsは埋め込みと過去のAttention・MLP出力を個別の情報源として保持します。学習可能なクエリで評価し、深さ方向のsoftmaxによって加重和を求めます。単一ヘッドでは一つの深さ分布が全特徴チャネルに適用されるため、異なる情報を必要とする特徴群も同じ選択規則を共有します。
MHARが変更する点
MHARは、次元dのクエリと各情報源の表現を、次元d/HのH個の特徴部分空間に分割します。各ヘッドが情報源を評価し、深さ方向に独立したsoftmaxを適用します。部分ごとの加重和を連結して次元dの入力に戻します。H=1であれば単一ヘッドのAttention Residualsになります。
通常のマルチヘッド自己注意がトークンを選択するのに対し、MHARは現在位置で過去の層の出力を選びます。学習された深さ選択パターンの違いから、各ヘッドが文法や数学を専門に担当するとまではいえません。また、模式図から大型の投影ネットワークを別途追加すると理解すべきではなく、提案の中心は既存のクエリと特徴次元の再配置です。
処理の流れと実装コスト
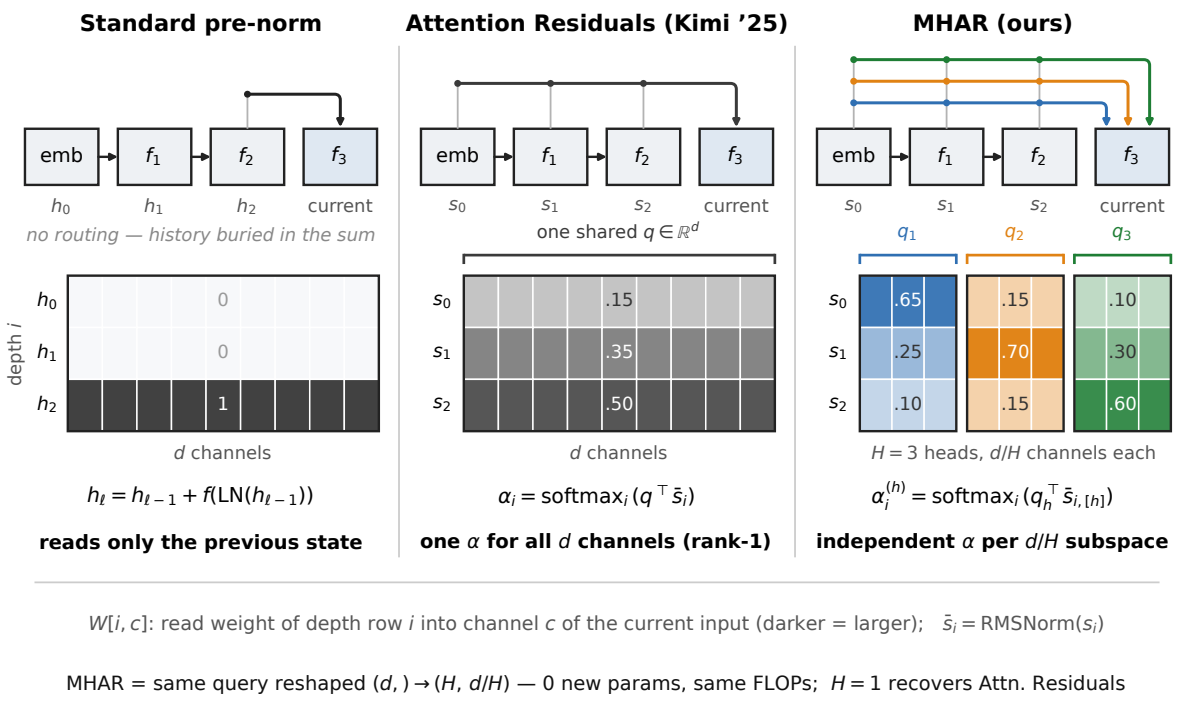
利用するのは埋め込みと計算済みのサブレイヤー出力であり、未来の層は参照しません。RMSNormで正規化した表現をキーとし、元の情報源をバリューとします。クエリとキーを対応する部分空間に分割し、ヘッドごとに評価・softmaxを行い、特徴群の加重和を連結して現在のAttentionまたはMLPに入力します。
主たるゼロからの学習実験では、ルーティング用クエリを0で初期化するため、最初の選択分布は一様です。「追加パラメータなし」の比較対象は単一ヘッド方式です。通常のTransformerに対しては、約0.02%のパラメータ増と約0.5~1.2%の理論計算量増が報告されています。過去の表現の読み出しにはメモリアクセス負荷が残るため、Tritonの融合カーネルも提案されています。
ゼロからの学習:比較の基準を区別する
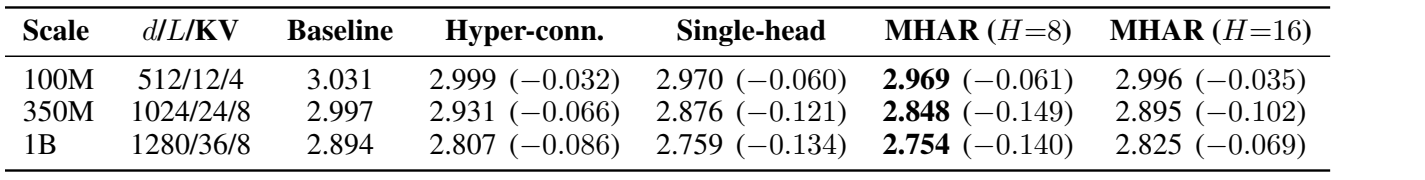
主要実験はQwen3系構造の100M、350M、1Bモデルを2万ステップ学習するものです。データは重複除去・精製済みの英語anneal_pt_v3で、合成データ、STEM、コードを多く含みます。同一規模内でデータ、学習日程、バッチ条件をそろえ、通常モデル、Hyper-Connections、単一ヘッド、MHARを比較しています。損失は最後の5千ステップにおける11回の評価の平均であり、それ自体は複数乱数シードの平均ではありません。
通常モデル/単一ヘッド/MHARの損失は、100Mで3.031/2.970/2.969、350Mで2.997/2.876/2.848、1Bで2.894/2.759/2.754です。350Mでは通常モデルとの差が0.149である一方、単一ヘッドとの差は0.028です。改善全体をヘッド分割だけの効果と捉えることはできません。
なお、論文の付録Hには、別の実験条件の下でFineWeb-Eduを用いた3シードの頑健性検証もあります。この追加検証と主要表の評価平均は区別すべきであり、あらゆる環境での再現性が確認されたという意味ではありません。
下流タスクの結果は一様ではない
1Bでは通常モデルからMHARへの変更により、WikiText-2のperplexityが56.4から45.4へ低下し、LAMBADA正解率が8.8%から16.0%へ上昇しています。一方、100MのHellaSwagは35.0%から33.0%へ低下しました。論文は200例の評価に約±3ポイントの標本変動があることも示しています。規模ごとに文脈長も異なるため、まず同一規模内で比較する必要があります。
学習済み8Bモデルへの導入
Marin-8Bの追加事前学習では、既存の残差ストリームを維持し、デルタをルーティングする加算分岐を設けます。出力ゲートを0で初期化することで変換直後の計算を保ち、fp32での初期最大ロジット差は0と報告されています。ゲートの学習に伴い、新たな経路が寄与します。
32層を4層ずつまとめた8個のブロックデルタと学習可能なnull情報源を使い、最大9個の情報源を8ヘッドで読み出します。過去の全サブレイヤー出力を保持する方式とは異なります。データプールは約1.9兆トークンですが、実際の追加学習量は約100億トークンです。通常の追加事前学習(Plain CPT)と日程、データ順序、バッチをそろえて比較しています。
追加学習自体の効果とMHARの寄与
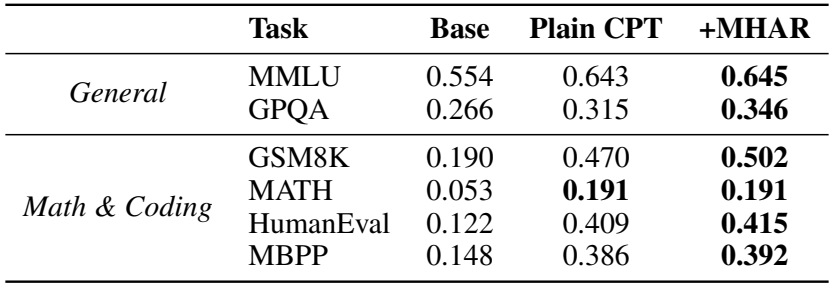
GSM8K正解率は元モデル19.0%、Plain CPT 47.0%、MHAR 50.2%であり、MHARの追加改善は3.2ポイントです。GPQAはPlain CPTの31.5%から34.6%へ3.1ポイント上昇しています。元モデルからの改善の大部分には、追加学習自体の効果が含まれます。
MATHはいずれも19.1%で、MMLU、HumanEval、MBPPの差も統計的に明確とはされていません。対応のある検定ではGSM8Kがp=0.004、GPQAがp=0.038ですが、すべての運用条件で複数シードによる反復検証を行ったことにはなりません。
ヘッド数は多いほどよいのか
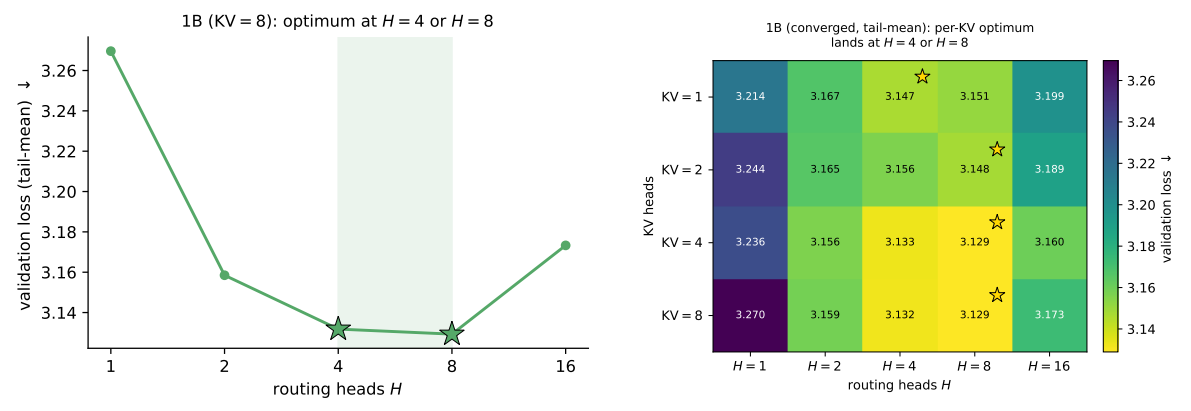
KVヘッドを8個に固定した1Bのウェブコーパス実験では、ルーティングヘッド1・4・8・16個に対する損失が3.270・3.132・3.129・3.173でした。4個と8個はほぼ同等で、16個では悪化しています。分割が少なすぎると異なる選好を共通化し、多すぎると一緒に扱うべき特徴まで分離する可能性があります。
8個が普遍的な最適値というわけではありません。モデル幅、学習段階、データにより適切な分割は変わります。また、この実験は主要実験と初期化条件も異なるため、差をデータ分布だけの効果として説明することはできません。
演算数だけでは見えないメモリ移動
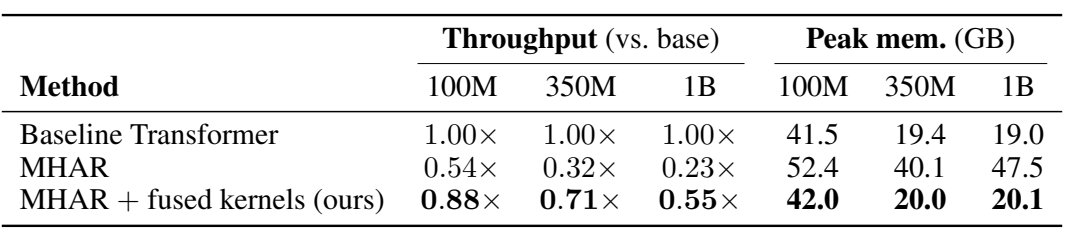
同規模の通常モデルの処理量を1.00とすると、一般実装のMHARは100M/350M/1Bで0.54/0.32/0.23、融合カーネルでは0.88/0.71/0.55です。融合により反復アクセスと中間保存は減りますが、学習全体の速度は依然として通常モデルを下回ります。
1Bのピークメモリは融合により47.5GBから20.1GBへ減り、通常モデルの19.0GBに近づきました。ただし処理量は通常モデルの55%です。単一カーネルの高速化率をモデル全体の高速化率と混同してはいけません。同じステップ数の比較は、同じ実時間予算での優位を示すものでもありません。
確認された範囲と残る課題
MHARは新規モデルの設計と既存モデルの追加学習の双方に選択肢を示します。ただし、主要な証拠は英語データと特定の構造・規模に関するものです。韓国語モデル、マルチモーダル、長文脈サービス、実運用の推論遅延やコストへの効果まで直接導くことはできません。
今後の確認では、対象条件でのシード反復、同一実時間または総計算予算での比較、データと初期化の影響の分離、推論時のメモリ・遅延計測が有用です。学習指標の改善を、そのまま利用者への応答高速化の証拠として扱うべきではありません。
構成と効果を結び付ける特許実務上の見方
技術的課題は単なる精度向上より具体的です。共通の深さ分布では部分空間ごとの情報要求を十分に表せず、反復参照にはメモリ負荷もあります。特徴を対応させて分割し、情報源方向に独立して正規化し、加重集約後に再結合する関係が中心となります。
融合実行は中間テンソルとメモリアクセスを抑えます。ブロックデルタと0初期化ゲートは、情報源数と学習済みモデルの初期動作の維持に対応します。異なる実装上の課題を扱う構成であり、一括して性能向上と説明すべきではありません。
通常の残差接続に対しては過去出力の個別選択、単一ヘッド方式に対しては部分空間別の選択、トークン注意に対しては深さ方向の情報源という違いがあります。技術的効果は、これらの関係と実際の比較条件に結び付けて説明する必要があります。本稿は論文の技術的貢献の分析であり、特許性や権利取得の成否を判断するものではありません。
結び
MHARは、計算済みの情報を誰が、どこから、どの割合で読むかを再設計します。部分空間ごとの選択、学習済み計算の維持、実際のメモリ移動コストを併せて考えることが、その貢献を理解する要点です。有望な情報経路が、直ちに高速な実装を保証するわけではありません。
原図の表記と形状を保持しています。内容は本文で説明しています。