
何を記憶し、何を弱めるか
長い対話では過去の情報を保持する必要がありますが、すべての特徴を同じ強さで残すことが常に有効とは限りません。FiXは、過去のトークンを構成する各成分が現在の出力に寄与する程度を調整します。本稿は研究論文の技術的検討であり、IPLEX又は顧客の特許取得実績を紹介するものではありません。
対象論文はRunzhong Li、Renjie Liu、Qing Li、Bo TangによるFiX: Introducing Fine-grained Forget Gate into Softmax Attentionです。ICML 2026論文集のPMLR第306巻68619–68640頁に収録され、識別子はpmlr-v306-li26dlです。学会開催日は2026年7月6~11日。所属は南方科技大学と香港理工大学で、Renjie LiuにはAlayaDBでのインターンシップに関する注記があります。公式記録にDOI又はarXiv番号は掲載されていません。論文及び研究図表は著者らの成果であり、CC BY 4.0に基づき出典を明示しています。
スカラーゲートでは制御単位が粗い
注意機構はクエリQとキーKを比較して重みを求め、対応する値Vを合成して出力Oを得ます。参照先の選択と、そこから運ぶ情報の選択は別の処理です。FoXは文脈に応じた忘却を導入しますが、スカラーゲートのため、あるヘッド内の過去トークンの各特徴には同じ減衰率が適用されます。
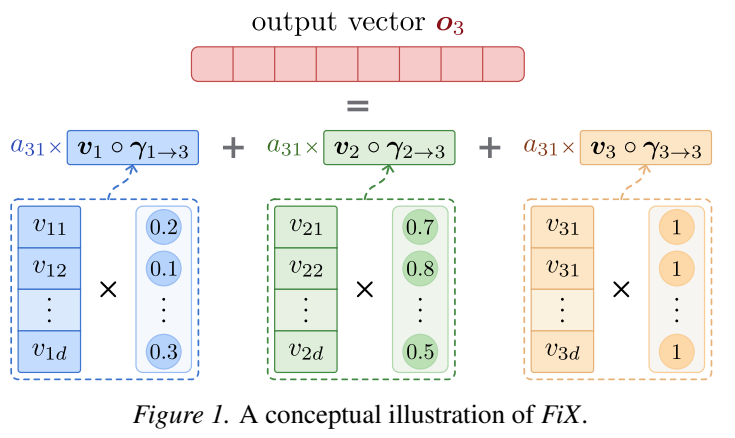
QとKの内積はスカラーであり、そこへベクトルのゲートをそのまま加えることはできません。FiXは忘却の適用先を値・出力経路へ移し、累積ゲートを値ベクトルに成分ごとに乗じます。同じトークンでも長く残る特徴と早く弱まる特徴を分けられます。Figure 1の0.2、0.1、0.3等は動作説明用の値で、正解率ではありません。現在のトークンについては累積積が空積となり、値は1です。
RMSNormとRoPEの位置付け
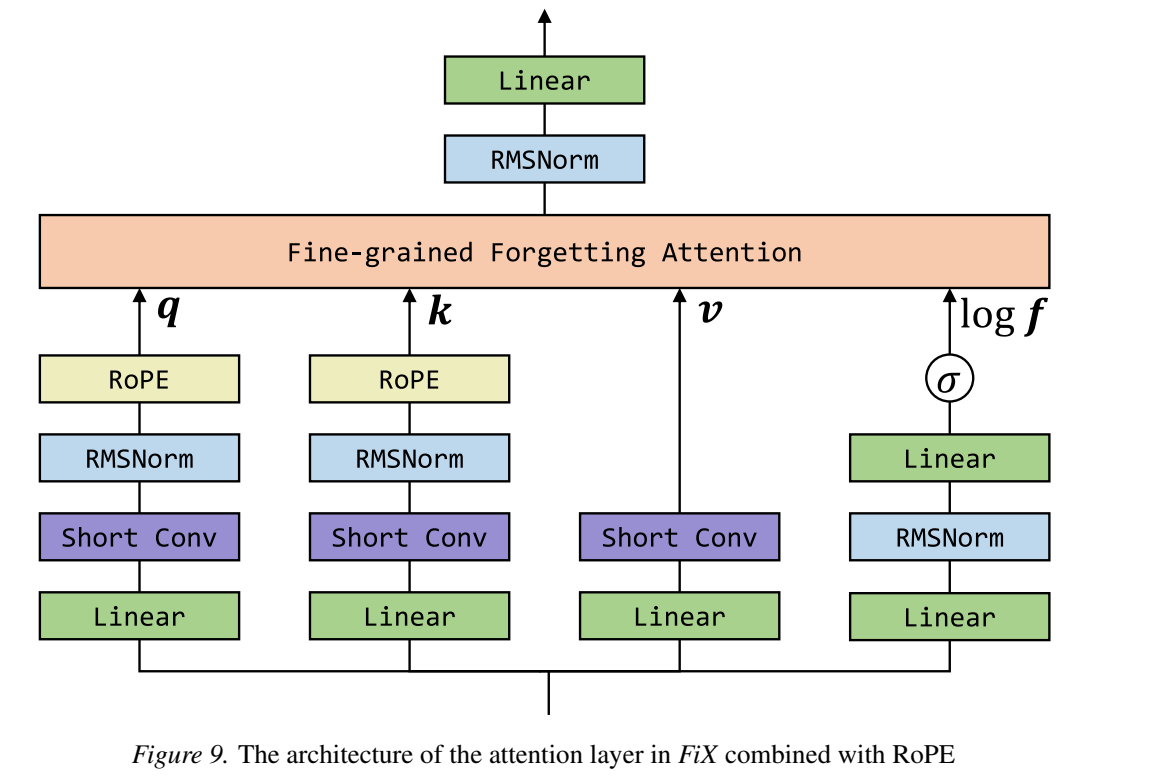
この変換を支えるのが出力後のRMSNormです。理想的なRMSNormでは全体に共通する正の倍率が相殺されるため、スカラー忘却を注意スコア側から値・出力側へ移すことができ、その経路を特徴ごとのゲートに拡張します。等価性が厳密に成立するのは安定化定数εが0の場合です。FiXは出力正規化にε=10⁻³⁰を用います。実際の計算にはソフトマックスが残っており、すべてのトランスフォーマーで不要になるという意味ではありません。
入力からQ、K、Vとゲートを生成し、通常の層では中間次元128の低ランク投影で追加パラメータを抑えます。併用時のRoPEはQ・K経路で位置情報を表現します。一方、累積ゲートはVに作用し、重み付き和をRMSNormと線形変換へ渡します。この役割分担によりFiXとRoPEを併用できます。
第1層では通常のゲート投影により勾配が不安定になったため、トークンIDに対応する学習可能なゲート埋め込みを用います。活性化関数はMamba方式です。小さいε、第1層の埋め込み又はこの活性化関数を変更したアブレーションでは、完成形より学習損失が増えました。
数式を安定した計算に落とし込む
0から1のゲートを長区間で乗じると累積値が極めて小さくなります。その値でVを直接割ると数値が過大になります。他方、位置ごとに個別計算すればGPUの行列積を十分に活用できません。
Flash Fine-grained Attentionは、ブロックの基準点を用いて累積ゲートの比を1以下に保つ再スケーリングと、FlashAttention型のタイル処理を組み合わせます。過去ブロックの多くを行列積で処理し、対角ブロックは別に扱います。さらに注意計算、RMSNorm、後続の線形層を融合し、精度が重要な計算をfloat32で維持します。ゲートを一つ加えるだけで再現できる構成ではありません。
Paged VF Cacheのメモリ負担
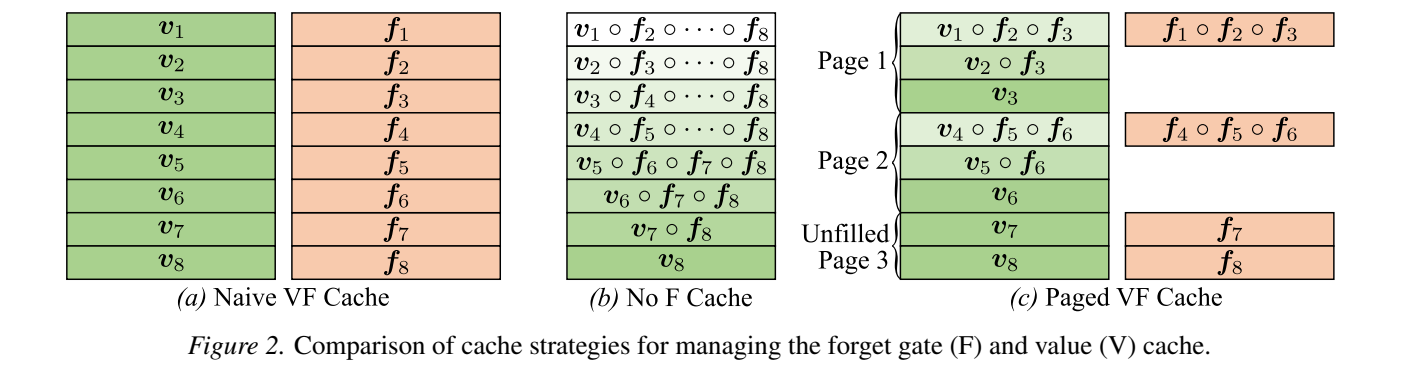
通常の自己回帰生成では過去のKとVを保持しますが、FiXではゲートFも必要です。論文の精度条件でFをすべてfloat32で保存すると、既存KVキャッシュとほぼ同量の追加領域を要します。生成のたびにFをVへ吸収する方法は別のF領域を減らせる一方、過去V全体の読み書きと精度変換の誤差蓄積を招きます。
Paged VF Cacheはトークンをページにまとめます。ページが埋まると内部の累積ゲートをVへ吸収して値を固定し、代表するゲート積のみを残します。未充填ページではVとFを別に保持します。Figure 2のページサイズ3は説明用であり、実用設定として述べられる値は16です。
追加ゲート領域は標準KVキャッシュのおよそ1/pです。p=16なら約6.25%の追加領域に相当しますが、GPU全体のメモリが6.25%減るという意味ではありません。ページ管理により、デコードの各ステップで過去の値すべてを更新する必要も抑えます。
実験条件をそろえて読む
主要実験は約7億6千万パラメータのモデルをFineWeb-Eduの480億トークンで学習したものです。アブレーションでは約3億4千万パラメータ、100億トークンを用います。比較対象はRoPE、FoX、FoX-RoPE、FiX、FiX-RoPEで、SwiGLU、QK-Norm、出力正規化、Short-Conv等を含む共通構造に基づきます。
低ランクのゲート投影だけでも約800万~1,000万パラメータが加わり、第1層のゲート埋め込みも別途存在します。FiXの学習損失はRoPE、FoX、FoX-RoPEより低く、FiX-RoPEではさらに改善します。ただし学習損失の順位と各評価課題の順位は一致しません。
正解率の改善幅と例外
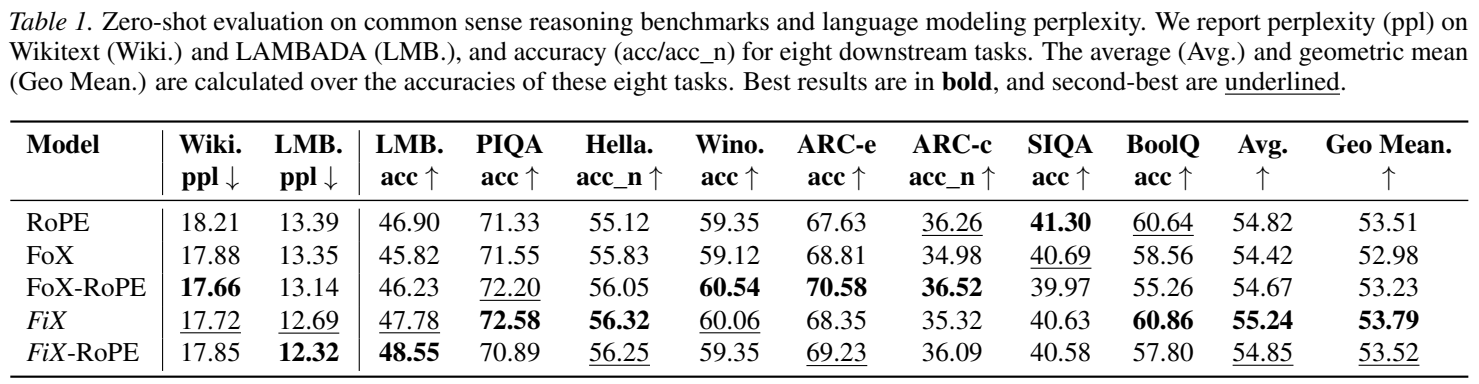
Table 1の正解率8課題の算術平均は、RoPEが54.82%、FoXが54.42%、FoX-RoPEが54.67%、FiXが55.24%、FiX-RoPEが54.85%です。FiXとRoPEの差は0.42ポイントです。2項目のパープレキシティは正解率の算術平均・幾何平均に含まれません。
FiXはPIQA 72.58%、HellaSwag 56.32%、BoolQ 60.86%で最高値でした。一方、ARC-easyとARC-challengeはFoX-RoPEが上回り、Wikitextのパープレキシティも同モデルが最低です。FiX-RoPEはLAMBADAで良好でしたが、平均正解率ではFiXに及びません。報告条件下の穏やかな改善を、全課題にわたる飛躍的向上と扱うべきではありません。
長文への対応と推論の難しさは別問題
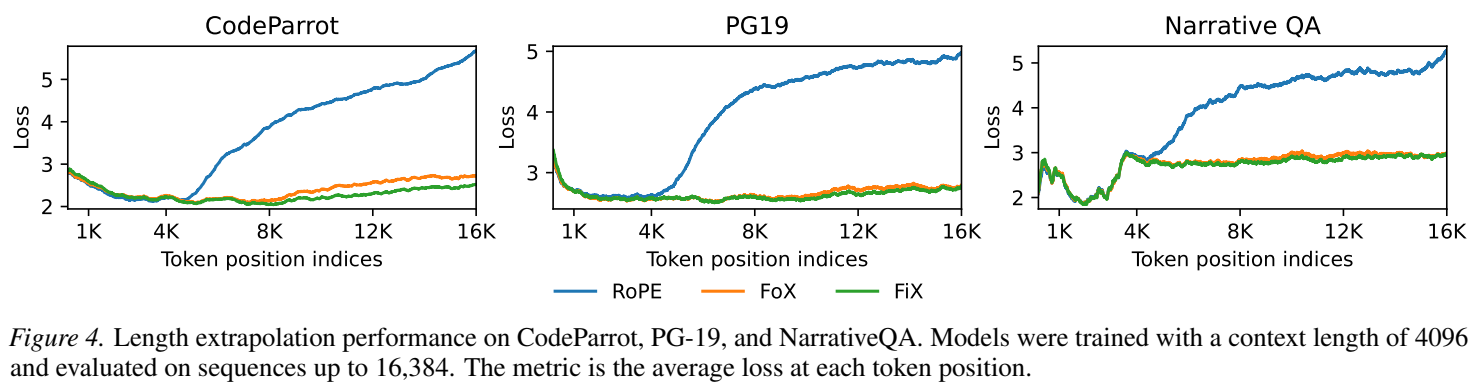
4,096トークンで学習したモデルを、追加微調整なしで16,384トークンまでCodeParrot、PG-19、NarrativeQAで評価しています。対象RoPEモデルは学習長を超えると予測損失が増え、FoXとFiXは比較的安定し、FiXがやや優位でした。この実験ではRoPE併用の2変種を比較していません。すべてのRoPEモデルや他の長さ拡張手法が劣るとの結論ではありません。
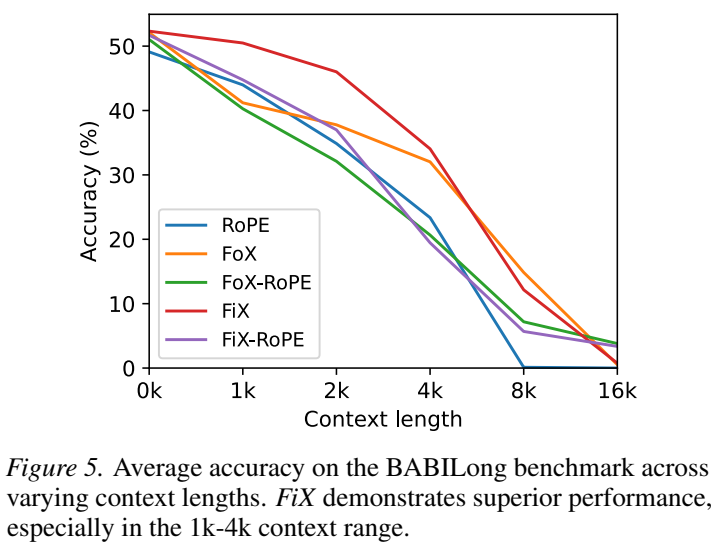
BABILongは長文内に分散する事実への質問応答を測定します。5課題の平均でFiXは特に1k~4kで良好ですが、8k・16kでは大きく低下します。次トークン予測の安定性と長文推論の成功は異なる指標であり、混同できません。
適用範囲と弁理士の技術分析
FiXは注意層の構造を変えて学習する方式で、稼働中のモデルの設定を一つ切り替えるだけの方法ではありません。過去トークンとの注意計算は残り、ブロック処理によって相互作用が線形時間になるわけでもKVキャッシュが不要になるわけでもありません。ゲート計算と精度管理にも負担があります。
主な検証規模は約7億6千万パラメータです。大規模化、他の学習データ、実運用の処理量や遅延で効果が維持されるかは別途検証を要します。主要表の小さい差には反復実験の誤差棒や信頼区間が示されておらず、普遍的な優劣に広げることはできません。
特許実務の技術分析では、V・O経路の特徴単位累積ゲート、極小εの出力正規化、第1層の埋め込み、ブロック再スケーリング、精度を保つ融合演算、ページ型保存を一体として把握する必要があります。ゲートの有無より、適用位置、制御粒度、正規化及び記憶構造との関係が重要です。実験効果は技術的検討の資料であり、それだけで新規性・進歩性又は特許性が決まるものではありません。
FiXから読み取れること
FiXはソフトマックス注意機構を維持しながら、保持する情報を特徴単位で選ぶ具体的な構成を示しています。数式の変換に伴う問題を、実装とキャッシュ設計までつなげて解決しようとする点が特徴です。中規模モデルでの成果と長文課題の限界を併せて捉え、規模拡大時の再現性と処理費用を確認することが次の論点になります。
原図の表記と形状を保持しています。内容は本文で説明しています。