아래 기사에서 확인할 수 있듯이 인공지능은 장비 고장 예측에서도 활용 가능하다.
[미래형 제조업] ‘1시간 후 고장납니다’…“AI 예측 덕에 큰 사고 막았죠”
박스를 클릭하면 신문 기사 화면으로 연결됩니다.
보통 고장 예측을 수행하기 위해서는 산업 설비에 설치된 센서로부터 획득된 데이터가 필요하다. 센서에서 획득된 데이터를 분석해서 장비의 고장을 예측할 수 있는데 이를 Anomaly detection(이상 탐지)이라고 한다. 본 포스팅에서는 Anomaly detection(이상 탐지)에 대해서 설명하고자 한다.
[Anomaly detection]
Anomaly Detection은 정상과 비정상(또는 이상치, 특이치)을 구별해내는 것을 의미한다.
당소의 고객사를 중심으로 어느 분야에서 Anomaly detection이 사용되는지 설명하면, 수아랩이나 마키나락스가 다루고 있는 제조업 분야에서는 제조 장비의 고장(이상)을 예측할 때 Anomaly detection을 사용한다. 즉, 제조 장비에 설치된 센서에서 센싱 된 데이터를 분석해서 고장을 예측할 수 있는 것이다. 뿐만 아니라 뷰노가 다루고 있는 의료 영상 분석 분야에서는 악성 종양을 검출하는데 Anomaly detection이 사용될 수 있다.
이렇듯 다양한 분야에서 anomaly detection이 이용되는 것을 확인할 수 있다.
[Anomaly detection을 위한 학습 방법]
Anomaly detection 모델을 학습시키는 방법은 다양하다. Supervised Learning(교사 학습), Semi-supervised Learning(반교사 학습), Unsupervised Learning(비교사 학습)과 같이 다양한 방법을 통해서 Anomaly detection 모델을 학습시킬 수 있다.
- 교사 학습 (Supervised Learning)
교사 학습 포스팅 링크
교사 학습에 대한 내용은 이전 포스팅에서 설명한 적이 있다. 이번에는 Anomaly detection을 수행하기 위한 교사 학습 방법을 살펴보자.
학습용 데이터 셋이 있으면 모델 설계자는 정상과 관련된 데이터와 비정상과 관련된 데이터를 구분해서 학습용 데이터 셋에 라벨을 달아야 하는데, 이를 라벨링이라고 한다.
일반적으로 교사 학습은 다른 학습 방법에 비해서 정확도가 높은 특징이 있다. 그래서 정확도가 요구되는 경우에는 교사 학습을 많이 이용한다. 하지만, Anomaly detection이 적용되는 일반적인 산업 현장에서는 정상 상태에서 측정되는 데이터의 양이 비정상 상태에서 측정되는 데이터의 양보다 많다. 즉, 정상으로 라벨링 된 데이터양이 너무 많게 되는 Class-Imbalance(불균형)의 문제가 발생하게 된다. 이렇게 Class-Imbalance의 문제가 발생하는 경우 Anomaly detection의 정확도는 떨어진다. 균형 있게 데이터를 확보할 수 없기 때문에 교사 학습을 통해 모델을 학습시키는 것은 문제가 있다.
- 반교사 학습(Semi-supervised Learning)
앞서 설명한 바와 같이, 교사 학습을 통한 Anomaly detection 모델을 학습시킬 때 가장 큰 문제는 비정상 상태와 관련된 데이터를 확보하기 어렵다는 것이다.
제조업의 경우 수백만의 정상 데이터를 취득하는 동안 단 한 번 비정상 데이터가 취득되는 상황이 종종 발생하기 때문이다. 이처럼 Class-Imbalance(불균형)가 심한 경우에 정상 상태와 관련된 데이터만 이용해서 모델을 학습시키는 One-Class Classification(또는 Semi-Supervised Learning)이 사용된다.
서포트 벡터 머신(SVM) 등을 이용하여 정상 상태와 관련된 데이터의 경계선을 결정하고, 결정된 경계선 밖의 데이터들은 전부 비정상으로 보는 학습 방법이다.
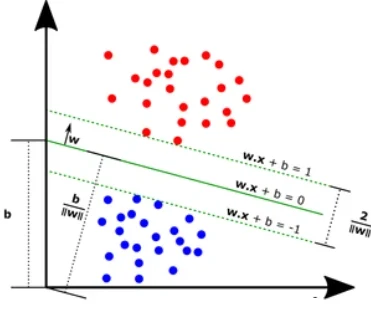
Support Vector Machine
이는 정확도가 다소 떨어질 수 있는 방법이긴 하지만, 불균형 데이터를 가지고 모델을 학습시킬 때 효과적이다.
- 비교사 학습(Unsupervised Learning)
반교사 학습에서 설명한 방식은 정상 데이터에 대한 라벨을 확보하는 과정이 필요한데 비교사 학습은 획득된 데이터가 정상 데이터라고 가정하고 라벨 취득 없이 학습을 수행하는 방법이다. 대표적으로 오토인코더를 이용하는 경우 비교사 학습이 가능하다
- 오토인코더(Autoencoder)
- 이해를 돕기 위해 내용을 약간 수정하여, 실제 오토인코더와 차이가 있을 수 있다.
오토인코더는 입력된 데이터를 압축시키는 과정과 압축된 데이터를 복원시키는 과정을 수행하게 된다.
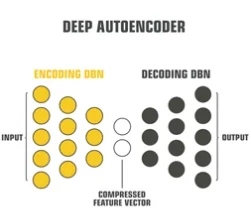
구체적으로, 오토인코더는 입력을 latent variable(Compressed feature)로 압축하는 인코더(Encoding DBN)와 latent variable을 원 데이터로 복원시키는 디코더(Decoding DBN)로 구성된다. 오토인코더를 이용하게 되면, 데이터 라벨링 없이 데이터의 주성분이 되는 정상 상태의 특징을 배우게 된다.
한편, 학습이 완료된 오토인코더에 정상 상태 데이터를 입력(Input)으로 넣어주게 되면 입력된 데이터와 동일한 데이터가 디코더에서 출력(Output) 된다.
그럼 반대로 비정상 상태 데이터가 오토인코더에 입력으로 들어가면 어떻게 될까?
오토인코더의 인코더와 디코더는 정상 상태 데이터로 학습이 되었기 때문에 비정상 상태 데이터가 입력되면 오토인코더는 제대로 압축 및 복원을 해내지 못한다. 따라서, 디코더에서 출력되는 최종 출력 데이터는 입력 데이터와 달라지게 되는 것이다.
결과적으로, 오토인코더에 입력된 입력 데이터(x)와 오토인코더에서 최종 출력된 출력 데이터(x')의 차이(Diff)가 얼마만큼 나는지를 확인해서 입력된 데이터가 정상 상태와 관련된 데이터인지 아니면 비정상 상태와 관련된 데이터인지 알 수 있게 된다.
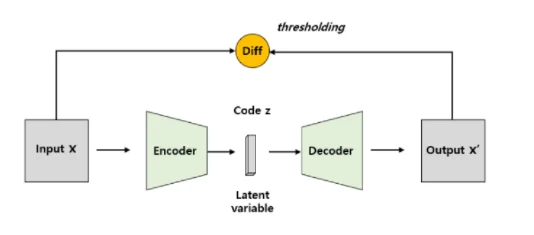
출처: Improving unsupervised defect sementation by applying structural similarity to autoencoder, 2019, arXiv
- 오토인코더를 활용한 특허
오토인코더를 이용해서 제조설비의 Anomaly detection을 수행하는 방법과 관련된 마키나락스의 특허를 하나 살펴보자.
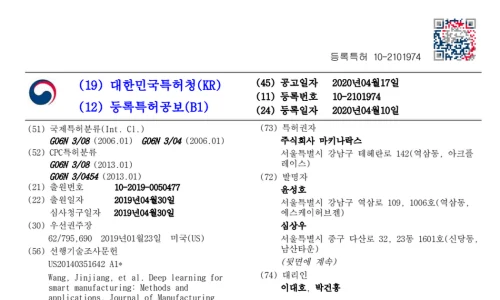
이미지를 클릭하면 등록특허공보 전문을 확인할 수 있다.
정상 상태 데이터는 제조 레시피마다 다른 패턴을 갖게 된다. 제조 레시피마다 다른 오토인코더를 학습시켜야 하는 것이 종래 기술의 한계였다. 그렇게 되면 수많은 제조 레시피의 데이터들 각각을 이용해서 복수 개의 오토인코더를 학습시키면 시간적으로나 비용적으로 손해일 수밖에 없다.
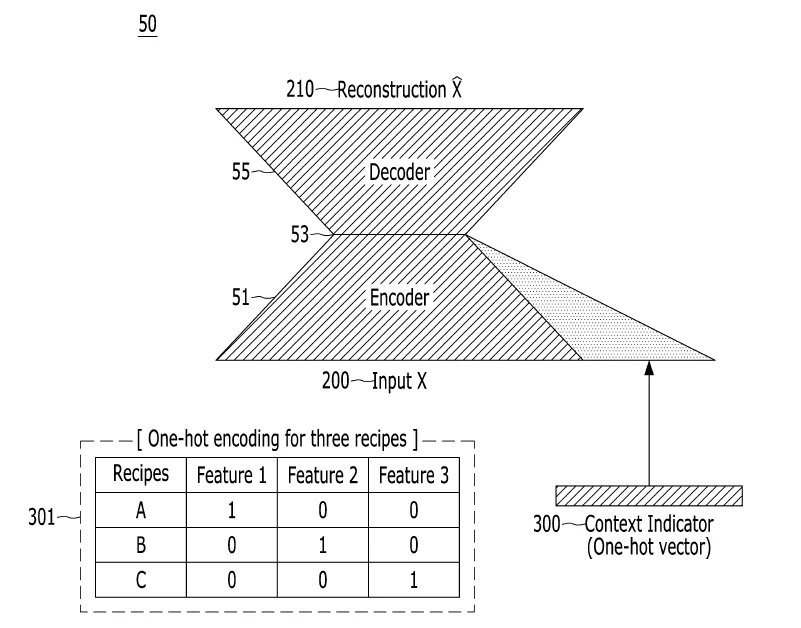
마키나락스는 이러한 문제를 해결하기 위해 오토인코더를 학습시킬 때, 제조 레시피에 대한 인자를 센싱 데이터와 함께 오토인코더에 입력하는 것을 제안했다. 구체적으로, 현재 어느 제조 레시피에서 센싱 된 센싱 데이터인지를 나타내는 feature 값(context indicator)을 센싱 데이터와 함께 오토인코더에 입력해 준다. 오토인코더는 입력으로 들어간 센싱 데이터와 동일한 데이터가 디코더에서 출력되도록 학습된다. 이렇게 학습시키면 하나의 오토인코더로 다양한 제조 레시피 데이터의 정상과 비정상을 판별할 수 있게 된다.구체적으로, 제조 레시피를 나타내는 값(Context Indicator)과 센싱 데이터(X)를 학습이 완료된 오토인코더의 입력으로 넣어주고, 출력된 값(X’)과 입력으로 사용했던 센싱 데이터(X) 사이의 차이 값을 산출한다. 만약 그 차이 값이 기 설정된 값 미만이면 정상으로 판별하고 그 차이 값이 기 설정된 값 이상이면 비정상으로 판별하게 된다.
보통 특허 출원을 위한 아이디어를 창출할 때 다음과 같은 방법을 많이 이용한다.
종래 기술(오토인코더)을 어느 특정 분야(제조업 분야)에 사용하는 경우 발생하는 문제점(제조 레시피마다 별개의 오토 인코더를 생성해야 하는 문제점)은 어떤 것이 있고, 이러한 문제점을 해결하기 위해 종래 기술(오토인코더)을 어떻게 변형하면 좋은지를 고민하는 방향(제조 레시피에 대한 정보를 같이 입력으로 넣어줌)으로 아이디어 창출을 많이 한다. 이런 방향으로 아이디어 창출을 한 후에 특허 출원을 하는 경우 특허 등록률이 상당히 높아지게 된다.
이 글은 표시된 게시일을 기준으로 작성된 자료입니다. 개별 사안에 대한 검토는 상담을 통해 안내합니다.