
Как вы можете видеть в статье ниже, ИИ также может быть использован для прогнозирования отказа оборудования.
"Это произойдет через час из-за прогноза.
Нажмите на коробку, чтобы подключиться к экрану газетной статьи.
Обычно для выполнения прогнозирования неисправностей требуются данные, полученные от датчиков, установленных в промышленных установках. Данные, полученные от датчика, могут быть проанализированы для прогнозирования выхода из строя оборудования, что называется обнаружением аномалий. В этой статье мы поговорим об обнаружении аномалий.
[Обнаружение аномалий]
Обнаружение аномалий относится к различению между нормальным и аномальным (или выбросами, сингулярностями).Я знаю.
Обнаружение аномалий используется для прогнозирования неисправности производственного оборудования (или позже) в производственном секторе, где обнаружение аномалий используется, главным образом, нашими клиентами. Это означает, что датчик, установленный в производственном оборудовании, может анализировать полученные данные и прогнозировать сбои. Кроме того, в области медицинского анализа изображений, с которым имеет дело Вино, для выявления злокачественных опухолей может быть использовано обнаружение аномалий.
Обнаружение аномалий может быть использовано во многих областях.
[Обучение методам обнаружения аномалий]
Существует множество способов изучения модели обнаружения аномалий. Обучение с учителем, обучение с частичным привлечением учителя и обучение без учителяВы можете изучить модель обнаружения аномалий различными способами.
- Обучение с учителем (Supervised Learning)
Преподавательский пост Ссылка
Объяснил это своему учителю в предыдущем посте. Давайте посмотрим, как выполнить обнаружение аномалий.
С набором данных обучения разработчик модели должен пометить набор данных обучения, различая нормальные и ненормальные данные, которые называются маркировками.
Обучение с учителем часто позволяет добиться высокой точности и применяется, когда этот показатель особенно важен. Однако при обнаружении промышленных аномалий данных о нормальной работе обычно значительно больше, чем об аварийных состояниях. Иными словами, Проблема классового дисбаланса приводит к слишком большому количеству обычно помеченных объемов данных. В случае проблемы классового дисбаланса точность обнаружения аномалий снижается.Поскольку сбалансированный набор данных получить трудно, возникают сложности при обучении модели с учителем.
- Полуобучение с учителем
Как отмечалось выше, основная трудность обучения с учителем для обнаружения аномалий — нехватка данных об аномальных состояниях.
В обрабатывающей промышленности часто бывает так, что только одна ненормальная информация получается во время приобретения миллионов нормальных данных. Одноклассная классификация (или полуобучение с учителем) используется для обучения модели с использованием данных, связанных с ее нормальным состоянием, когда классовый дисбаланс является серьезным.
Используя опорную векторную машину (СВМ) и т.д., для определения границ данных, относящихся к состоянию состояния, данные за пределами определенных границ - все методы обучения, которые считаются ненормальными.
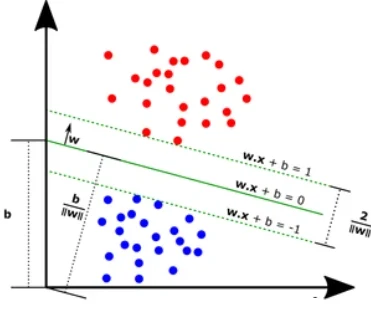
Поддержка векторной машины
Его Это немного менее точно, но это эффективно, когда вы тренируете модели с непропорциональными данными.Так и есть.
- (Обучение без учителя)
При описанном обучении с частичным привлечением учителя требуется разметка нормальных данных. При обучении без учителя предполагается, что полученные данные отражают нормальное состояние, и модель обучается без разметки. Один из примеров такого подхода — использование автоэнкодера.
- Posts Tagged ‘Автоэнкодер’
Чтобы помочь вам понять, могут быть различия между фактическим автоэнкодером, слегка изменив контент.
Автокодер выполняет процесс сжатия входных данных и восстановления сжатых данных.
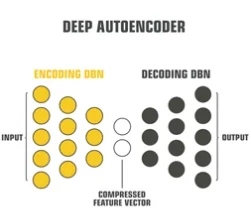
Автоэнкодер включает кодировщик, сжимающий входные данные в латентное представление, и декодировщик, восстанавливающий исходные данные из этого представления. В рассматриваемой архитектуре они обозначены как Encoding DBN и Decoding DBN. Обучение позволяет без ручной разметки выделять признаки нормального состояния, преобладающие в данных.
С другой стороны, если обучающийся автоэнкодер вводится во вход, входные данные и те же данные выводятся из декодера.
Так что же произойдет, если данные попадут в автоэнкодер?
Поскольку кодировщик и декодировщик обучены на данных нормального состояния, аномальные данные могут сжиматься и восстанавливаться хуже. В таком случае выход декодировщика отличается от входных данных, что позволяет выявить аномалию.
В результате, Входные данные (x), введенные в автоэнкодер, и дифференциация конечных выходных данных (x'), проверяются, чтобы увидеть, связаны ли входные данные с нормальным состоянием или с аномальным состоянием..
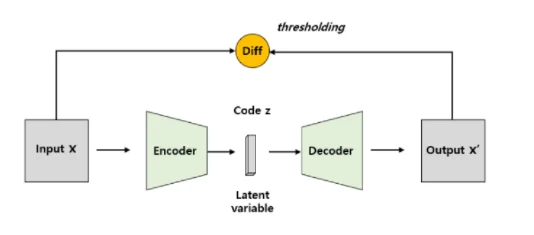
Улучшение неконтролируемой цементации дефектов путем применения структурного сходства с Autoencoder, 2019, arXiv
- Патенты с использованием автоэнкодера
Давайте посмотрим на патент Мачинарака о том, как выполнить обнаружение аномалий на производственном объекте с использованием автоэнкодера.
Если нажать на изображение, то можно увидеть регистрационный патент.
Для разных производственных рецептур характерны разные закономерности нормального состояния. Ограничение прежнего подхода состояло в необходимости обучать отдельный автоэнкодер для каждой рецептуры. Обучение множества моделей на соответствующих наборах данных увеличивало затраты времени и средств.
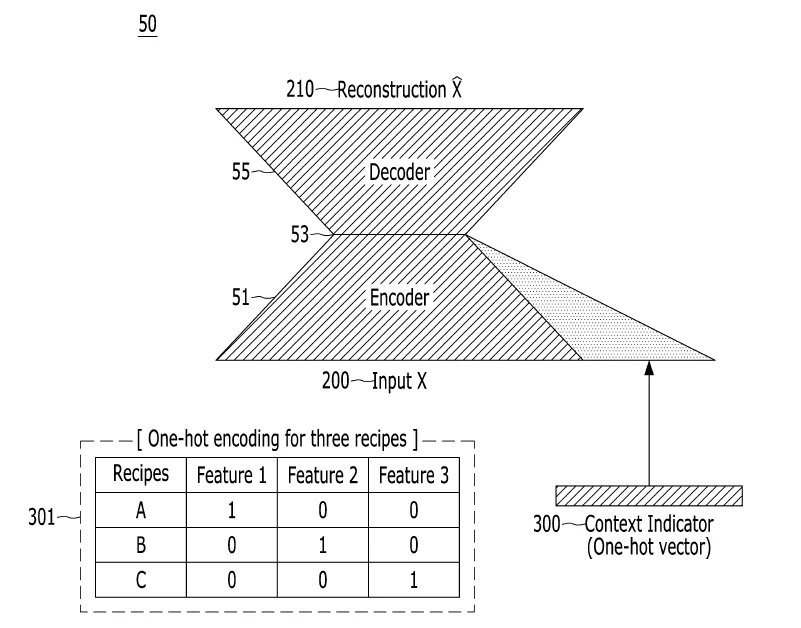
МакКинни решает эти проблемы. При обучении автоэнкодеру введите аргументы для рецепта изготовления в автоэнкодер с данными зондирования.Предлагаю сделать. В частности, значение признака (контекстный индикатор), которое указывает, какие из текущих рецептов изготовления являются данными зондирования, вводится в автоэнкодер с данными зондирования. Автоэнкодер обучается выводить те же данные, что и данные зондирования, введенные во вход. Узнав об этом, один автоэнкодер может определить нормальность и ненормальность различных данных рецептов производства. В частности, контекстный индикатор и данные зондирования (X) помещаются во вход изученного автоэнкодера, и вычисляется разница между выходным значением (X') и данными зондирования (X). Если значение разницы меньше установленного значения, оно обычно определяется, а если разница больше установленного значения, то она определяется ненормально.
Обычно при создании идеи для патентной заявки используются следующие методы:
Проблема использования обычной технологии (авто-кодер) в конкретной области (в области производства) заключается в том, что есть некоторые проблемы (каждый производственный рецепт требует отдельного авто-кодера), и для решения этих проблем мы создаем много идей, думая о том, как модифицировать обычную технологию (авто-кодеры). Если заявка на патент будет подана после того, как идея будет создана в этом направлении, уровень регистрации патента будет значительно выше.
Материал отражает ситуацию на дату публикации. Обратитесь в IPLEX, чтобы обсудить обстоятельства вашего дела.