
Leer menos tokens no garantiza una inferencia rápida si seleccionar esos tokens sigue consumiendo gran parte del tiempo. Latent Sparse Attention (LSA) aborda ese coste: agrupa las claves en un espacio aprendido y utiliza representantes de los grupos para dirigir cada consulta hacia las posiciones relevantes.
D-LSA adapta un modelo existente mediante la destilación del indexador; N-LSA aprende junto con el modelo desde el principio. Este análisis distingue los mecanismos, las mediciones y las limitaciones de ambas variantes, siguiendo la versión del trabajo examinada en el artículo de origen.
Trabajo y versión analizados
El trabajo se titula Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention. Sus autores son Ales Kubicek, Andrea Caciolai, Liangzu Peng, Sukrit Sumant, Benjamin Hoover, Fraser Greenlee, Ruairidh M. Battleday, Radim Urban, Torsten Hoefler y James C. R. Whittington. Urban y Hoefler pertenecen a ETH Zurich; los demás autores indicados, a Prefrontal AI.
Se analiza arXiv:2610.42147v1, presentado el 30 de octubre de 2026, con DOI 10.48550/arXiv.2610.42147 y licencia CC BY 4.0. Es un preprint y no se presenta como una publicación revisada por pares. Se conservan las figuras 3 a 7 y la tabla 3, separando los resultados de los investigadores de la interpretación técnica de este artículo.
El coste que puede quedar oculto en la atención dispersa
La consulta representa la información buscada, la clave aporta una referencia para compararla y el valor contiene la representación que finalmente se lee. En la atención completa, cada consulta se compara con las claves anteriores: el coste del procesamiento inicial o prefill crece, en general, de forma cuadrática con la longitud T. La atención dispersa selecciona posiciones, pero su indexador puede seguir recorriendo todas las claves o todos los bloques consecutivos.
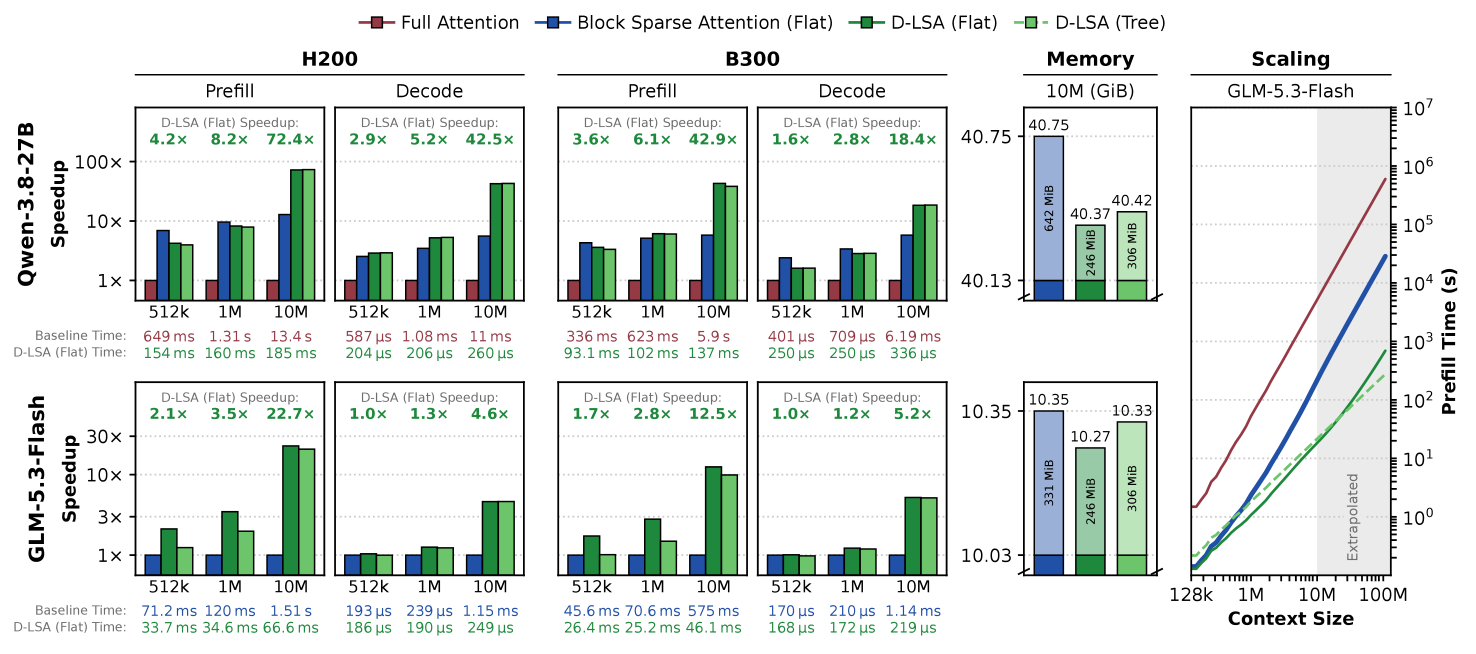
En el experimento de la figura 2, el indexador consumió el 98 % del tiempo de prefill a diez millones de tokens. La medición corresponde a una sola capa de atención global de GLM-5.3-Flash, una H200 y el último bloque de 32.768 consultas. La agrupación «semántica» de LSA utiliza similitud en un espacio vectorial aprendido; no consiste en asignar manualmente etiquetas temáticas.
Encontrar grupos y recuperar las posiciones originales
La configuración principal de D-LSA proyecta las claves a un espacio de indexación de 64 dimensiones y las normaliza. Agrupa cuatro claves consecutivas y fusiona las similares dentro de bloques de 512 tokens. El criterio de Ward favorece la fusión que menos aumenta la dispersión interna. Los grupos finales o buckets contienen ocho claves de media y dieciséis como máximo; los bloques terminados no vuelven a agruparse.
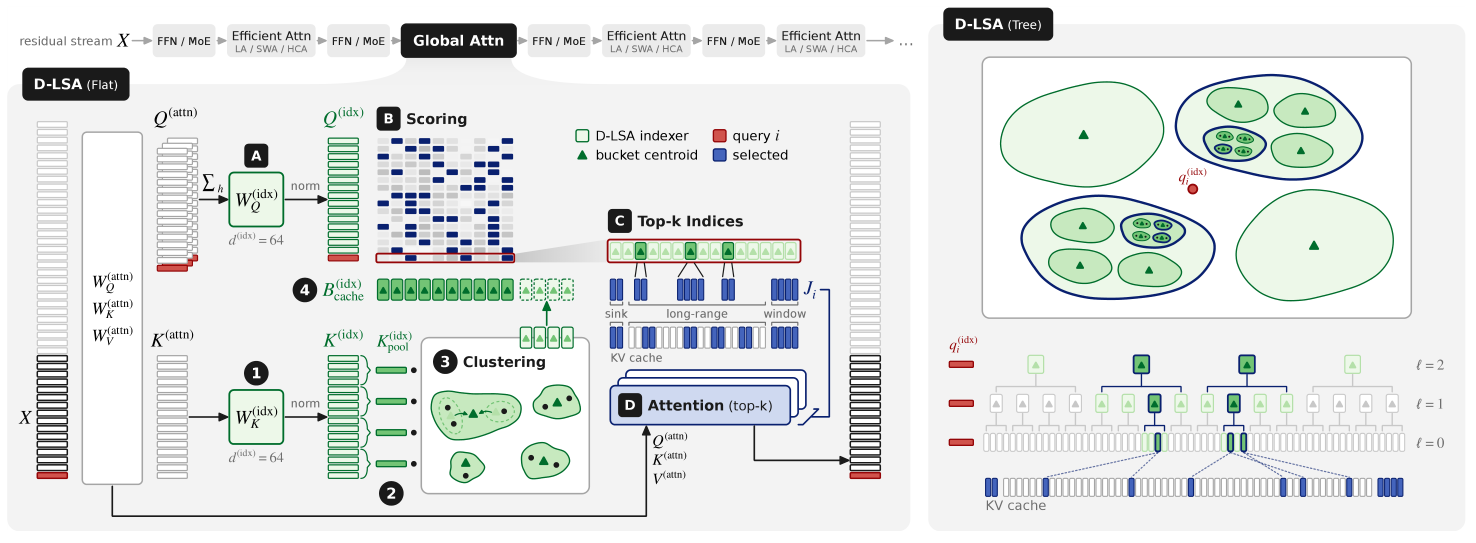
Cada bucket conserva su centroide y una correspondencia con las posiciones originales. La consulta puntúa los centroides, elige grupos prometedores y despliega sus índices para atender a las claves y valores originales dentro de un presupuesto de tokens lejanos. También incluye tokens iniciales de anclaje, llamados sink, y una ventana reciente que cubre el último bloque aún no agrupado. Los centroides sirven para buscar, no para sustituir toda la información en el cálculo final.
Flat puntúa todos los centroides. Con un tamaño de grupo fijo, el trabajo por consulta sigue siendo lineal en T y la indexación del prefill continúa siendo cuadrática en términos asintóticos. Tree añade grupos jerárquicos y una búsqueda en haz que limita los candidatos de cada nivel. Con ese presupuesto constante, se comparan O(log T) centroides por consulta y el prefill pasa a O(T log T). La complejidad subcuadrática debe atribuirse específicamente a este diseño Tree.
Qué aprende D-LSA por destilación
D-LSA mantiene fijo el modelo preentrenado y ajusta pequeñas matrices de proyección de consultas y claves por capa, junto con una temperatura de entrenamiento. La distribución de atención original actúa como señal docente. Durante la destilación se puntúan directamente todas las claves y la agrupación no forma parte del cálculo de la pérdida.
Los autores informan de 352 millones de tokens de entrenamiento procedentes de documentos de 16k a 1M tokens. Por su coste, no realizaron después un entrenamiento de todo el modelo con atención dispersa. Las bases de comparación difieren: Qwen-3.8-27B usa atención completa y GLM-5.3-Flash una atención dispersa previa. La variante Training-Free, basada en direcciones principales sin destilación, debe distinguirse de los resultados principales de D-LSA.
N-LSA aprende con la predicción del siguiente token
N-LSA prescinde de un modelo docente y agrupa las propias claves de atención. Sin añadir proyecciones específicas de indexación, utiliza la mayor similitud entre las cabezas de consulta y cada centroide como puntuación del bucket. Detiene el gradiente en la selección y aprende mediante la atención a las claves seleccionadas, los tokens sink y la ventana reciente. La implementación no requiere una pérdida auxiliar ni parámetros adicionales.
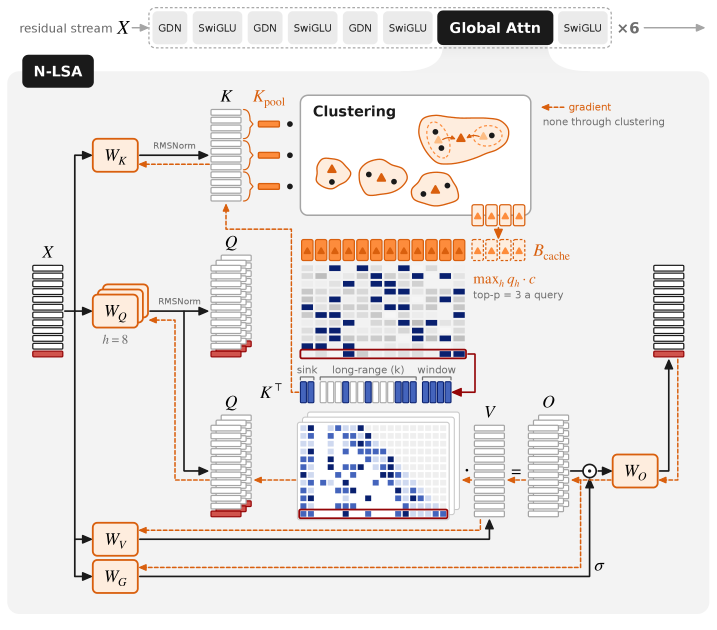
La prueba empleó un modelo híbrido de unos 500 millones de parámetros y 24 capas. Una de cada cuatro capas era de atención y las restantes, Gated DeltaNet. Hubo preentrenamiento con contexto de 4k y una fase de reducción de la tasa de aprendizaje a 128k. N-LSA solo se evaluó con Flat; no se ha demostrado con ello el entrenamiento nativo Tree de modelos grandes.
Tareas de evaluación y extensión del contexto
D-LSA se evaluó con MMLU-Pro, GPQA-Diamond, AIME25, MATH500, LongBench v2 y RULER. El coste del contexto ultralargo motivó el uso de subconjuntos en algunas pruebas. RULER empleó cien instrucciones por tarea hasta 1M tokens y veinte por encima de esa longitud.
PaperTrail inserta pistas fácticas construidas en artículos científicos y exige recuperarlas de uno, conectar dos o seguir cadenas de tres o más artículos. Su puntuación no equivale directamente a capacidad de descubrimiento científico real. El contexto llegó a 10M tokens: Qwen-3.8-27B utilizó extensión YaRN, mientras que GLM-5.3-Flash carece de codificación posicional explícita que requiera ese mismo ajuste. No son pruebas limitadas al contexto originalmente anunciado de cada modelo.
La precisión cambia con la longitud y el tipo de búsqueda
En Qwen-3.8-27B, D-LSA Flat se mantuvo dentro de un margen de cinco puntos de la atención completa hasta 1M. A 10M obtuvo 63,9 frente a 59,9 en RULER y 29,1 frente a 19,8 en PaperTrail. Son observaciones de esas tareas y configuraciones, no una regla general según la cual leer menos mejore la precisión.
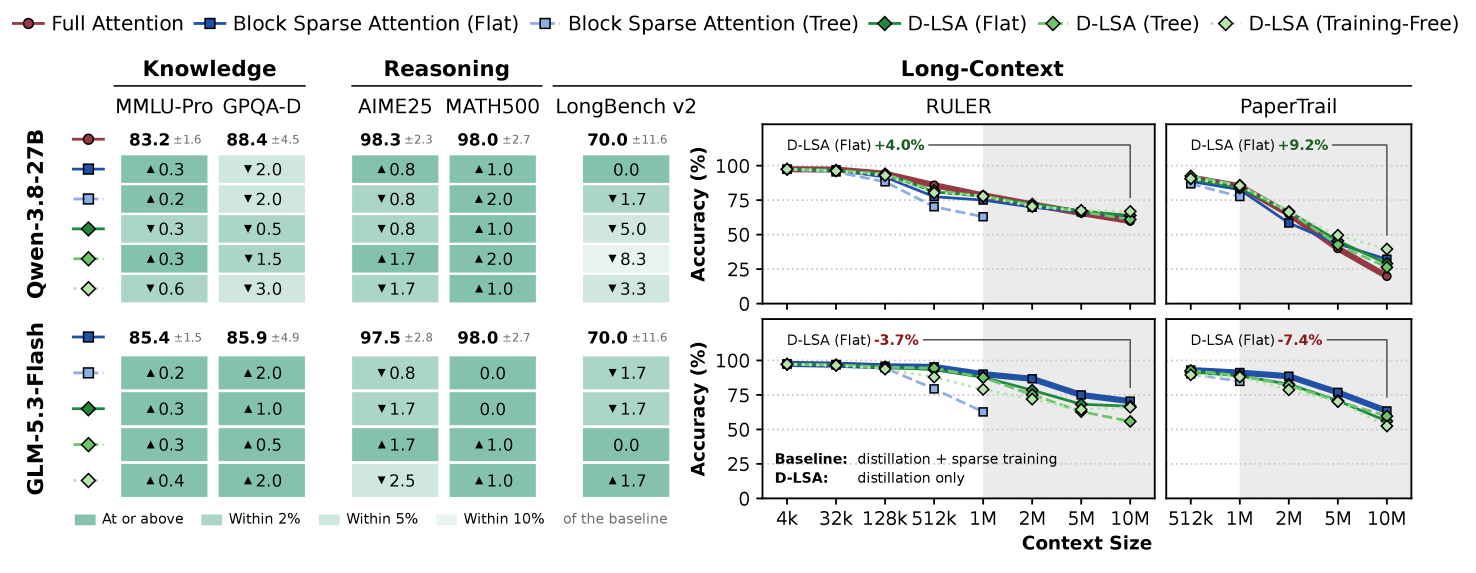
En GLM-5.3-Flash, Flat quedó dentro de un margen de tres puntos de la atención dispersa original hasta 1M, pero perdió hasta ocho entre 2M y 5M. A 10M, la diferencia en RULER no superó los cuatro puntos. Tree obtuvo 55,8 frente a los 66,8 de Flat. Además, ambos modelos encontraron tareas más difíciles al crecer el contexto: igualar una base que también falla no significa resolver satisfactoriamente la tarea.
Velocidad de una capa y latencia del servicio completo
En una H200 a 10M tokens, D-LSA aceleró el prefill y la decodificación de una capa 22,7× y 4,6× frente a la atención dispersa de GLM-5.3-Flash, y 72,4× y 42,5× frente a la atención completa de Qwen-3.8-27B. El prefill midió el último bloque de 32.768 consultas y la decodificación, un paso de una petición. No son factores de aceleración de una petición de extremo a extremo.
Con SGLang, Qwen-3.8-27B D-LSA Flat a 10M en H200 mejoró el tiempo hasta el primer token (TTFT) 9,21× y el tiempo por token de salida (TPOT) 2,87×, con TP8 y DCP8. En la tabla 3, la primera fila de cada bloque presenta tiempos de referencia y las restantes, factores relativos. Deben leerse junto con el hardware y la configuración paralela.
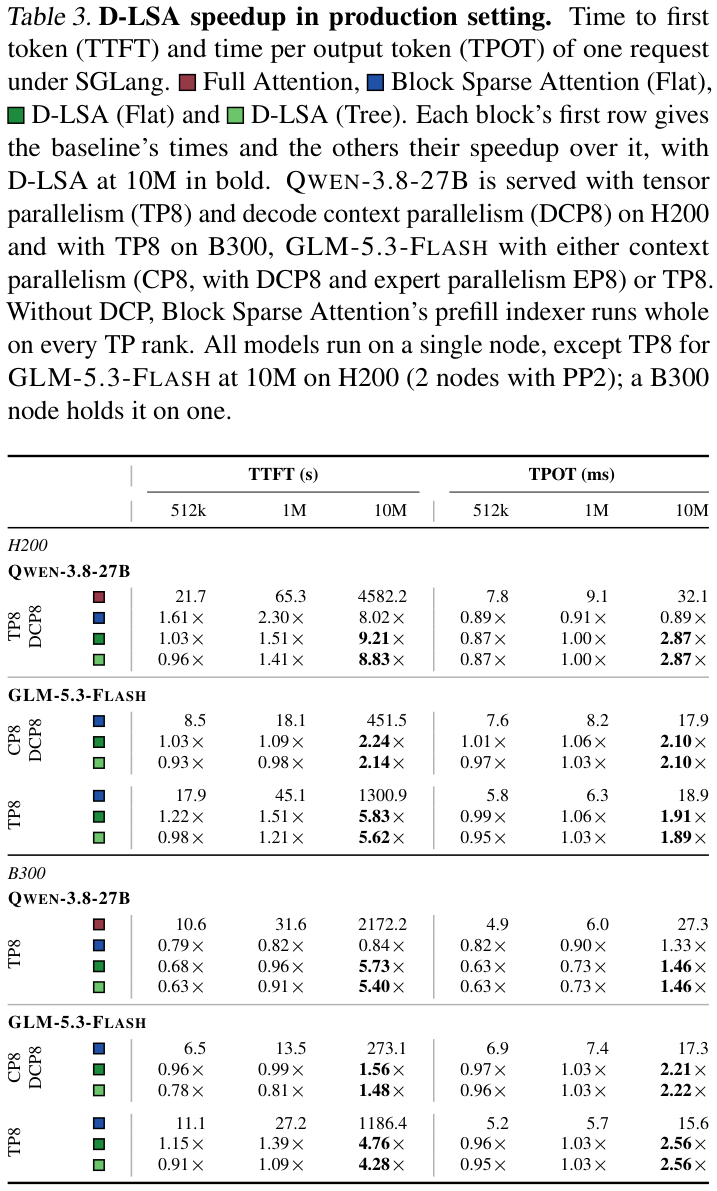
Para GLM-5.3-Flash en H200, CP8 dio mejoras TTFT/TPOT de 2,24×/2,10× y TP8 de 5,83×/1,91×. La configuración H200 de 10M y TP8 indicada utilizó dos nodos con PP2. Con contextos más cortos puede haber retroceso: Qwen-3.8-27B Flat en B300 a 512k obtuvo 0,68× en TTFT y 0,63× en TPOT. Un valor inferior a uno significa mayor lentitud; el coste de seleccionar y agrupar puede superar el ahorro.
Entrenamiento nativo: velocidad a cambio de memoria
A 128k, los pasos hacia delante y hacia atrás de una capa N-LSA fueron 1,6× más rápidos que con atención completa. La fase de reducción de la tasa de aprendizaje del modelo híbrido completo fue 1,24× más rápida con la misma pérdida de validación, 1,085. Solo una de cada cuatro capas usa atención, de ahí la diferencia entre ambas medidas.
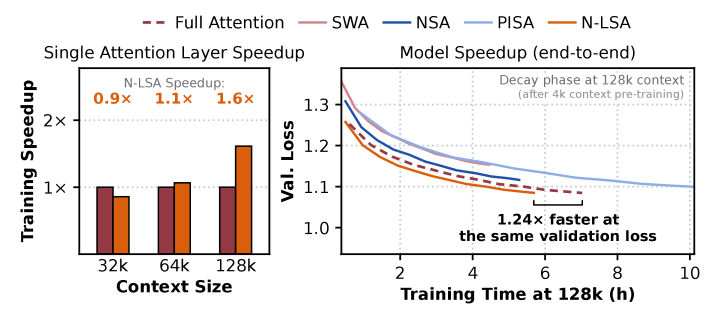
El pico de memoria fue superior: 6,8 GiB por capa con N-LSA frente a 5,8 GiB con atención completa. Conservar los índices seleccionados para la retropropagación contribuye a ese coste. Una mejora de velocidad no demuestra, por sí misma, ahorro de memoria.
Límites de los resultados
LSA reduce el coste de localizar claves, pero no elimina los datos KV originales que deben almacenarse. La caché KV sigue creciendo linealmente con el contexto. La figura 6 extrapola más allá de 10M: los grandes factores proyectados a 100M no son mediciones. Además, en la decodificación de una sola petición aquí evaluada, D-LSA Tree también utilizó búsqueda Flat, por lo que no toda mejora se debe al recorrido del árbol.
La evidencia de N-LSA se limita al modelo de aproximadamente 0,5B, contexto máximo de 128k y búsqueda Flat. Quedan por estudiar modelos mayores, contextos más largos y entrenamiento nativo Tree. El muestreo reducido y la extensión del contexto también impiden trasladar sin más los resultados a la concurrencia, objetivos de latencia y distribución documental de un servicio real.
La contribución técnica desde la práctica de patentes
El problema concreto es el cuello de botella de selección que persiste después de reducir la lectura. Interesa la combinación de espacio aprendido de búsqueda, agrupación en bloques acotados, centroides con mapas de posiciones, selección dependiente de la consulta y retorno a las claves y valores originales. Los tokens sink y la ventana reciente completan esa secuencia; Tree añade una reducción jerárquica de candidatos.
Frente a resumir bloques consecutivos, cambia qué claves se agrupan; frente a recorrer todos los grupos, cambia la ruta de búsqueda. Las variantes destilada y nativa enlazan esta estructura con el aprendizaje de formas distintas. La valoración técnica debe vincular las configuraciones con sus efectos y costes: velocidad en contextos ultralargos, pérdida de precisión de Tree, sobrecoste en contextos cortos y mayor memoria de N-LSA. Un único multiplicador no describe toda la aportación.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Artículo analizado: Latent Sparse Attention v1
Consulte con IPLEX el análisis de estructuras de IA y sus implicaciones para patentes.
Conozca la experiencia de Yongduck Kim en IA