
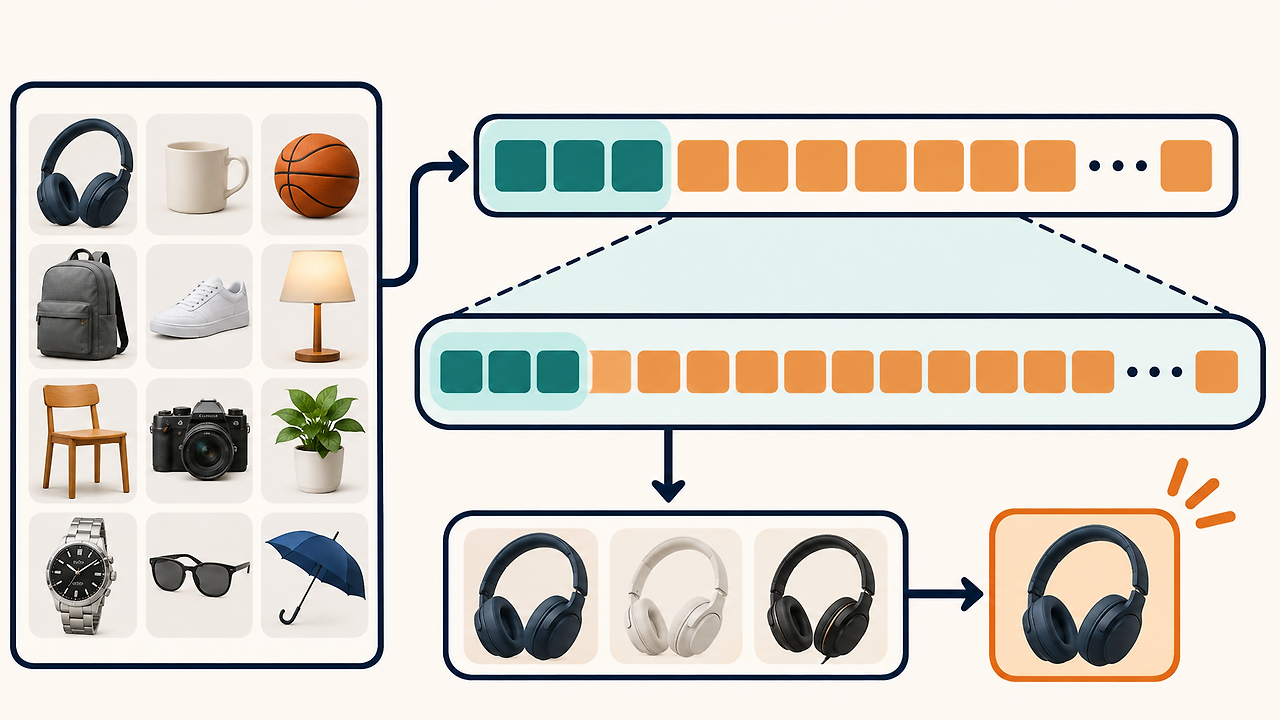
Comparar desde el principio todos los detalles de cada fotografía de producto puede resultar costoso. Matryoshka Representation Learning entrena varias longitudes a la vez para que incluso un prefijo corto del vector permita buscar imágenes. Un catálogo hipotético y el experimento de ImageNet-1K muestran cómo seleccionar candidatos y reordenarlos después con el vector completo.
1. Cuántos números necesita una búsqueda visual
Imaginemos que llega una foto de una taza azul con asa cuyo nombre de archivo solo indica una fecha. Para localizarla entre miles de fotografías hay que comparar su contenido. La primera selección, sin embargo, no tiene por qué estudiar con todo detalle cada asa, borde y dibujo.
El modelo transforma la imagen en un vector numérico o embedding; su dimensión es el número de componentes. Las distancias entre vectores permiten obtener candidatos parecidos. Al repetir la operación en un catálogo amplio, la dimensionalidad influye en el coste.
Kusupati y sus colaboradores presentaron Matryoshka Representation Learning en NeurIPS 2022. Su propuesta utiliza distintas longitudes del comienzo de un mismo embedding: una representación corta para explorar y otra más larga para distinguir candidatos.
2. Entrenar varias longitudes en una sola salida
En los experimentos de imágenes, el modelo produce 2.048 componentes y se evalúan prefijos de 8, 16, 32 dimensiones y otras longitudes. Los vectores de 16 y 32 dimensiones no proceden de ejecuciones independientes: ambos se extraen del mismo comienzo de la salida.
Durante el entrenamiento, cada longitud seleccionada predice la clase de la imagen y aporta una pérdida respecto de la etiqueta correcta. Estas pérdidas se combinan para actualizar el modelo compartido. Así, la calidad de los prefijos cortos también orienta el aprendizaje.
La clasificación emplea clasificadores para las distintas longitudes. En recuperación de imágenes se comparan distancias entre las representaciones aprendidas. Si se trabaja con 16 dimensiones, tanto la consulta como cada imagen del catálogo utilizan sus primeros 16 componentes.
3. Seleccionar candidatos y volver a compararlos
Supongamos que un catálogo ficticio contiene botellas, tazas, vasos de papel y vasos sin asa. Se codifica la foto de la taza azul y se compara con vectores del catálogo calculados previamente con el mismo modelo. La primera etapa usa prefijos cortos para conservar candidatos próximos.
La segunda vuelve a calcular las distancias con una porción más larga de esos mismos vectores. Dos tazas azules pueden cambiar de posición al reflejarse diferencias más finas. El ejemplo no supone que una dimensión concreta represente un color o una pieza determinados.
La primera etapa reduce el conjunto y la segunda refina el orden. Una taza descartada al principio no puede reaparecer al reordenar. Por eso, el tamaño de la lista debe elegirse considerando calidad y cálculo conjuntamente.
4. Los resultados de ImageNet-1K
El equipo utilizó representaciones de ResNet50 para recuperar imágenes de la misma clase que la consulta en ImageNet-1K. Una configuración seleccionó 200 candidatos con 16 dimensiones y los reordenó con las 2.048 completas. Las tablas 8 y 11 del suplemento oficial presentan resultados de búsqueda exacta por distancia.
Con las mismas representaciones MRL, la búsqueda directa de 2.048 dimensiones obtuvo un mAP@10 del 65,20 %, frente al 65,27 % de la selección con 16 dimensiones seguida de la reordenación completa. La métrica resume la posición de imágenes relevantes entre las diez primeras para varias consultas. La cercanía indica calidad comparable en esas condiciones.
Las columnas de cálculo de búsqueda muestran 2.624 y 21 MFLOPs por consulta, respectivamente. MFLOPs expresa millones de operaciones en coma flotante. Estos valores no equivalen al tiempo total percibido por el usuario, que también incluye generar el embedding y acceder a los datos.
5. Elegir dimensiones y número de candidatos
Un prefijo más corto reduce los componentes comparados por foto, pero puede excluir candidatos útiles cuando las diferencias visuales son sutiles. Para el conjunto más difícil ImageNet-4K, el trabajo también estudia 64 dimensiones en la primera etapa. Las 16 dimensiones y los 200 candidatos son una configuración experimental.
La relevancia depende del objetivo. Buscar una categoría puede admitir la misma taza en otro color; identificar un SKU exige distinguir productos diferentes con asas o dibujos parecidos. Definir primero qué cuenta como relevante facilita detectar dónde empeora el resultado.
La reordenación necesita acceder a los vectores largos de los candidatos. El tamaño del índice corto y la ubicación del almacenamiento completo son decisiones distintas. Registrar por separado cálculo, latencia de lectura y espacio permite evaluar su efecto.
6. Comparaciones útiles durante el desarrollo
Compare sobre el mismo catálogo la búsqueda completa y la selección por prefijos. Registre primero si el candidato pertinente sobrevive y después su posición tras reordenar. Esto distingue pérdidas de la primera etapa y problemas de clasificación de la segunda.
Incluya iluminación distinta, recortes y cambios de ángulo. Un buen resultado con fotos limpias no garantiza el mismo comportamiento con imágenes enviadas por clientes. Además de la latencia media, estudie las condiciones de las peticiones lentas antes de cambiar candidatos o acceso a vectores.
Para un análisis de patentes, conecte las longitudes evaluadas durante el entrenamiento, la regla de selección y los datos reutilizados en la segunda comparación. Ensayos controlados sobre el mismo catálogo ayudan a separar el efecto de la representación y el del diseño de recuperación.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
El catálogo es hipotético. Las cifras de calidad y cálculo corresponden al experimento publicado y no garantizan el rendimiento de un servicio.
Página oficial de Matryoshka Representation Learning en NeurIPS 2022
Artículo final de NeurIPS 2022
Suplemento oficial, incluidas las tablas 8 y 11
Lost in the Middle: por qué importa dónde aparece el documento con la respuesta
Consulte los proyectos de IA de IPLEX y los materiales para preparar una consulta sobre embeddings y procesos de búsqueda.
Conozca la experiencia de Yongduck Kim en IA