
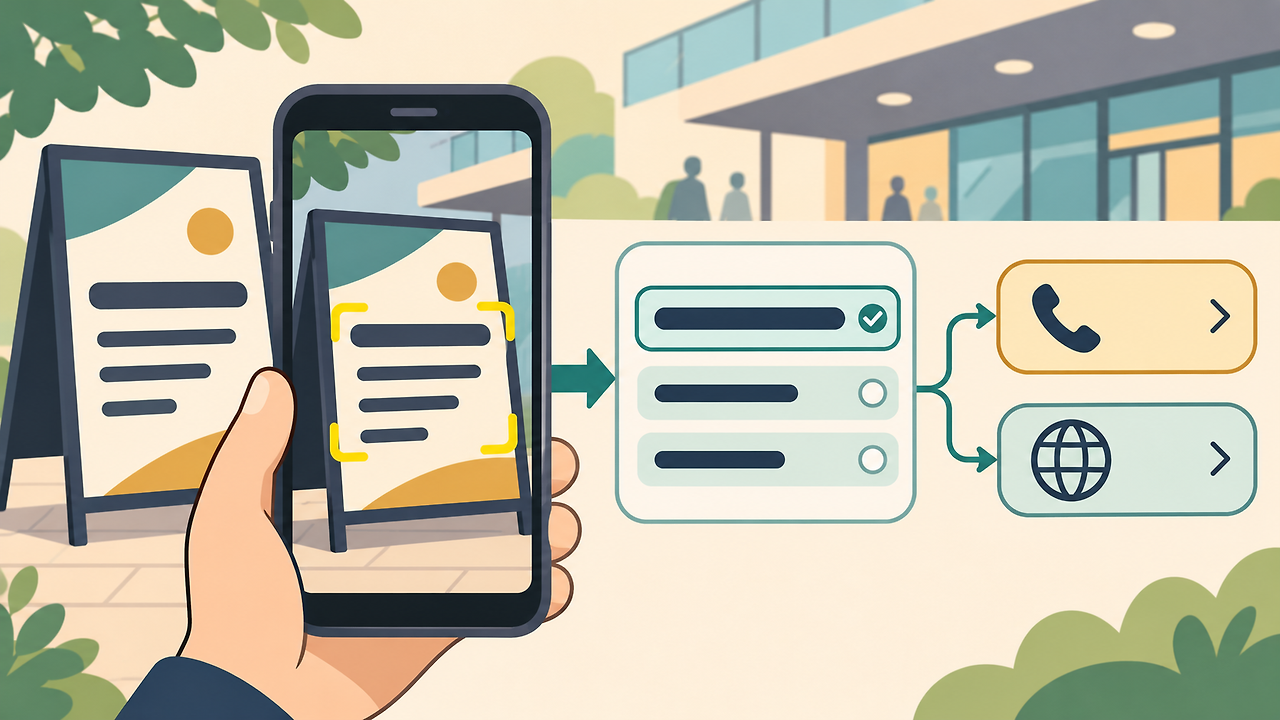
Reconocer caracteres en una fotografía es solo el inicio. La patente de Apple explica cómo asociarlos a una posición y un tipo para ofrecer una operación pertinente cuando el usuario los selecciona.
1. De los píxeles del cartel al texto utilizable
Imaginemos un cartel de un evento con nombre, teléfono y dirección web. Tras el OCR, la interfaz aún debe determinar qué línea visible quiere seleccionar el usuario.
US12001642B2 de Apple, concedida el 4 de junio de 2024, describe la interacción con texto reconocido en imágenes y vistas previas de cámara. El análisis trata del flujo de interfaz, sin atribuirle un nuevo algoritmo de OCR.
La cadena conecta reconocimiento, ubicación, interpretación del tipo, selección y acción. Cada etapa puede fallar de manera independiente.
2. Mantener la correspondencia con la imagen
La figura 6C muestra regiones reconocidas y propiedades de prominencia, como tamaño y posición. Estas características pueden determinar qué texto se destaca.
La figura 6D contempla un cambio de vista. Al cambiar la imagen o la previsualización, las regiones reconocidas deben seguir correspondiendo al contenido visible.
Una cadena correcta no basta si al tocarla se selecciona la línea contigua. Es necesaria una asociación fiable entre texto y coordenadas.
3. El tipo orienta las operaciones
La patente describe detectores de datos que pueden usar expresiones regulares para identificar teléfonos o direcciones de correo. Los formatos varían según región y contexto.
En la figura 6C se indican contenidos de dirección o teléfono, por ejemplo mediante subrayado. Las figuras 6N y 6O relacionan la entrada con llamadas o un menú para llamar, enviar mensajes, añadir contactos y copiar.
La figura 6L incluye operaciones generales de copia y uso compartido. Clasificar el tipo limita las opciones pertinentes; no significa que toda secuencia numérica deba iniciar una llamada.
4. Tres decisiones en un cartel hipotético
El usuario puede mantener pulsado el nombre para copiarlo, seleccionar el número para llamar o copiarlo, y elegir la URL para abrir el navegador.
La ilustración separa región seleccionada, tipo interpretado y operación disponible. Así, distintas líneas de la misma foto ofrecen opciones diferentes.
Las acciones responden a una entrada del usuario. Reconocer un número mediante la cámara no equivale a llamar automáticamente.
5. Relación con la documentación pública
La guía de iPhone explica cómo seleccionar, copiar, compartir y traducir texto en fotos o vídeos en pausa. Otra guía describe el control de Texto en vivo en la cámara.
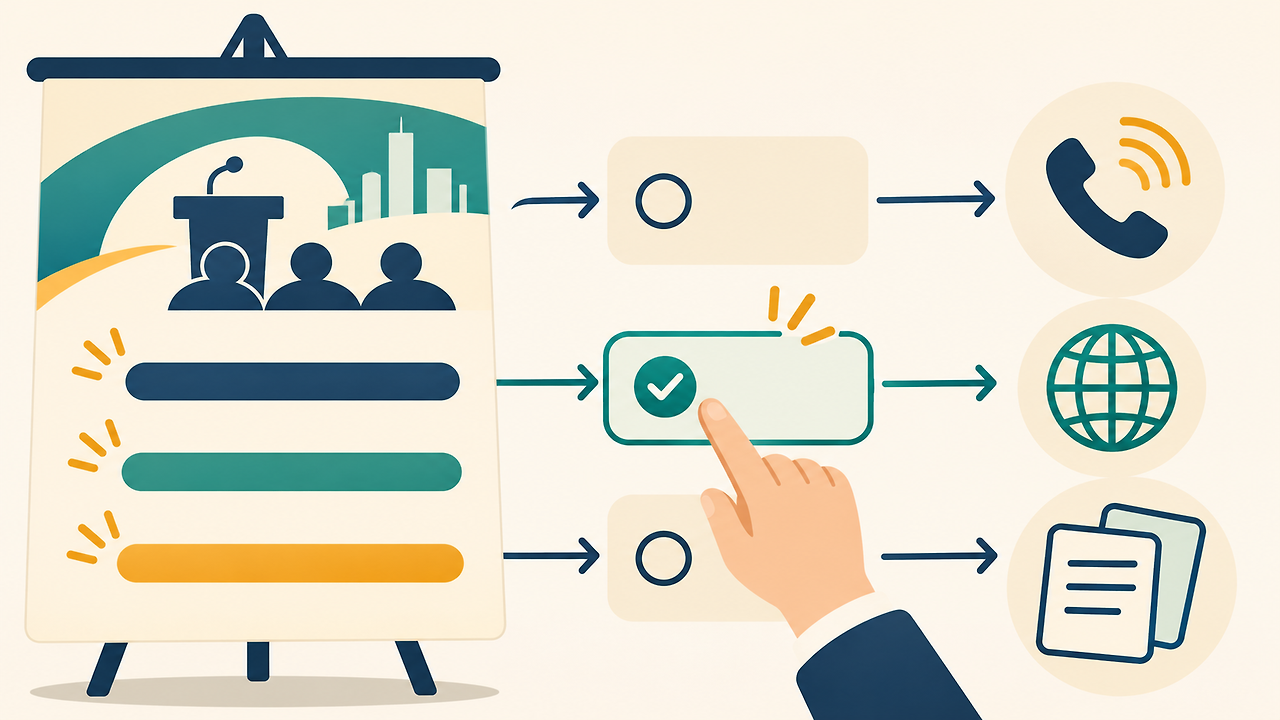
La presentación de VisionKit en WWDC 2022 distingue análisis de imagen e interacción, con ejemplos de direcciones en mapas, marcación de números y apertura de URL.
Estas fuentes ayudan a entender las funciones de usuario. Por sí solas no acreditan qué reivindicaciones aplica una versión concreta de producto.
6. Evaluar toda la interacción
Evalúe por separado OCR, alineación de coordenadas, clasificación y operación. Un texto correcto en la línea equivocada y un número de pedido tomado por teléfono son errores distintos.
Pruebe reflejos, oclusiones, zoom y rotación, incluida la alineación tras cambiar la vista. La información mostrada antes de una acción externa también importa para la decisión del usuario.
La descripción técnica debe precisar flujo de datos, condiciones de estado, asociación espacial y selección de acciones. Comparaciones controladas permiten identificar la mejora concreta sin reducir todo a precisión del OCR.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
El cartel es hipotético. La documentación pública no acredita la ejecución de reivindicaciones concretas.
Apple: texto en fotos y vídeos
Apple: Texto en vivo en Cámara
WWDC 2022: interacción de texto con VisionKit
La patente de traducción visual de Naver: cómo alinear el texto cuando se mueve la cámara
Consulte los proyectos de IA de IPLEX sobre reconocimiento documental e interfaces que conectan percepción y acción.
Conozca la experiencia de Yongduck Kim en IA