
読むトークンを減らしても、その候補を探す処理が重ければ言語モデルは十分に高速化しません。Latent Sparse Attention(LSA)は、学習された空間でキーをまとめ、クラスタの代表値を手掛かりに必要な位置へ到達することで、この探索コストに取り組みます。
既存モデルにインデクサーの蒸留を通じて適用するD-LSAと、モデルとともに初めから学習するN-LSAでは、学習の結び付け方が異なります。本稿は原稿の分析対象である論文の版に沿い、構成、測定結果および残る課題を分けて検討します。
対象論文と版
対象はLatent Sparse Attention: Towards Subquadratic Ultra-Long Context Attentionです。著者はAles Kubicek、Andrea Caciolai、Liangzu Peng、Sukrit Sumant、Benjamin Hoover、Fraser Greenlee、Ruairidh M. Battleday、Radim Urban、Torsten Hoefler、James C. R. Whittingtonです。UrbanとHoeflerはETH Zurich、その他の著者はPrefrontal AIに所属しています。
分析対象は2026年10月30日提出のarXiv:2610.42147v1です。DOIは10.48550/arXiv.2610.42147、ライセンスはCC BY 4.0です。プレプリントであり、査読済み論文としては扱いません。原図のFigure 3〜7とTable 3を保持し、著者らの報告値と本稿の技術的解釈を区別します。
疎なアテンションにも探索負荷が残る
クエリーは現在必要な情報、キーは比較の手掛かり、値は実際に読み出す表現を担います。全アテンションでは各クエリーが先行するキーを比較するため、プリフィルの計算量は文脈長Tに対して概ね二次で増えます。疎なアテンションで一部だけを選んでも、インデクサーが全キーや連続ブロックを走査すれば探索の負担は残ります。
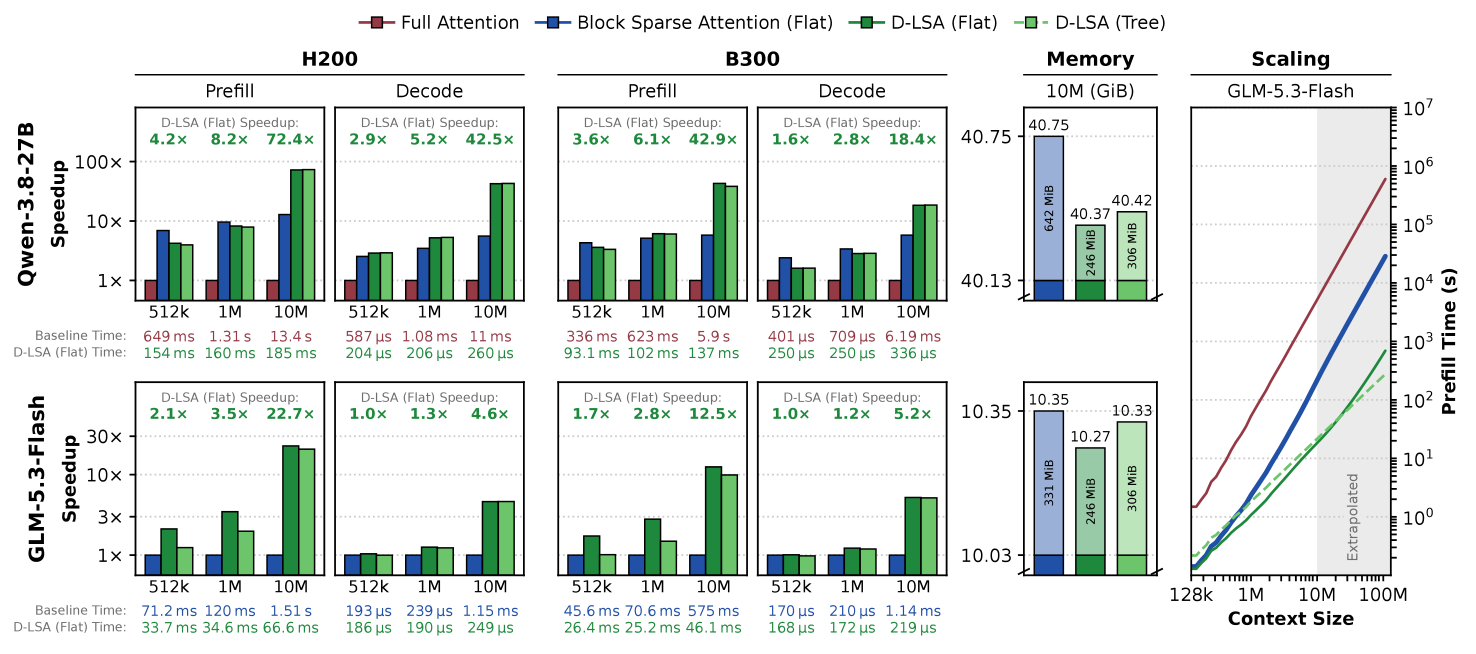
Figure 2では、1,000万トークンにおける疎なアテンションのプリフィル時間の98%をインデクサーが占めました。H200一台上のGLM-5.3-Flashのグローバルアテンション一層で、最後の32,768クエリーのチャンクを測った結果です。LSAの「意味に基づく」クラスタリングは、人が話題名を付けることではなく、学習済みベクトル空間の類似性を利用することを指します。
代表値で探し、元のキーと値で計算する
D-LSAの主要設定では、キーを64次元のインデックス空間に射影し正規化します。連続するキー4個をプーリングし、512トークンのクラスタブロック内で類似したキーを統合します。Ward基準はクラスタ内のばらつきの増加が小さい組合せを優先します。バケットの平均はキー8個、最大16個で、完成したブロックは以後再編成しません。
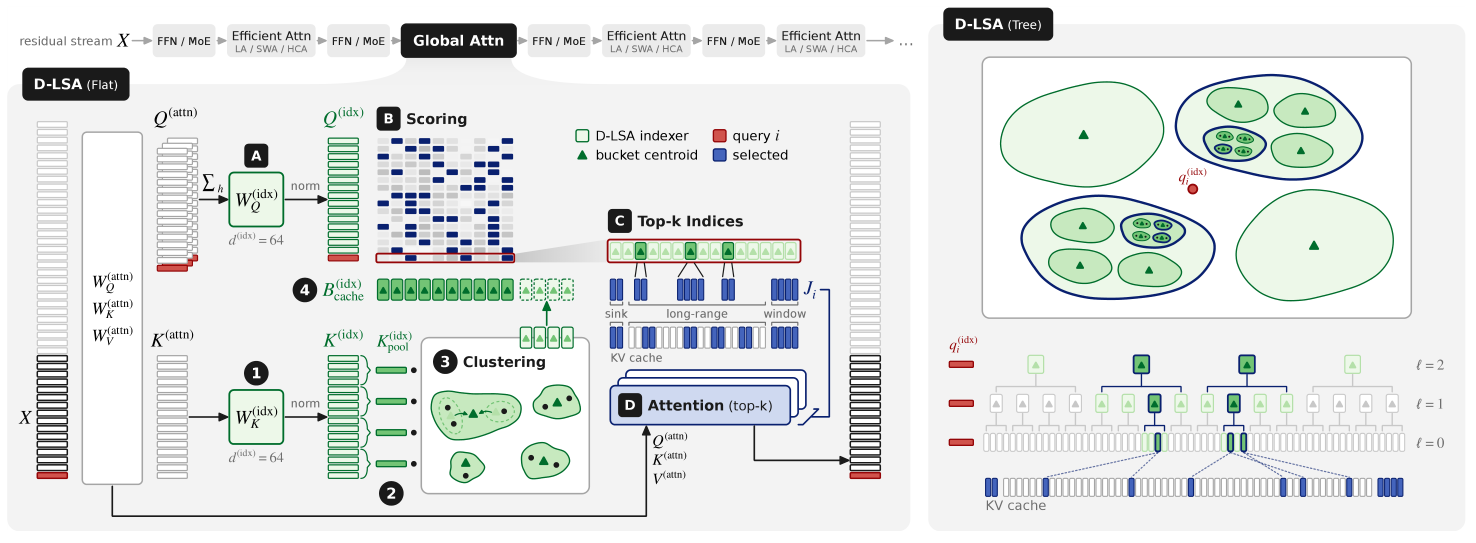
各バケットは重心と元のキー位置への対応表を保持します。クエリーが有望な重心を選び、対応表から元の位置を展開して、長距離トークンの予算内でアテンションを行います。冒頭のsinkトークンと直近のwindowも含め、未クラスタ化の最新ブロックはwindowで扱います。代表値だけで最終出力を計算する構成ではありません。
Flatはすべてのバケット重心を比較します。バケットサイズを固定するとクエリー当たりの探索はTに比例し、プリフィルのインデクシングは漸近的には二次のままです。Treeは上位クラスタを重ねたビーム探索で候補を絞ります。各階層の候補数が一定なら比較する重心数はクエリー当たりO(log T)、プリフィルはO(T log T)となり、二次未満という計算量の説明はこのTree構成に対応します。
D-LSAが蒸留するもの
D-LSAは事前学習済みモデルを固定し、層ごとの小さなクエリー・キー射影行列と学習用温度を調整します。元モデルのアテンション分布を教師信号として用い、蒸留時は全キーを直接採点します。クラスタリングは蒸留損失の計算に含めません。
インデクサーの学習には16k〜1Mトークン長の文書から計3億5,200万トークンを用いたと報告されています。その後のモデル全体の疎アテンション再学習は費用上の理由で実施されていません。Qwen-3.8-27Bは全アテンション、GLM-5.3-Flashは既存の疎アテンションを基準とします。主成分方向を用いて蒸留しないTraining-Free変種は、主要なD-LSA結果と分けて読む必要があります。
N-LSAは次トークン予測で直接学習する
N-LSAは教師モデルを使わず、アテンション自体のキーをクラスタ化します。専用のインデックス射影を増やす代わりに、各クエリーヘッドと重心との類似度の最大値をバケット得点に用います。選択演算を通る勾配は止め、選ばれたキー、sink、windowへのアテンション経路を通じて学習します。実装上、補助損失や追加パラメーターはありません。
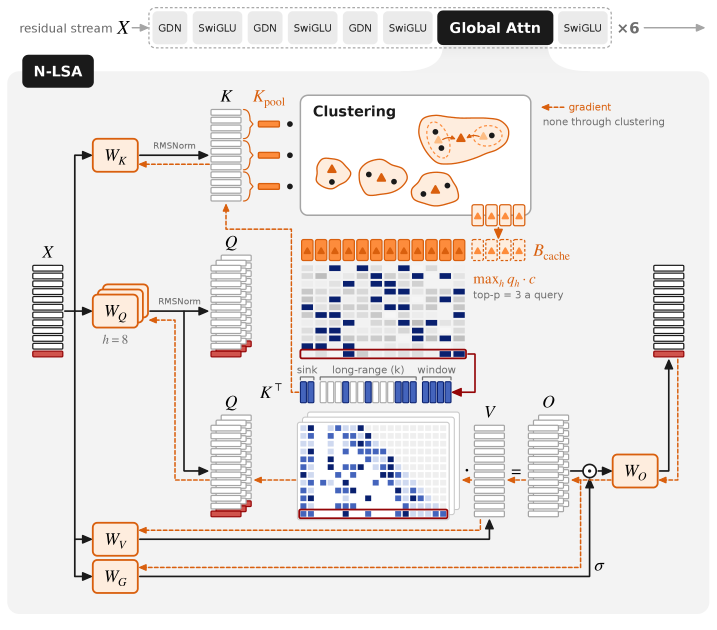
評価対象は約5億パラメーター、24層のハイブリッドモデルです。4層ごとに一つがアテンションで、それ以外はGated DeltaNet層です。4k文脈での事前学習後、128k文脈で学習率を減衰させる段階を設けています。N-LSAで評価したのはFlatのみであり、大規模モデルのTreeを用いたネイティブ学習まで実証したものではありません。
評価課題と文脈拡張の条件
D-LSAはMMLU-Pro、GPQA-Diamond、AIME25、MATH500、LongBench v2、RULERで評価されています。超長文の評価費用を抑えるため、一部は部分集合を使っています。RULERは1Mまで一課題当たり100プロンプト、それを超える長さでは20プロンプトです。
新設のPaperTrailは科学論文に人工的な事実の手掛かりを挿入し、一論文からの取得、二論文の接続、三論文以上の連鎖を評価します。実際の科学的発見の能力を直接示す得点ではありません。文脈は最大10Mまで拡張し、Qwen-3.8-27BにはYaRNを適用しました。明示的な位置符号化を持たないGLM-5.3-Flashは同じ処理を必要とせず、元の公称文脈範囲だけで行った評価とは区別します。
精度はモデルと探索方法によって変わる
Qwen-3.8-27BのD-LSA Flatは1Mまで全アテンションとの差が5ポイント以内でした。10MではRULERが63.9対59.9、PaperTrailが29.1対19.8でFlatが上回りました。ただし、これは当該課題・設定の結果であり、読む量を減らせば一般に精度が向上するという意味ではありません。
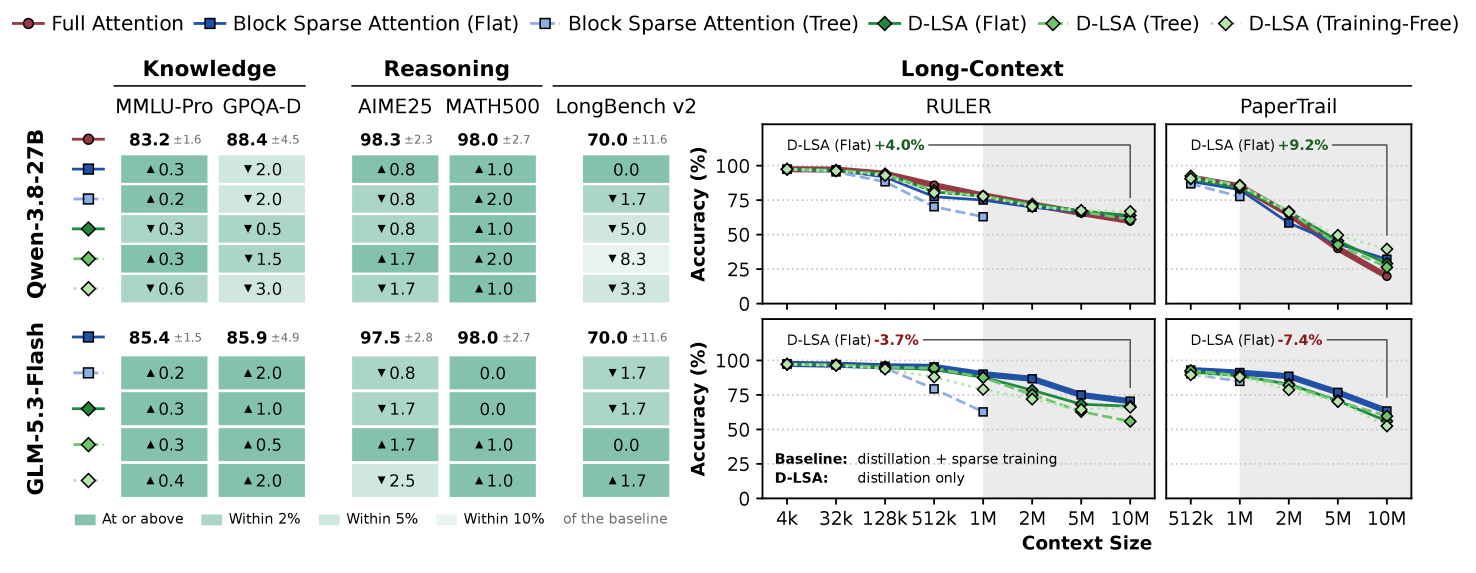
GLM-5.3-FlashのFlatは1Mまで既存の疎アテンションとの差が3ポイント以内でしたが、2M〜5Mでは最大8ポイント下回りました。10MのRULER差は4ポイント以内です。同じ10MでTreeは55.8、Flatは66.8でした。両モデルとも文脈が長くなるほど難しくなる課題があり、基準モデルに近いことと課題を十分に解けることは分けて評価すべきです。
一層の高速化とサービス全体の遅延
H200一台、10Mトークンの一層測定では、D-LSAのプリフィル/デコード高速化率はGLM-5.3-Flashの疎アテンション比で22.7倍/4.6倍、Qwen-3.8-27Bの全アテンション比で72.4倍/42.5倍でした。プリフィルは最後の32,768クエリーチャンク、デコードは一要求の一ステップであり、要求全体の所要時間の倍率ではありません。
SGLangによる全モデルの提供実験では、H200・10MのQwen-3.8-27B D-LSA Flatで最初のトークンまでの時間(TTFT)が9.21倍、出力トークン当たりの時間(TPOT)が2.87倍改善しました。設定はTP8とDCP8です。Table 3の各ブロック先頭行は基準時間、それ以外は倍率なので、ハードウェアと並列化条件を併せて読みます。
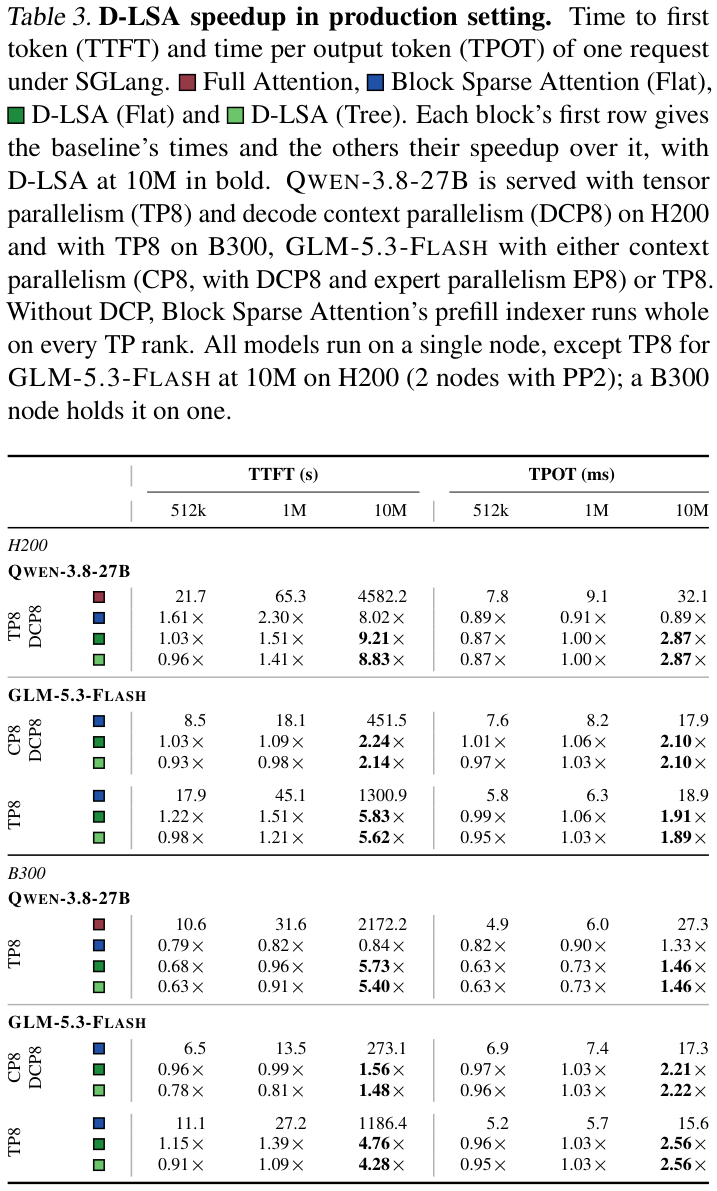
GLM-5.3-FlashのH200・CP8ではTTFT/TPOTが2.24倍/2.10倍、TP8では5.83倍/1.91倍でした。指定された10M・H200・TP8設定はPP2を用いる二ノード構成です。一方、Qwen-3.8-27B FlatのB300・512kではTTFTが0.68倍、TPOTが0.63倍でした。1未満は低速化を意味し、選択・クラスタ化の追加費用が削減効果を上回る場合があります。
ネイティブ学習の速度とメモリー
128k文脈でのN-LSA一層の順伝播・逆伝播は全アテンションより1.6倍高速でした。ハイブリッドモデル全体の減衰学習は、同じ検証損失1.085で1.24倍高速です。アテンションは4層に一つなので、一層の倍率と全モデルの倍率は一致しません。
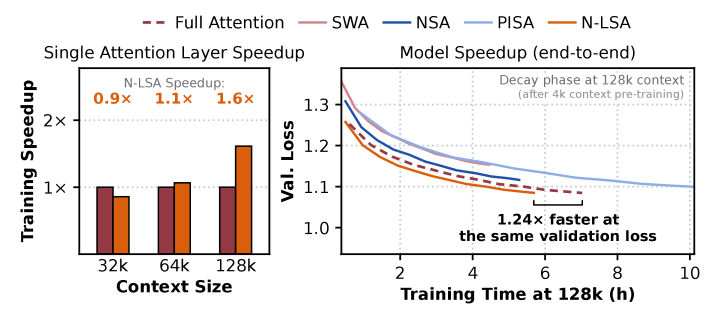
ピークメモリーはN-LSAが一層6.8 GiB、全アテンションが5.8 GiBで、N-LSAの方が大きい結果でした。逆伝播用に選択インデックスを保持する費用が含まれます。学習が速いことだけでメモリー節約まで結論づけることはできません。
結果を適用できる範囲
LSAが削減するのはキーを見つける費用であり、元のKVデータを保存する量ではありません。KVキャッシュは文脈長に対して線形に増えます。Figure 6の10M超は外挿で、100Mにおける大きな倍率は実測ではありません。また、報告された一要求のデコード実験ではD-LSA TreeもFlat探索を使っており、デコードの倍率すべてを木探索の効果とはいえません。
N-LSAの証拠は約0.5Bモデル、128kまで、Flat探索という範囲です。より大きいモデル、長い文脈、Treeでのネイティブ学習は今後の課題です。評価の標本削減や文脈拡張も含まれるため、実サービスの同時要求数、遅延目標、文書分布へそのまま当てはめることはできません。
弁理士の視点から見る構成と効果
技術的課題は、読む量を減らした後にも残る選択処理のボトルネックです。学習された探索空間、限定されたブロック内のクラスタ化、重心と元位置の対応表、クエリー別のバケット選択、元のキーと値への復帰を一連の構成として見ることが重要です。sinkとwindowがこの処理を補い、Treeは階層ごとの候補削減を加えます。
連続ブロックの要約との違いは、どのキーをまとめるかにあります。全グループの走査との違いは探索経路です。蒸留型とネイティブ型では、その構成を学習に結び付ける方法が異なります。超長文での速度、Treeの精度低下、短文脈の追加費用、N-LSAのメモリー増加を構成と関連付けてこそ、単一の倍率を超えた技術的寄与を把握できます。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
分析対象論文:Latent Sparse Attention v1
AI技術の構成と特許上の検討について、IPLEXにご相談ください。