
少读取一些词元,并不必然让语言模型更快。如果筛选哪些词元值得读取仍耗费大量时间,稀疏注意力就会遇到检索瓶颈。Latent Sparse Attention(LSA)将键在学习得到的空间中聚类,再利用各组代表值引导查询找到相关位置。
D-LSA通过索引器蒸馏接入已有模型,N-LSA则从开始就与模型共同训练。本文以原稿分析的论文版本为准,区分两者的技术结构、实测结果和仍待解决的问题。
论文及分析版本
论文题为Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention。作者为Ales Kubicek、Andrea Caciolai、Liangzu Peng、Sukrit Sumant、Benjamin Hoover、Fraser Greenlee、Ruairidh M. Battleday、Radim Urban、Torsten Hoefler及James C. R. Whittington。Urban和Hoefler来自ETH Zurich,其余列名作者来自Prefrontal AI。
分析对象为2026年10月30日提交的arXiv:2610.42147v1,DOI为10.48550/arXiv.2610.42147,采用CC BY 4.0许可。它是预印本,本文不将其表述为已经同行评审的成果。原文Figure 3—7及Table 3予以保留,并区分研究者报告的数据与本文的技术解读。
为什么稀疏注意力仍可能很慢
查询表示当前寻找的信息,键提供比较依据,值则承载实际读取的表示。全注意力需要每个查询与此前的键进行比较,预填充计算量通常随上下文长度T呈平方增长。稀疏注意力虽然只读选出的部分位置,但索引器若仍遍历全部键或连续块,搜索成本就没有消失。
论文Figure 2中,在1,000万词元条件下,索引器占传统稀疏注意力预填充时间的98%。该实验只测量一台H200上GLM-5.3-Flash的一个全局注意力层,以及最后32,768个查询组成的块。LSA所说的语义聚类依据学习空间中的向量相似性,而非由人给文档添加主题标签。
利用代表值检索,再回到原始键和值
D-LSA主要配置先把键投影到64维索引空间并归一化,将连续4个键池化,再在512词元的聚类块内合并相近的键。Ward准则优先选择合并后簇内离散程度增加最少的组合。桶平均包含8个键、最多16个;已完成的块之后不会重新聚类。
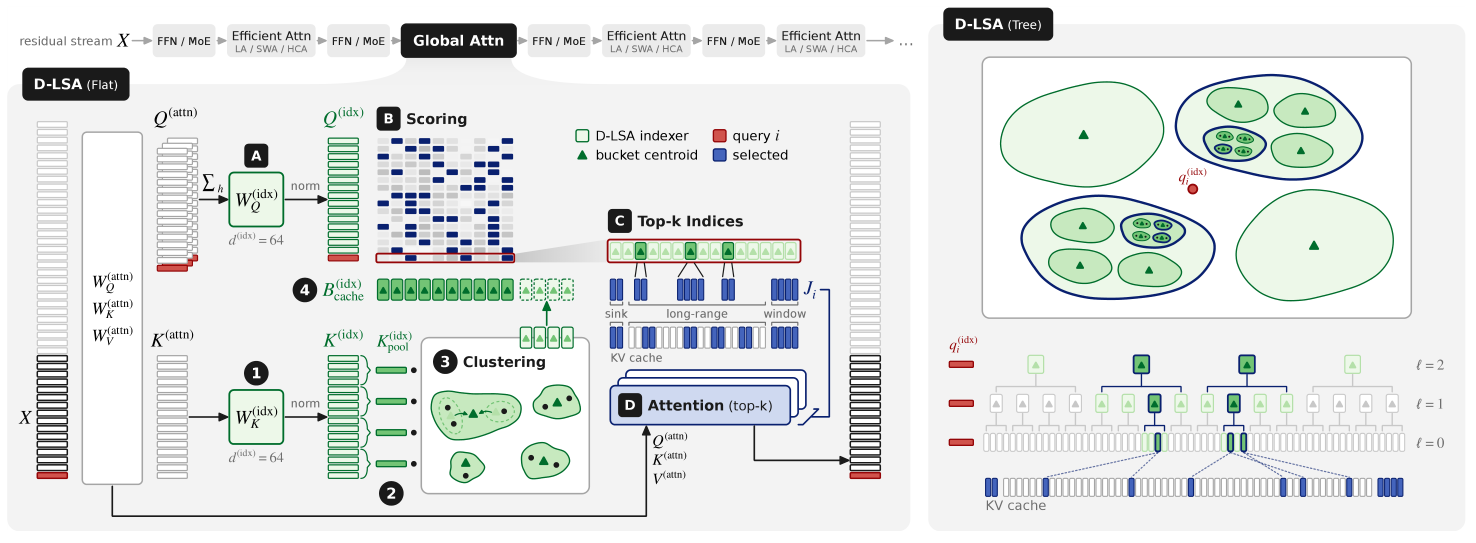
每个桶保存中心及到原始键位置的映射。查询为中心打分,选择有希望的桶,然后展开位置映射,在长距离词元预算内读取原始键和值。同时保留序列开头的sink词元与近期window;尚未聚类的最新块由window覆盖。因此,中心用于找位置,而不是取代原始信息完成最终注意力计算。
Flat检索比较所有桶中心。桶大小固定时,每个查询的检索量仍与T线性相关,预填充索引的渐近复杂度仍为平方级。Tree加入多级上层分组,以束搜索逐层保留有限候选。每层候选预算固定时,每个查询比较O(log T)个中心,预填充索引为O(T log T)。论文中低于平方级的复杂度应具体对应Tree结构。
D-LSA蒸馏的是已有模型的关注分布
D-LSA冻结预训练模型,只调整各层小型查询、键投影矩阵和训练温度,使用原模型的注意力分布作为教师信号。蒸馏时直接对全部键打分,聚类过程不纳入蒸馏损失计算。
研究者报告使用来自16k至1M词元文档的3.52亿训练词元,并因成本原因未再对整个模型进行稀疏注意力训练。Qwen-3.8-27B以全注意力为基线,GLM-5.3-Flash则以已有稀疏注意力为基线,两者不能混同。论文还包含利用主成分方向、无需蒸馏的Training-Free变体,应与主要D-LSA结果分开理解。
N-LSA直接通过下一词元预测学习
N-LSA没有教师模型,直接聚类注意力本身的键;不增加专用索引投影,而是把各查询头与桶中心相似度的最大值作为桶分数。选择操作处停止梯度,参数通过对选中键、sink和近期window的注意力路径更新。该实现不使用额外辅助损失或新增参数。
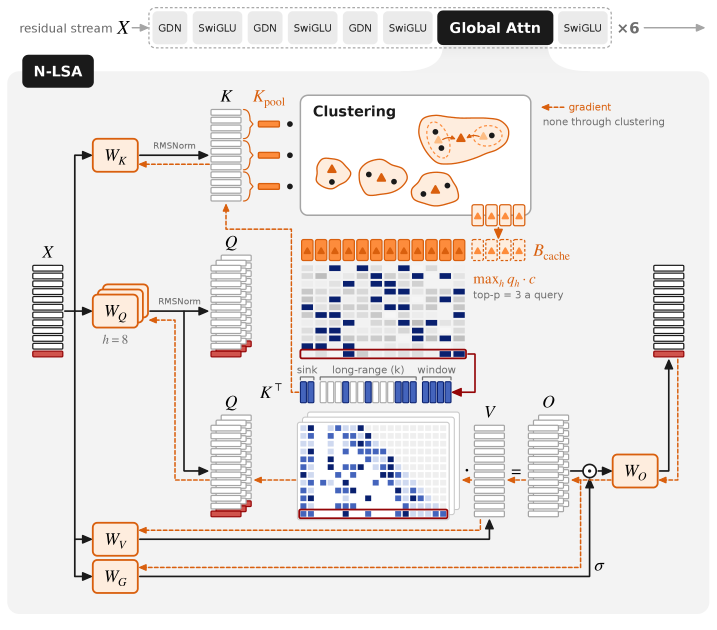
实验使用约5亿参数、24层的混合模型,每4层中有1层为注意力,其余为Gated DeltaNet层。先在4k上下文下预训练,再进行128k上下文的学习率衰减训练。N-LSA仅评估Flat检索,尚未验证大规模模型使用Tree进行原生训练的表现。
评估任务及上下文扩展
D-LSA在MMLU-Pro、GPQA-Diamond、AIME25、MATH500、LongBench v2和RULER上接受评估。超长上下文测试成本较高,部分基准仅使用子集。RULER在不超过1M的长度下,每项任务使用100个提示;超过该长度后,每项为20个。
新建的PaperTrail将人为构造的事实线索插入科学论文,分别测试单篇检索、两篇之间的连接及三篇以上的线索链。分数不等同于现实科研发现能力。测试上下文最长为10M词元;Qwen-3.8-27B采用YaRN扩展,而没有显式位置编码的GLM-5.3-Flash不需要同类处理。因此,不能把实验理解为始终处于模型原有官方上下文范围内。
准确率取决于模型、长度和搜索方式
Qwen-3.8-27B的D-LSA Flat在1M以内与全注意力的差距不超过5个百分点。10M下,RULER为63.9对59.9,PaperTrail为29.1对19.8,Flat高于原基线。这只是特定任务和配置下的观察,不能概括为读得越少就越准确。
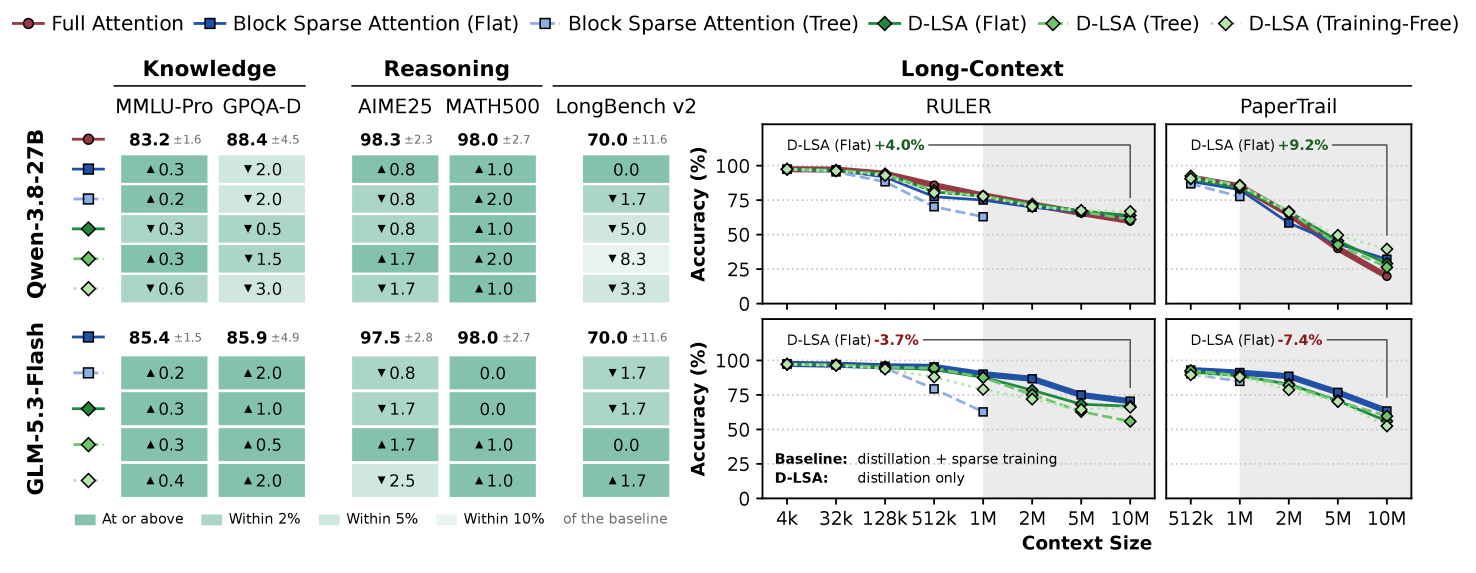
GLM-5.3-Flash的Flat在1M以内与稀疏基线相差不超过3个百分点,但在2M至5M间最多落后8个百分点;10M的RULER差距在4个百分点以内。同一10M测试中,Tree为55.8,Flat为66.8。两个模型也都在更长上下文中遇到更困难的任务。保持基线水平与充分解决任务,是不同的评价。
单层加速与完整服务时延
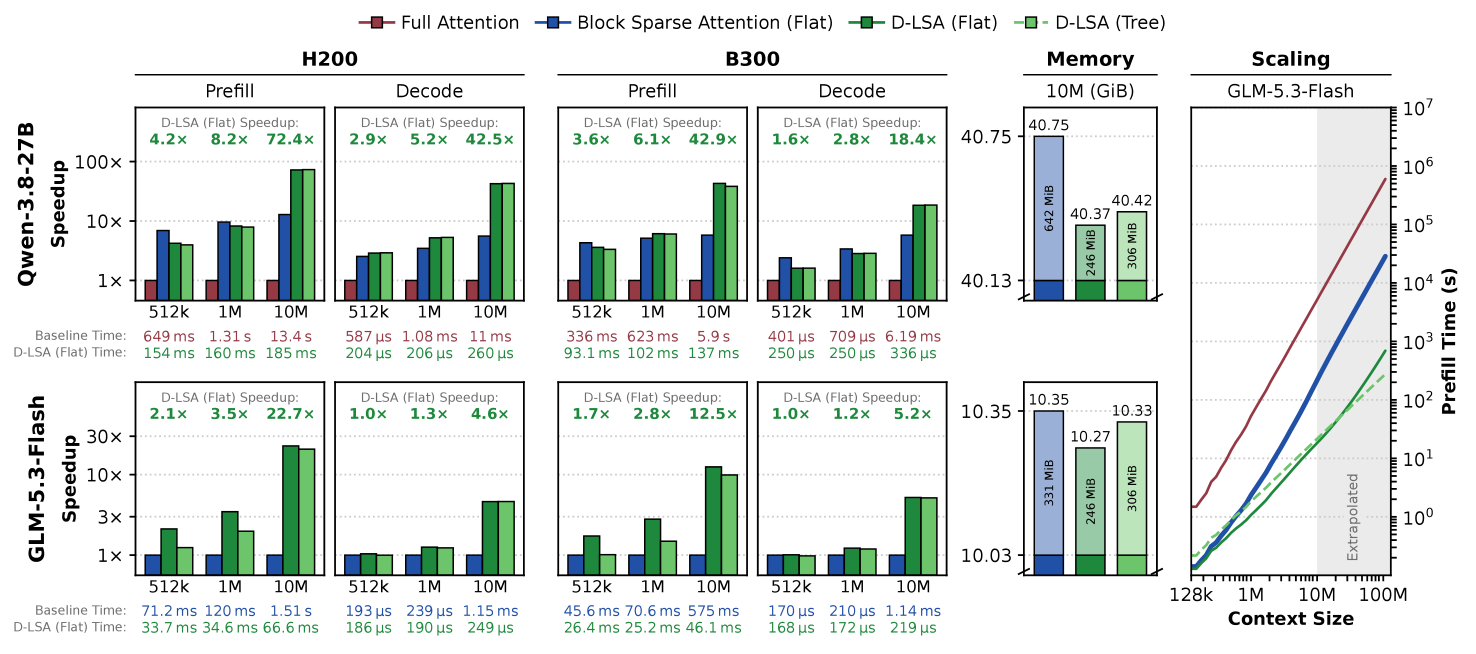
一台H200、10M词元的单层实验中,D-LSA相对GLM-5.3-Flash稀疏注意力的预填充和解码加速分别为22.7倍、4.6倍;相对Qwen-3.8-27B全注意力分别为72.4倍、42.5倍。预填充只测最后32,768个查询块,解码只测单请求的一步,不代表完整请求的端到端加速。
SGLang服务实验中,H200、10M上下文下的Qwen-3.8-27B D-LSA Flat,首词元时间(TTFT)改善9.21倍,每输出词元时间(TPOT)改善2.87倍,采用TP8和DCP8。Table 3各组首行是基线耗时,其他行是相对加速比,必须同时读取硬件及并行配置。
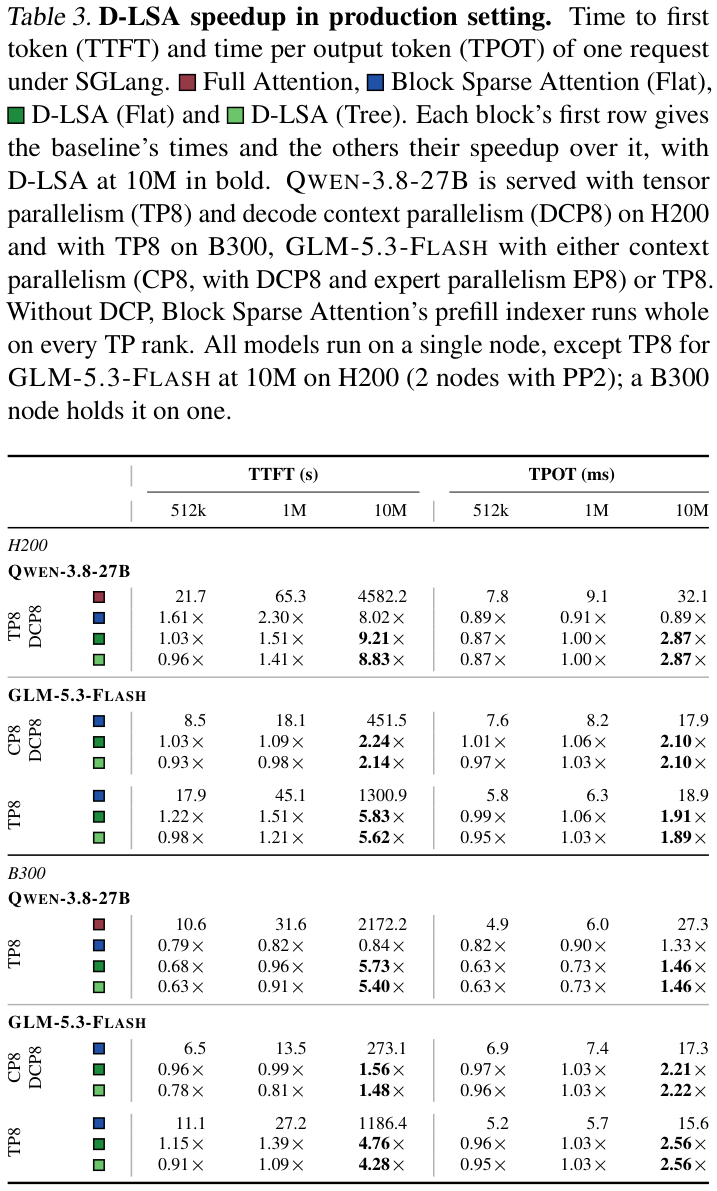
GLM-5.3-Flash在H200的CP8配置下,TTFT和TPOT改善2.24倍、2.10倍;TP8配置下为5.83倍、1.91倍。所述10M、H200、TP8配置使用PP2的双节点。较短上下文甚至会变慢:Qwen-3.8-27B Flat在B300、512k下,TTFT为0.68倍,TPOT为0.63倍。小于1表示慢于基线,因为选择与聚类的开销可能超过节省的注意力计算。
原生训练中的速度和内存取舍
128k上下文下,N-LSA一个注意力层的前向、反向传播比全注意力快1.6倍。整个混合模型的衰减训练阶段在相同验证损失1.085下快1.24倍。由于每4层中只有1层采用注意力,单层与全模型的加速比不同。
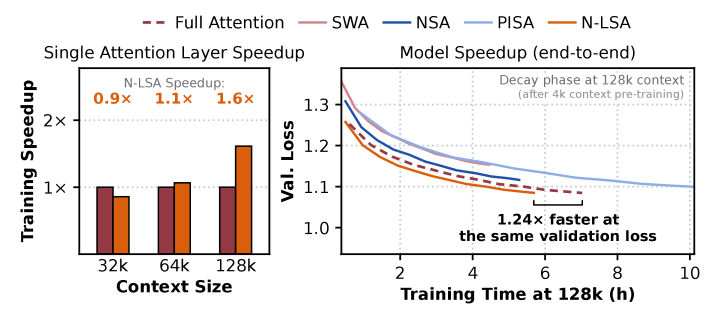
N-LSA的峰值内存更高,每层为6.8 GiB,而全注意力为5.8 GiB。反向传播需要保存选中位置的索引,这也是开销来源之一。训练更快,并不能自动推导出内存占用更低。
不能从结果中直接推出的结论
LSA减少的是寻找键的成本,并未消除原始KV数据的存储需求。KV缓存仍随上下文线性增长。Figure 6在10M以上的部分属于外推,100M处的大幅加速不是实测值。报告的单请求解码实验中,D-LSA Tree也采用Flat检索,因此不能把全部解码增益归于树遍历。
N-LSA证据限于约0.5B模型、最长128k和Flat检索。更大模型、更长上下文及Tree原生训练仍待研究。基准抽样和上下文扩展也意味着,实验结果不能不加区分地套用于实际服务的并发量、时延目标或文档分布。
从专利实务角度理解技术贡献
技术问题在于,稀疏注意力减少读取量之后,选择待读位置的瓶颈仍然存在。值得分析的是学习检索空间、限定块内聚类、中心和原始位置映射、按查询选择桶以及回到原始键值计算之间的组合关系。sink与window补全这条处理链,Tree则增加逐层收缩候选的路径。
相对连续块摘要,差别在于如何组合键;相对遍历全部分组,差别在于如何寻找候选。蒸馏型与原生型又以不同方式把结构与训练连接起来。应把超长上下文的加速、Tree准确率下降、短上下文额外成本和N-LSA内存增加,分别对应到具体结构,才能超越单一加速数字理解其技术贡献。
图中保留原始标注与形态,相关内容在正文中说明。
分析论文:Latent Sparse Attention v1
如需分析AI系统的技术结构及专利问题,请与IPLEX联系。