
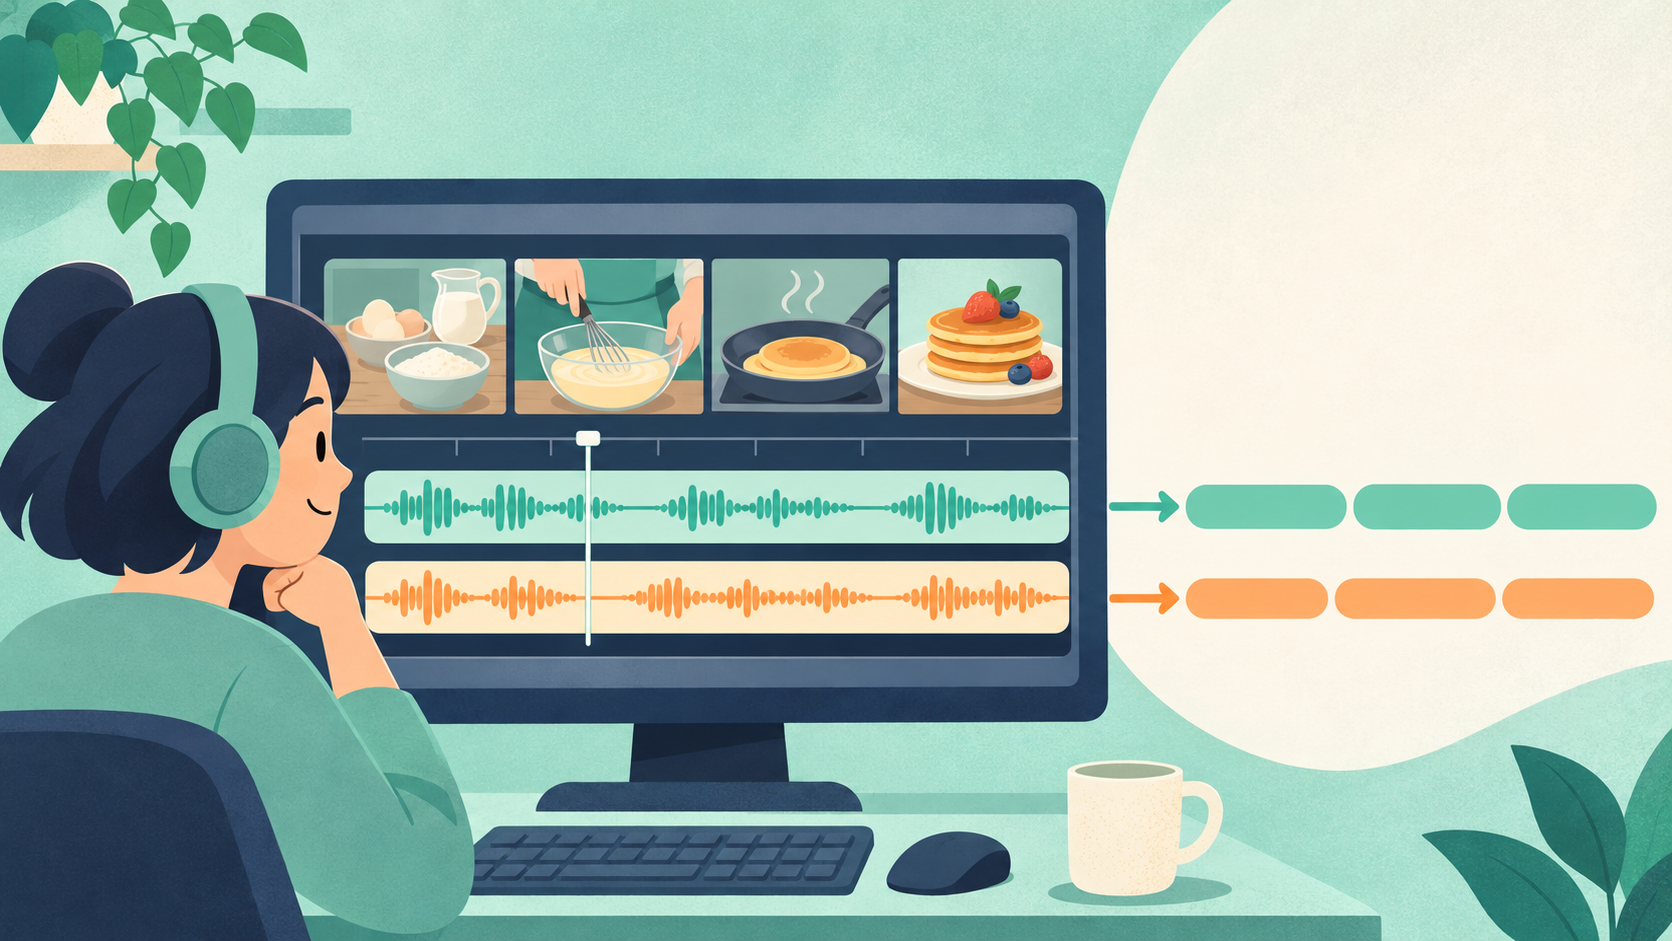
Cuando la narración y las instrucciones coinciden en un vídeo formativo, hay que decidir qué voz transcribir y cuándo mostrar el texto. US11837234B2 describe el reconocimiento independiente de las pistas seleccionadas, la ordenación de sus fragmentos por tiempo de inicio y el acortamiento del subtítulo anterior si los intervalos se superponen. Un ejemplo hipotético permite seguir el proceso.
1. Dos voces en un vídeo de formación
Imaginemos una demostración de montaje: el presentador explica las piezas y una grabación separada añade instrucciones breves. Reconocer únicamente la mezcla de audio puede provocar omisiones o confusiones cuando ambas voces coinciden.
Cada pista ocupa una línea propia en la cronología del vídeo. Mantener separados la narración, las instrucciones y la música permite ajustar su posición y volumen, así como seleccionar qué pistas originales se transcribirán.
La patente estadounidense US11837234B2, de Beijing ByteDance Network Technology, se concedió el 5 de diciembre de 2023. Aquí interesa su contenido técnico: reconocer cada pista seleccionada y reunir los fragmentos de texto para un mismo vídeo.
2. Reconocer cada pista seleccionada
El reconocimiento automático del habla convierte la voz grabada en texto. La figura 1 describe la obtención de los datos de cada pista seleccionada al solicitar subtítulos; la figura 2 muestra la selección de una o varias pistas y la generación.
Por ejemplo, pueden elegirse narración e instrucciones y excluirse la pista de música. Cada voz se reconoce en su pista ya existente. No se trata de separar hablantes a partir de una grabación previamente mezclada.
El resultado consiste en fragmentos de texto con tiempos de inicio y finalización de su visualización. Aunque se reconozcan por separado, deben integrarse en la cronología común del vídeo.
3. Ordenar los fragmentos y ajustar su final
Concatenar toda la transcripción de una pista y después la de otra alteraría el orden temporal. La figura 3 ordena conjuntamente los fragmentos según el momento en que deben empezar a mostrarse.
Después compara el final del fragmento anterior con el inicio del siguiente. En el ejemplo de superposición, adelanta aquel final hasta este inicio. Si ya existe un intervalo o ambos tiempos coinciden, no es necesario acortarlo de esa manera.
Se modifica la duración del subtítulo, no la posición del audio. Para fragmentos con inicio simultáneo, otra realización conserva el que termina más tarde. Si deben aparecer todas las intervenciones, el editor también ha de revisar el contenido conservado.
4. Un segundo de superposición en un ejemplo hipotético
Supongamos que A, «Compruebe primero la ranura de la base», aparece entre los segundos 3 y 7, y B, «Coloque el panel lateral en vertical», entre los segundos 6 y 9. Proceden de pistas distintas y coinciden de 6 a 7.
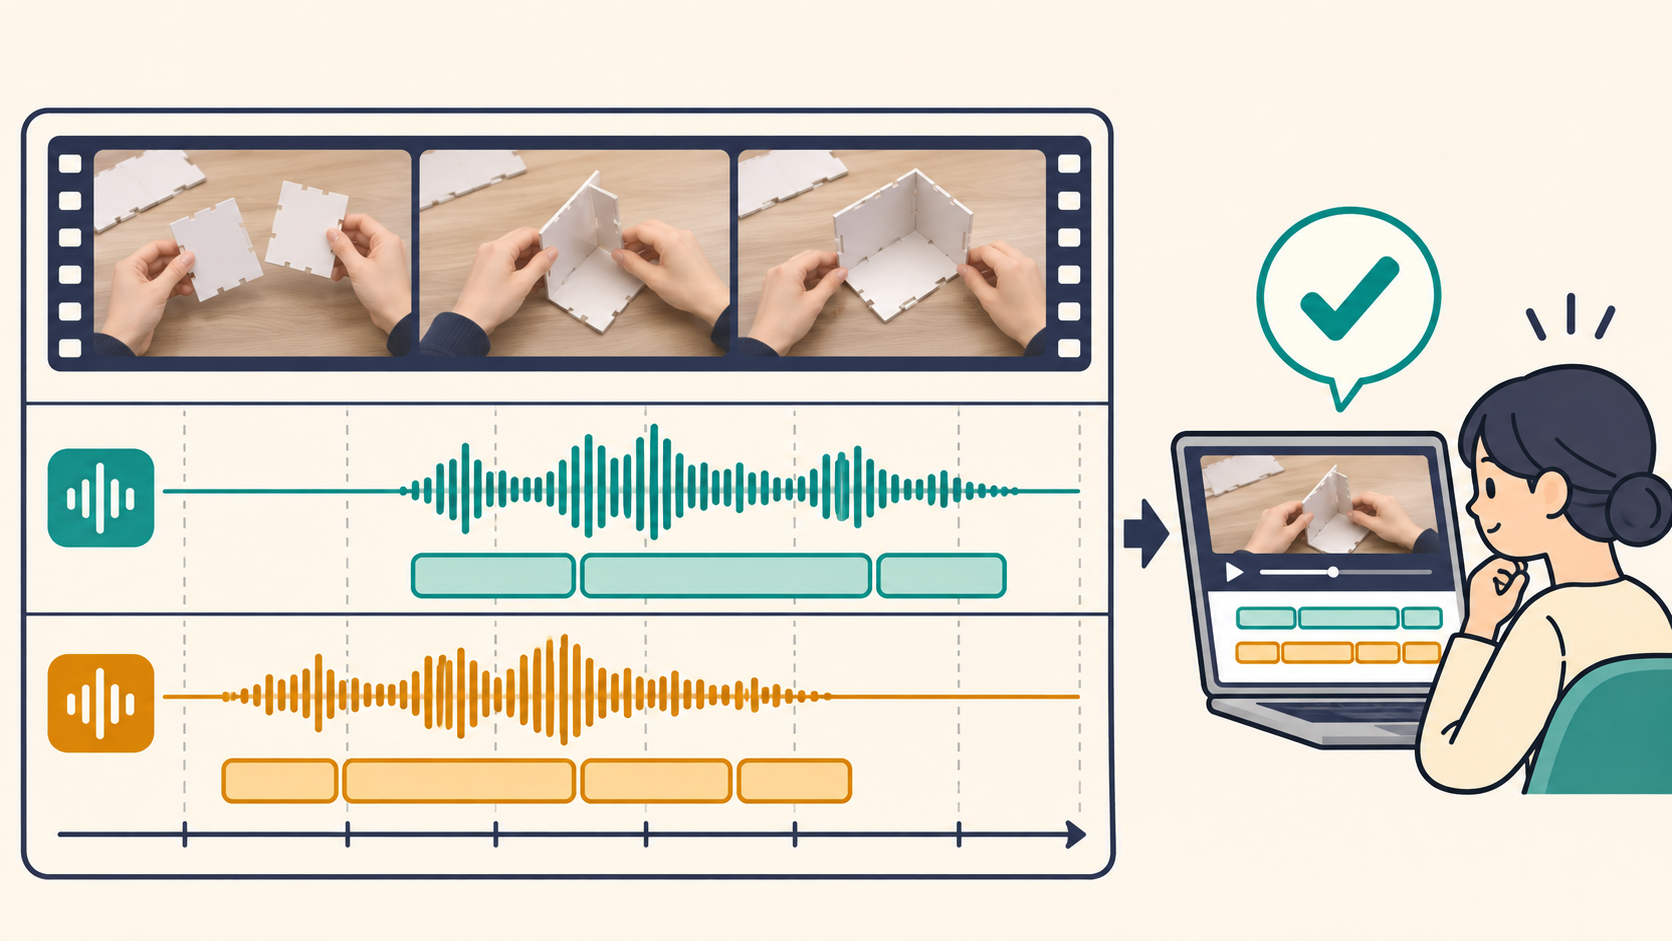
Con la regla ilustrada, el final de A pasa del segundo 7 al 6. A se muestra de 3 a 6 y B de 6 a 9. Las palabras y las grabaciones permanecen intactas; cambia únicamente el intervalo visible.
Eliminar la superposición no garantiza una lectura cómoda. Tres segundos pueden resultar insuficientes para una instrucción larga. Dividir el texto o reajustar los tiempos sigue siendo una decisión editorial; los intervalos automáticos son un punto de partida.
5. Qué explica la documentación pública de CapCut
ByteDance incluye CapCut en su catálogo de edición de vídeo. La ayuda de CapCut explica que los subtítulos automáticos reconocen el habla; en escritorio se eligen la fuente de audio y el idioma, se generan los subtítulos y se editan texto y tiempos en la cronología.
El equipo puede revisar el borrador reproduciendo imagen y sonido. Una palabra mal reconocida requiere corregir el texto; un subtítulo que permanece tras terminar la instrucción requiere modificar su duración. Son operaciones diferentes.
Usar el mismo estilo en varios vídeos no exige los mismos tiempos. Un discurso más rápido o una instrucción adicional puede necesitar otros intervalos. Comparar cambios de plano, intervenciones y comienzos de subtítulo ayuda a localizar los ajustes.
6. Qué conviene documentar durante el desarrollo
Distinga entrada, reconocimiento y visualización. Registre las pistas elegidas y los periodos con voces simultáneas; después compruebe palabras omitidas, tiempos de inicio y fin, y margen de lectura.
Compare reconocimiento de la mezcla y reconocimiento por pistas sobre el mismo vídeo. Incluya textos cortos y largos, inicios simultáneos y ausencia de solapamiento. Anote las correcciones y el trabajo de edición necesario.
Para estudiar una posible protección, describa los criterios de selección, los valores temporales comparados entre fragmentos vecinos y los ajustes de legibilidad posteriores. Los resultados obtenidos con distintas condiciones sobre una misma cronología permiten explicar mejor la aportación técnica.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Los ejemplos formativos son hipotéticos. La documentación pública de un producto no demuestra por sí sola la ejecución de una reivindicación concreta.
CapCut: reconocimiento de subtítulos
Productos y servicios de ByteDance
Reconocimiento de voz de iFLYTEK: contrastar términos de una reunión con el audio
Audio con IA de Samsung: preparar los controles antes de terminar la separación
Consulte los proyectos de IA de IPLEX y los materiales para preparar una consulta sobre reconocimiento del habla y temporización de subtítulos.
Conozca la experiencia de Yongduck Kim en IA