언어모델에 긴 문서를 넣을수록 답변에 필요한 정보를 찾는 과정도 무거워집니다. 모든 토큰을 자세히 읽는 대신 일부 토큰만 골라 읽으면 빨라질 것 같지만, 무엇을 골라야 할지 찾는 일 자체가 오래 걸릴 수 있습니다. 도서관에서 필요한 책 몇 권만 읽더라도, 그 책을 찾으려고 서가 전체를 매번 훑는다면 검색 시간이 줄지 않는 것과 비슷합니다.
오늘 살펴볼 LSA는 이 검색 비용을 겨냥합니다. 연구진은 토큰의 키를 학습된 공간에서 비슷한 것끼리 묶고, 질의가 묶음의 대표값을 따라 필요한 토큰에 접근하도록 설계했습니다. 기존 모델에 덧붙이는 D-LSA와 처음부터 함께 학습하는 N-LSA를 제시하며, 추론과 학습에서 각각 효과를 평가했습니다.
한 문장 핵심: LSA는 읽을 토큰의 수뿐 아니라 그 토큰을 찾아가는 경로까지 줄이려는 희소 어텐션입니다.
1. 논문 기본 정보
논문 제목은 ‘Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention’입니다. 저자는 Ales Kubicek, Andrea Caciolai, Liangzu Peng, Sukrit Sumant, Benjamin Hoover, Fraser Greenlee, Ruairidh M. Battleday, Radim Urban, Torsten Hoefler, James C. R. Whittington입니다. 소속은 Prefrontal AI와 ETH Zurich이며, Radim Urban과 Torsten Hoefler는 ETH Zurich, 나머지 저자는 Prefrontal AI로 표시되어 있습니다.
분석 대상은 2026년 10월 30일 제출된 arXiv:2610.42147v1입니다. 원문은 Preprint로 표시되어 있으며, 이 글에서는 학회나 저널의 심사를 마친 논문으로 소개하지 않습니다. arXiv에 표시된 DOI는 10.48550/arXiv.2610.42147입니다. 원문의 이용허락은 CC BY 4.0입니다.
아래 도표는 Kubicek 등, arXiv:2610.42147v1의 해당 Figure·Table을 기준으로 읽습니다. 논문에서 보고한 결과와 이 글의 기술적 해석을 구분하고, 수치는 비교 모델·하드웨어·문맥 길이를 함께 제시하겠습니다.
2. 왜 적게 읽는데도 느릴까요?
어텐션에서 질의(query)는 현재 필요한 정보를 나타내고, 키(key)는 과거 정보가 어떤 내용인지를 비교할 단서입니다. 값(value)은 선택된 위치에서 가져올 실제 표현입니다. 전체 어텐션은 각 질의가 앞선 모든 키를 비교하므로, 문맥 길이를 T라고 하면 입력을 한꺼번에 처리하는 프리필의 계산량이 대체로 T의 제곱에 비례합니다.
희소 어텐션은 인덱서가 관련 키를 먼저 고른 뒤 그 일부만으로 어텐션을 수행합니다. 그런데 인덱서가 여전히 모든 키 또는 모든 연속 블록을 훑는다면, 전체 읽기 비용을 줄여도 검색 비용은 크게 남습니다. 원문 Figure 2의 GLM-5.3-FLASH 한 글로벌 어텐션 층 실험에서는 1,000만 토큰에서 기존 희소 어텐션 프리필 시간의 98%가 인덱서에 쓰였습니다. 이는 H200 한 대에서 마지막 32,768개 질의 청크를 측정한 특정 조건의 결과입니다.
LSA는 바로 이 지점에서 접근을 바꿉니다. 문서의 앞뒤 위치에 따라 묶기만 하는 대신, 학습된 표현이 비슷한 키를 묶어 검색합니다. 여기서 ‘의미 기반’이라는 말은 사람이 주제를 붙여 분류한다는 뜻이 아니라, 학습된 벡터 공간의 유사성을 이용한다는 뜻입니다.
3. 핵심 원리: 대표값을 찾고 원래 토큰으로 돌아갑니다
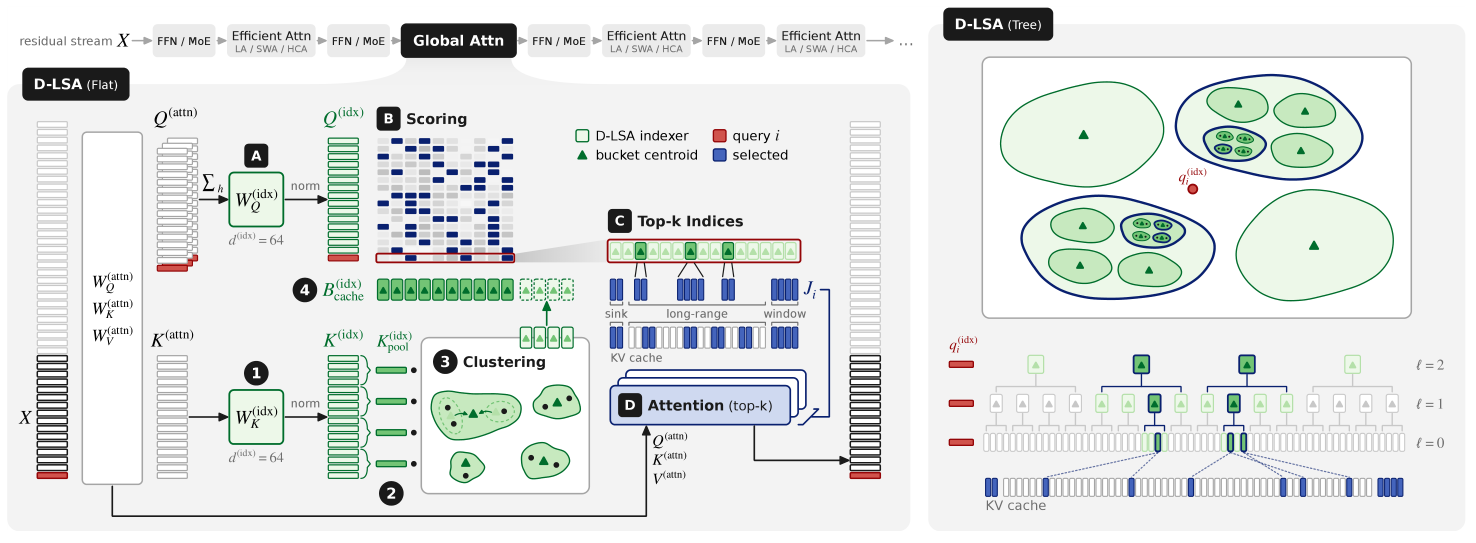
원문 Figure 3. D-LSA의 Flat 구조와 Tree 구조. 키의 묶음과 대표값을 만든 뒤, 선택된 묶음을 원래 토큰 위치로 확장합니다. 출처: Kubicek 등, arXiv:2610.42147v1, CC BY 4.0.
첫 단계는 키를 검색에 사용할 공간으로 옮기고 벡터 길이를 정규화하는 것입니다. D-LSA의 주요 설정에서는 64차원 인덱스 공간을 사용하며, 연속한 키 4개를 풀링하여 묶음 생성 비용을 낮춥니다. 이후 512개 토큰으로 이루어진 클러스터 블록 안에서 유사한 키를 병합합니다. 전체 문맥을 한 번에 다시 군집화하는 방식은 아닙니다.
병합에는 Ward 기준을 사용합니다. 두 묶음을 합쳤을 때 각 키가 묶음 중심에서 멀어지는 정도가 얼마나 늘어나는지를 보고, 증가가 작은 쌍을 합칩니다. 완성된 버킷에는 중심값과 원래 키의 위치표를 보관합니다. 주요 설정에서 버킷의 평균 크기는 키 8개, 최대 크기는 16개이며, 완성된 블록의 버킷은 이후 바꾸지 않습니다.
질의가 들어오면 버킷 중심값과 유사도를 계산해 유망한 버킷을 고릅니다. 그 버킷의 위치표를 펼쳐 원래 키 인덱스를 얻고, 정해진 장거리 토큰 예산에 맞춰 실제 어텐션을 수행합니다. 여기에 문맥 시작 부분의 sink 토큰과 최근 토큰을 담는 window를 함께 포함합니다. 아직 군집화되지 않은 최신 블록은 이 window가 담당합니다.
이 구조의 중요한 점은 대표값만으로 최종 답을 계산하지 않는다는 데 있습니다. 대표값은 찾는 일을 돕고, 실제 어텐션은 선택된 원래 키와 값을 읽습니다. 또한 원래 KV 캐시를 통째로 버리는 방식이 아니므로, 저장 비용과 검색 비용은 따로 살펴야 합니다.
Flat과 Tree의 차이
Flat은 모든 버킷 중심을 비교합니다. 비교 대상 수를 크게 줄이지만, 고정된 버킷 크기에서 질의당 검색량은 문맥 길이에 선형으로 늘어납니다. 따라서 Flat의 프리필 인덱싱은 점근적으로 여전히 이차 비용입니다.
Tree는 버킷 위에 상위 묶음을 여러 층으로 만들고, 각 층에서 유망한 후보만 유지하는 빔 탐색을 사용합니다. 층마다 유지하는 후보 수가 일정한 조건에서 질의당 비교할 중심 수가 O(log T)가 되어, 인덱서 프리필은 O(T log T)로 설명됩니다. 논문 제목의 ‘subquadratic’, 즉 이차 증가보다 느린 계산량을 엄밀하게 연결할 대상은 이 Tree 설계입니다.
4. D-LSA: 기존 모델의 읽는 습관을 배웁니다
D-LSA는 이미 학습된 모델을 고정하고, 층별로 작은 질의·키 투영행렬과 학습용 온도를 조정합니다. 기존 모델이 어떤 위치에 어텐션을 주었는지를 교사 신호로 삼아 인덱서의 분포를 맞추는 방식입니다. 이 과정에서는 모든 키에 직접 점수를 주며, 군집화는 증류 손실 계산에 넣지 않습니다.
연구진은 16k에서 1M 토큰 길이의 문서를 이용한 3억 5,200만 토큰 데이터로 인덱서를 증류했다고 보고합니다. 기존 모델 전체를 희소 어텐션에 맞춰 추가 학습하는 단계는 비용 때문에 수행하지 않았습니다. 따라서 ‘학습 없이 바로 바꾼 구조’와 ‘모델 전체를 재학습한 구조’ 어느 쪽으로도 단순화하면 안 됩니다.
실험 대상은 전체 어텐션을 쓰는 QWEN-3.8-27B와 기존 희소 어텐션을 쓰는 GLM-5.3-FLASH입니다. 두 모델의 출발점이 다르므로, 같은 배속 숫자라도 비교 기준이 다릅니다. 원문에는 주성분 방향을 사용해 별도 증류를 하지 않는 Training-Free 변형도 있지만, 주요 결과의 D-LSA와 구분해 읽어야 합니다.
5. N-LSA: 처음부터 같은 구조로 학습합니다
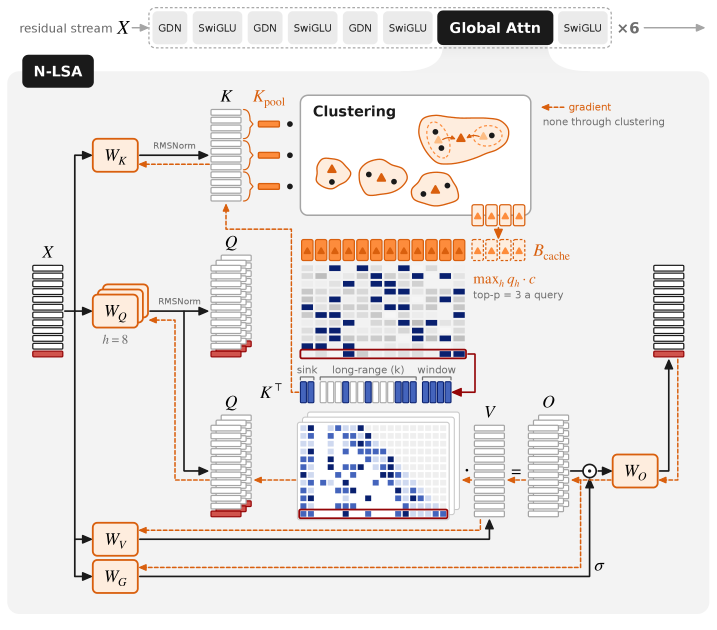
원문 Figure 4. N-LSA는 어텐션 자체의 키를 군집화하고 다음 토큰 예측 손실로 학습합니다. 출처: Kubicek 등, arXiv:2610.42147v1, CC BY 4.0.
N-LSA는 별도 교사 모델 없이, 다음 토큰을 맞히는 손실만으로 처음부터 모델과 함께 학습합니다. 전용 인덱스 투영행렬을 추가하는 대신 어텐션 자체의 키를 군집화하고, 질의 헤드들이 각 버킷 중심과 갖는 유사도 중 가장 큰 값을 버킷 점수로 사용합니다.
선택 연산을 통과하는 기울기는 중단합니다. 대신 선택된 키, sink, 최근 window를 이용한 실제 어텐션 경로를 통해 투영행렬을 학습합니다. 연구진의 구현에서는 별도 보조 손실이나 추가 파라미터 없이 이 방식을 구성했습니다.
다만 N-LSA 실험은 약 5억 파라미터의 24층 하이브리드 모델에서 이루어졌습니다. 매 네 번째 층이 어텐션이고 나머지는 Gated DeltaNet 층입니다. 4k 문맥의 사전학습 뒤 128k 문맥의 감쇠 학습을 수행했으며, N-LSA는 Flat 탐색만 평가했습니다. 대규모 모델의 Tree 기반 네이티브 학습까지 입증한 결과는 아닙니다.
6. 무엇으로 성능을 평가했을까요?
D-LSA의 정확도는 지식·추론·긴 문맥 과제로 나누어 평가했습니다. MMLU-Pro, GPQA-Diamond, AIME25, MATH500, LongBench v2와 함께 RULER를 사용했습니다. 초장문 평가 비용이 크기 때문에 일부 벤치마크는 부분집합으로 평가했고, RULER는 1M까지 과제당 100개 프롬프트, 그보다 긴 구간에서는 20개 프롬프트를 사용했습니다.
연구진이 새로 만든 PaperTrail은 다수의 과학 논문에 의도적으로 만든 사실 단서를 삽입하고, 그 단서들을 찾아 연결하도록 구성했습니다. 한 논문의 사실을 찾는 단계, 두 논문을 연결하는 단계, 세 편 이상의 단서를 이어가는 단계로 난도를 나눕니다. 실제 과학 문헌을 배경으로 쓰지만, 이 점수가 곧 실제 과학 발견 능력이나 모든 연구 업무의 정확도를 뜻하지는 않습니다.
문맥 길이는 최대 1,000만 토큰까지 확장했습니다. QWEN-3.8-27B에는 YaRN 문맥 확장을 적용했고, GLM-5.3-FLASH는 명시적 위치 인코딩이 없어 같은 종류의 확장을 요구하지 않았습니다. 이는 모델이 처음부터 공식 지원하는 문맥 범위 안에서만 평가한 실험과도 구분해야 합니다.
7. 정확도: 유지되는 구간과 떨어지는 구간
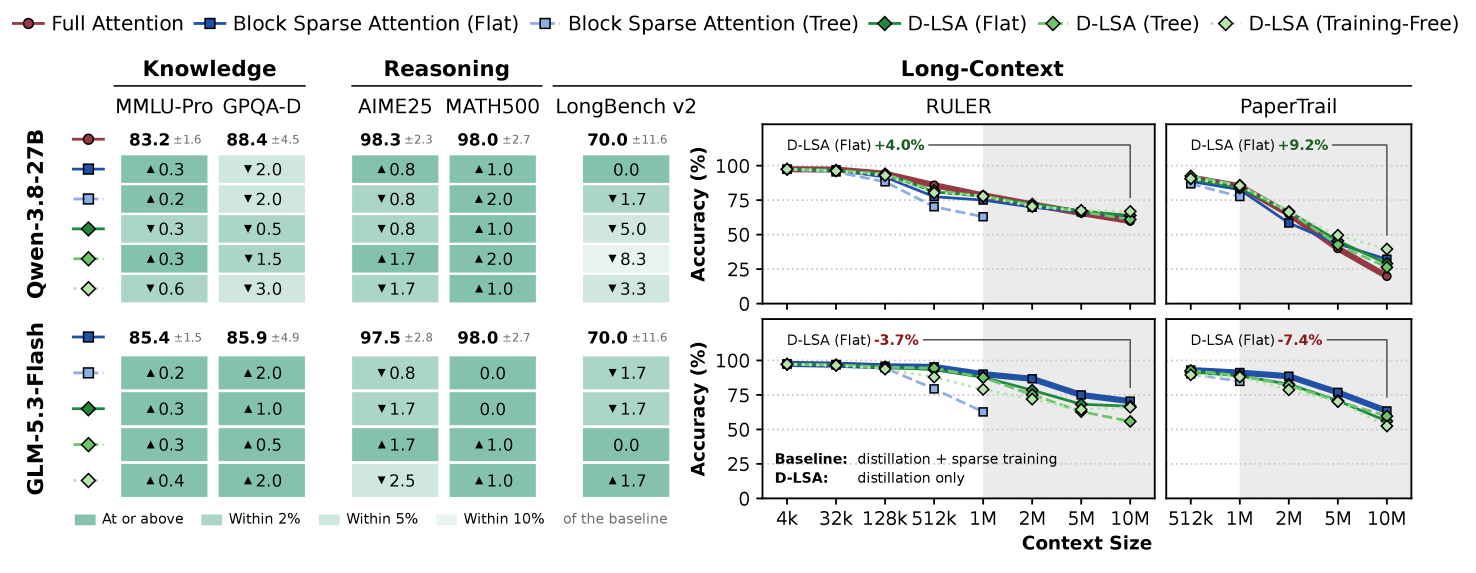
원문 Figure 5. 지식·추론·긴 문맥 과제의 정확도 비교. 모델과 문맥 길이에 따라 Flat과 Tree의 차이가 커집니다. 출처: Kubicek 등, arXiv:2610.42147v1, CC BY 4.0.
QWEN-3.8-27B에서 D-LSA Flat은 1M 토큰까지 원래 전체 어텐션과 5점 이내의 차이를 보였습니다. 10M에서는 RULER가 63.9 대 59.9, PaperTrail이 29.1 대 19.8로 원래 전체 어텐션보다 높게 보고되었습니다. 이 결과는 해당 설정과 평가 과제에서의 관찰이며, 희소하게 읽으면 모든 과제에서 더 정확해진다는 일반 법칙은 아닙니다.
GLM-5.3-FLASH에서는 D-LSA Flat이 1M까지 기존 희소 어텐션과 3점 이내였지만, 2M~5M 구간에서는 최대 8점 뒤처졌습니다. 10M RULER에서는 차이가 4점 이내였습니다. 특히 D-LSA Tree는 같은 모델의 10M RULER에서 55.8로, Flat의 66.8보다 낮았습니다. 계산량을 더 줄이는 탐색 구조가 정확도에도 같은 이점을 준다고 단정할 수 없는 이유입니다.
또한 두 모델 모두에서 문맥이 길어질수록 어려워지는 과제가 있었습니다. ‘원래 모델과 비슷하다’와 ‘초장문 과제를 충분히 잘 해결한다’는 별개의 평가입니다. 기준 모델 자체가 긴 문맥에서 어려움을 겪는다면, 그 정확도를 유지하는 것만으로 문제 해결이 끝나지는 않습니다.
8. 속도: 한 층의 배속과 전체 모델의 배속
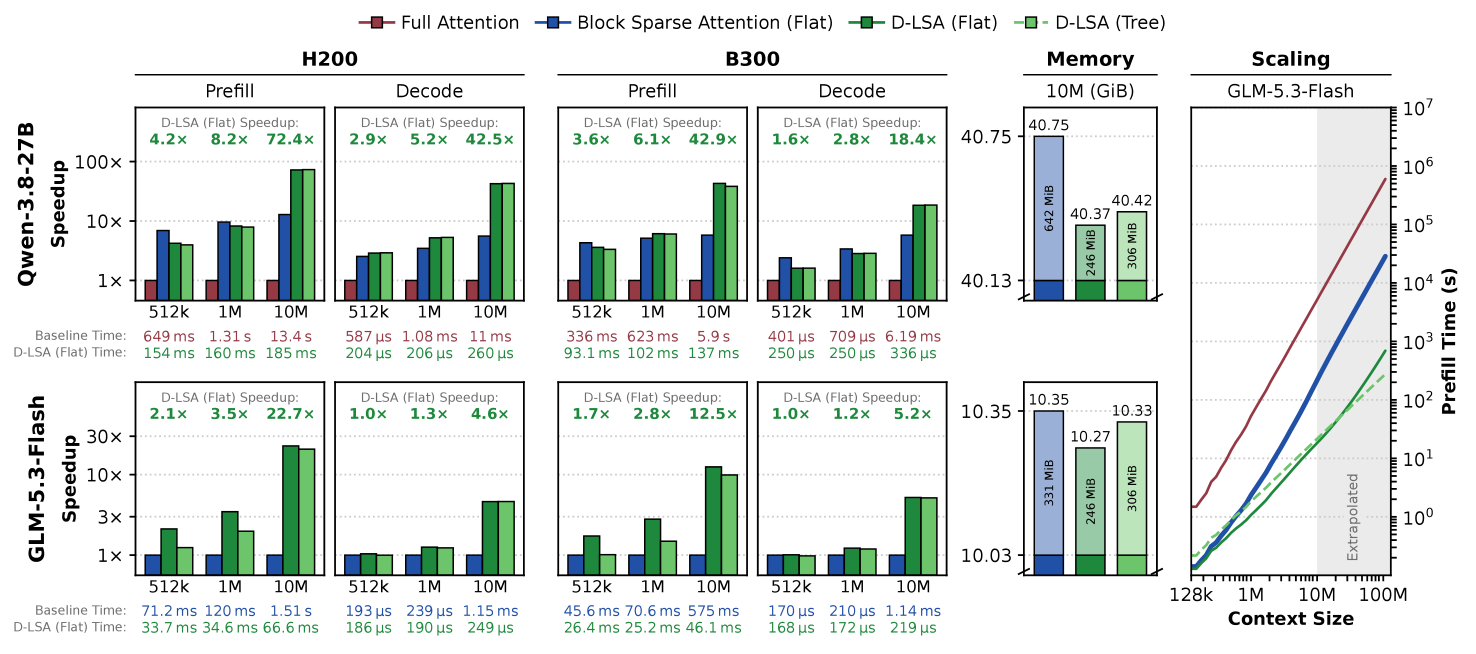
원문 Figure 6. 글로벌 어텐션 한 층의 속도·메모리와 문맥 길이에 따른 증가 추세. 10M을 넘는 음영 구간은 외삽 예측입니다. 출처: Kubicek 등, arXiv:2610.42147v1, CC BY 4.0.
H200 한 대에서 10M 토큰을 처리하는 어텐션 한 층 기준으로, D-LSA는 GLM-5.3-FLASH의 기존 희소 어텐션보다 프리필 22.7배, 디코딩 4.6배 빨랐습니다. QWEN-3.8-27B의 전체 어텐션과 비교하면 각각 72.4배와 42.5배였습니다. 프리필은 마지막 32,768개 질의 청크를, 디코딩은 한 요청의 한 스텝을 측정했습니다. 전체 문서 입력부터 답변 생성까지의 배속으로 읽으면 안 됩니다.
전체 모델을 SGLang으로 제공한 실험에서는 효과가 더 작았습니다. H200 환경의 10M 문맥에서 QWEN-3.8-27B D-LSA Flat은 첫 토큰까지의 시간(TTFT)을 9.21배, 출력 토큰당 시간(TPOT)을 2.87배 단축했습니다. 이 구성은 TP8과 디코딩 문맥 병렬화 DCP8을 사용했습니다.
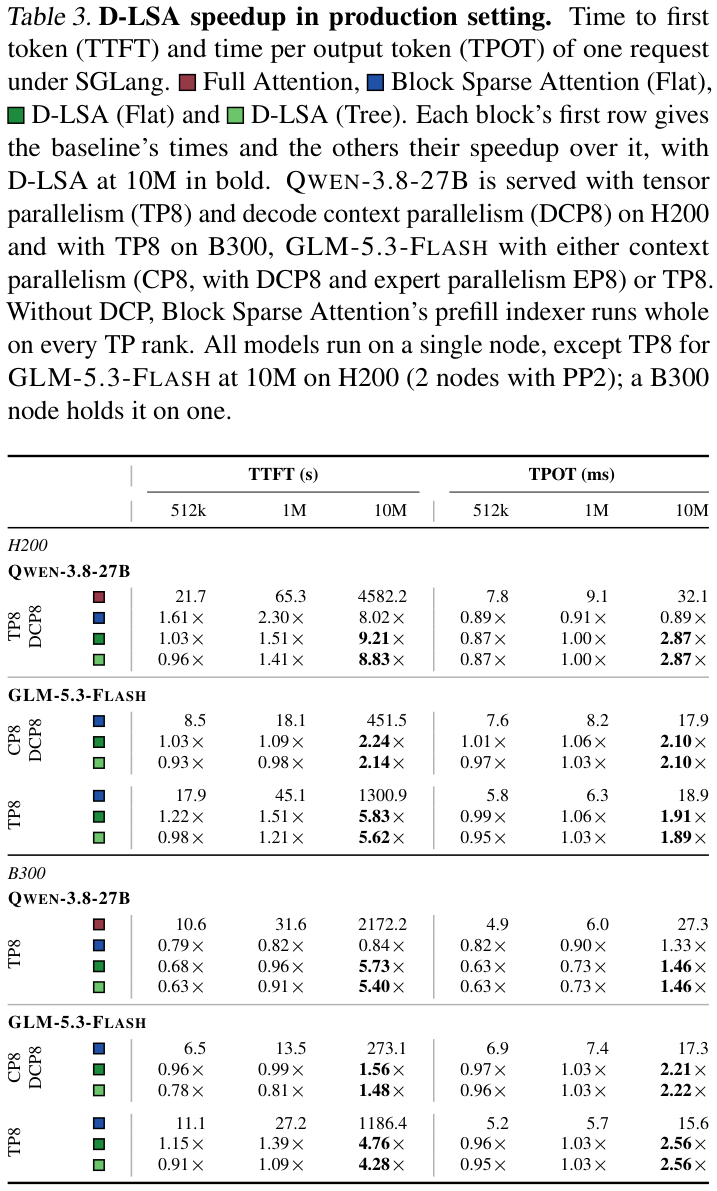
원문 Table 3. 실제 서빙 조건의 첫 토큰 지연과 출력 토큰당 시간. 기준 행은 시간, 나머지 행은 해당 기준 대비 배속이므로 하드웨어와 병렬화 설정을 함께 읽어야 합니다. 출처: Kubicek 등, arXiv:2610.42147v1, CC BY 4.0.
GLM-5.3-FLASH의 H200 CP8 구성에서는 D-LSA Flat의 TTFT와 TPOT 개선이 각각 2.24배와 2.10배였습니다. TP8 구성에서는 각각 5.83배와 1.91배였고, 해당 10M H200 설정은 PP2를 사용하는 두 노드 조건입니다. 같은 모델이라도 병렬화 방식과 하드웨어에 따라 체감 속도가 달라집니다.
짧은 문맥에서는 이점이 작거나 오히려 느린 설정도 있습니다. 예를 들어 QWEN-3.8-27B의 B300 512k 조건에서 D-LSA Flat은 TTFT 배속이 0.68배, TPOT 배속이 0.63배로 보고되었습니다. 1보다 작은 배속은 기준보다 느리다는 뜻입니다. 필요한 키를 고르고 묶는 추가 비용이 절약한 어텐션 비용보다 클 수 있기 때문입니다.
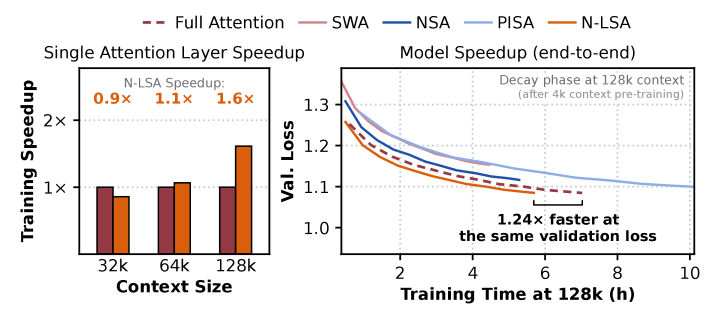
원문 Figure 7. N-LSA의 학습 속도. 어텐션 한 층의 순전파·역전파와 전체 모델의 감쇠 학습 시간을 분리해 보여줍니다. 출처: Kubicek 등, arXiv:2610.42147v1, CC BY 4.0.
N-LSA는 128k 문맥에서 한 어텐션 층의 순전파·역전파가 전체 어텐션보다 1.6배 빨랐습니다. 전체 모델의 감쇠 학습 구간은 같은 검증 손실에서 1.24배 빨랐으며, 검증 손실은 N-LSA와 전체 어텐션 모두 1.085였습니다. 그러나 피크 메모리는 층당 6.8GiB로 전체 어텐션의 5.8GiB보다 컸습니다. 역전파를 위해 선택 인덱스를 보관하는 비용도 있기 때문입니다.
9. 적용 범위와 남은 한계
첫째, LSA는 찾는 비용을 줄이지 저장할 키·값을 없애지는 않습니다. KV 캐시는 여전히 문맥 길이에 따라 선형으로 커집니다. 인덱서 메모리가 줄었다는 결과를 전체 KV 저장 문제의 해결로 확대하면 안 됩니다.
둘째, Tree의 장기적인 계산량 이점과 현재 측정된 최고 속도는 구분해야 합니다. 논문 Figure 6에서 10M을 넘는 부분은 외삽입니다. 1억 토큰에서의 큰 배속은 실측 결과가 아닙니다. 또한 본 실험의 한 요청 디코딩에서는 D-LSA Tree도 Flat 검색을 사용했습니다. 따라서 보고된 디코딩 배속을 모두 트리 탐색의 효과로 돌릴 수 없습니다.
셋째, N-LSA는 약 0.5B 모델·최대 128k·Flat 탐색 조건의 연구입니다. 더 큰 모델, 더 긴 문맥, Tree 기반 네이티브 학습은 남은 과제입니다. 넷째, D-LSA의 초장문 평가에는 표본을 줄인 벤치마크와 문맥 확장이 포함됩니다. 실제 서비스의 동시 요청 수, 지연 목표, 문서 분포까지 같다고 볼 수는 없습니다.
10. 변리사 관점의 기술 분석
기술적 과제: 읽기 전에 발생하는 검색 병목
이 논문의 과제는 ‘언어모델을 빠르게 한다’보다 구체적입니다. 희소 어텐션에서 읽을 토큰 수를 줄여도, 관련 토큰을 고르는 인덱서가 앞선 정보 전체를 훑어야 해 초장문에서 비용이 커지는 문제입니다. 계산을 생략할 대상뿐 아니라 생략 여부를 결정하는 과정에도 비용이 있다는 점을 드러냅니다.
해결수단: 학습 공간·군집·위치표·선택 경로의 결합
제가 주목하는 구성 관계는 학습된 검색 공간, 제한된 블록 안의 의미 기반 군집, 버킷 중심값과 원래 위치표의 저장, 질의별 버킷 선택, 실제 키·값으로의 복귀가 이어진다는 점입니다. 여기에 최근 window와 sink를 함께 포함하여 아직 군집화되지 않은 정보와 시작 부분의 정보를 처리합니다. Tree에서는 이 선택 경로를 여러 층의 후보 축소로 확장합니다.
차별적 구성과 확인된 효과를 함께 보기
연속 블록만 요약하는 방식과 비교하면 어떤 키를 같은 묶음에 넣는지가 다릅니다. 모든 묶음을 스캔하는 방식과 비교하면 Tree가 후보를 줄이며 내려가는 경로가 다릅니다. 기존 모델에 적용하는 D-LSA와 처음부터 학습하는 N-LSA는 같은 군집 검색 아이디어를 서로 다른 학습 연결 방식으로 구현합니다. 이 설명은 논문이 비교한 기술 구조에 대한 분석입니다.
실험에서 확인된 효과는 특정 초장문 조건의 검색·어텐션 시간 절감과 일부 정확도의 유지입니다. 반대로 Tree의 정확도 하락, 짧은 문맥의 추가 비용, N-LSA의 메모리 증가는 구성의 대가를 보여줍니다. 기술적 기여는 배속 하나보다 어떤 처리 관계가 어느 조건에서 이익과 비용을 만드는지 연결해서 볼 때 더 분명해집니다.
11. 마무리
LSA는 긴 문맥을 다루는 모델에서 무엇을 읽을지 선택하는 과정 자체를 설계 대상으로 삼은 연구입니다. 키를 학습된 공간에서 묶고, 대표값과 계층을 이용해 관련 위치로 돌아가는 구조는 희소 어텐션의 숨은 검색 비용을 줄이는 방향을 제시합니다.
다만 실제 이점은 문맥 길이, 검색 방식, 모델 구조, 병렬화 조건에 따라 달라집니다. Flat의 측정 성능과 Tree의 계산량 특성, 한 층의 배속과 전체 서비스 지연, 추론 결과와 소규모 네이티브 학습 결과를 나누어 읽어야 합니다. 이 구분을 지키는 것이 LSA의 기여와 아직 해결하지 못한 부분을 함께 이해하는 출발점입니다.
분석 대상 논문 · Latent Sparse Attention v1
아이피렉스의 AI 기술·특허 검토 업무를 확인해 보세요.