
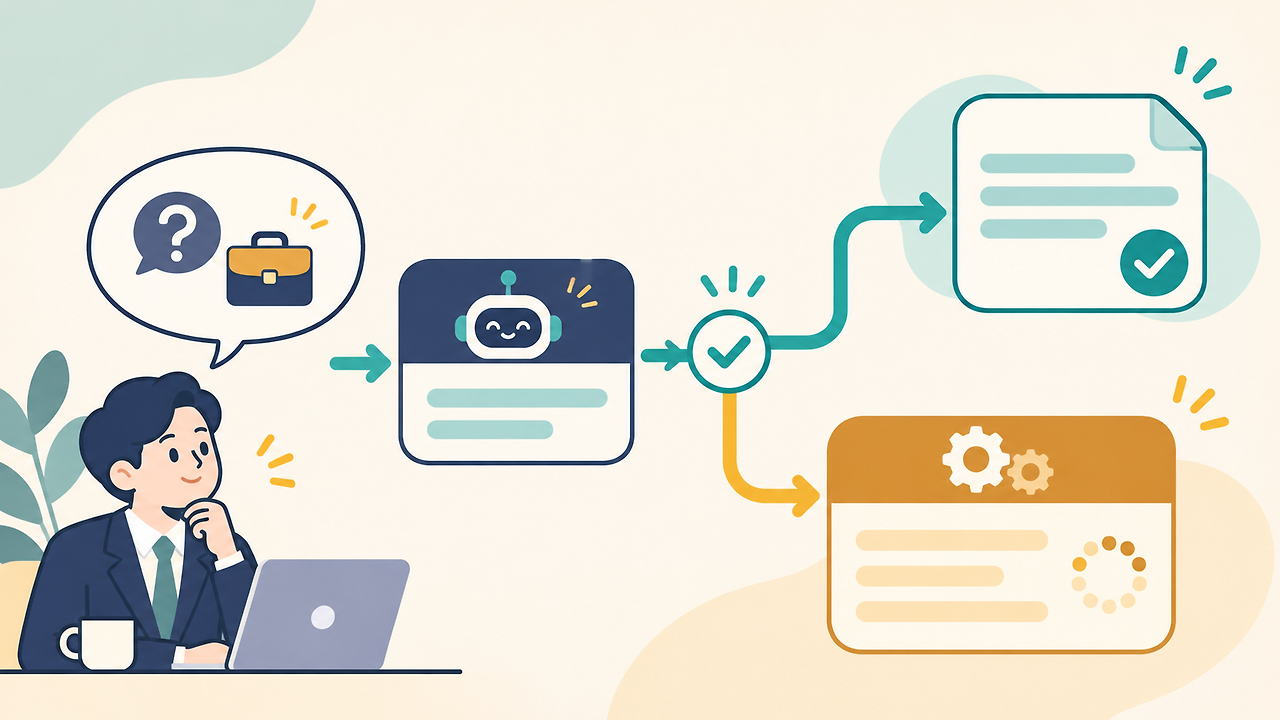
FrugalGPT aprende un orden de modelos y umbrales de parada. Después evalúa una respuesta ya generada para decidir si merece la pena otra llamada, a diferencia de una selección basada exclusivamente en la consulta inicial.
1. Generar, evaluar y decidir
En la versión final de 2024 publicada en TMLR por Lingjiao Chen y sus coautores, un modelo responde, un evaluador independiente puntúa la respuesta y un umbral determina si se devuelve o se continúa.
Si la cascada continúa, el siguiente modelo genera otra respuesta a la misma pregunta. El número efectivo de llamadas depende de las respuestas observadas.
El orden y los umbrales se optimizan conjuntamente bajo un presupuesto medio. No se garantiza que cada consulta cueste menos que una llamada a un único modelo.
2. Qué mide la puntuación
La implementación del artículo entrena un evaluador basado en DistilBERT para cada API. Utiliza la pregunta y la respuesta como entrada, con etiquetas que indican si la respuesta es correcta.
Es una predicción externa de calidad, no la confianza declarada por el modelo que responde. Una puntuación alta también puede ser errónea.
Un umbral más exigente suele implicar más llamadas y gasto a cambio de la posibilidad de mejores respuestas. Debe evaluarse junto con el orden aprendido.
Los costes de las respuestas y evaluaciones anteriores no desaparecen al elegir una respuesta posterior. La optimización considera calidad esperada y gasto medio entre consultas.
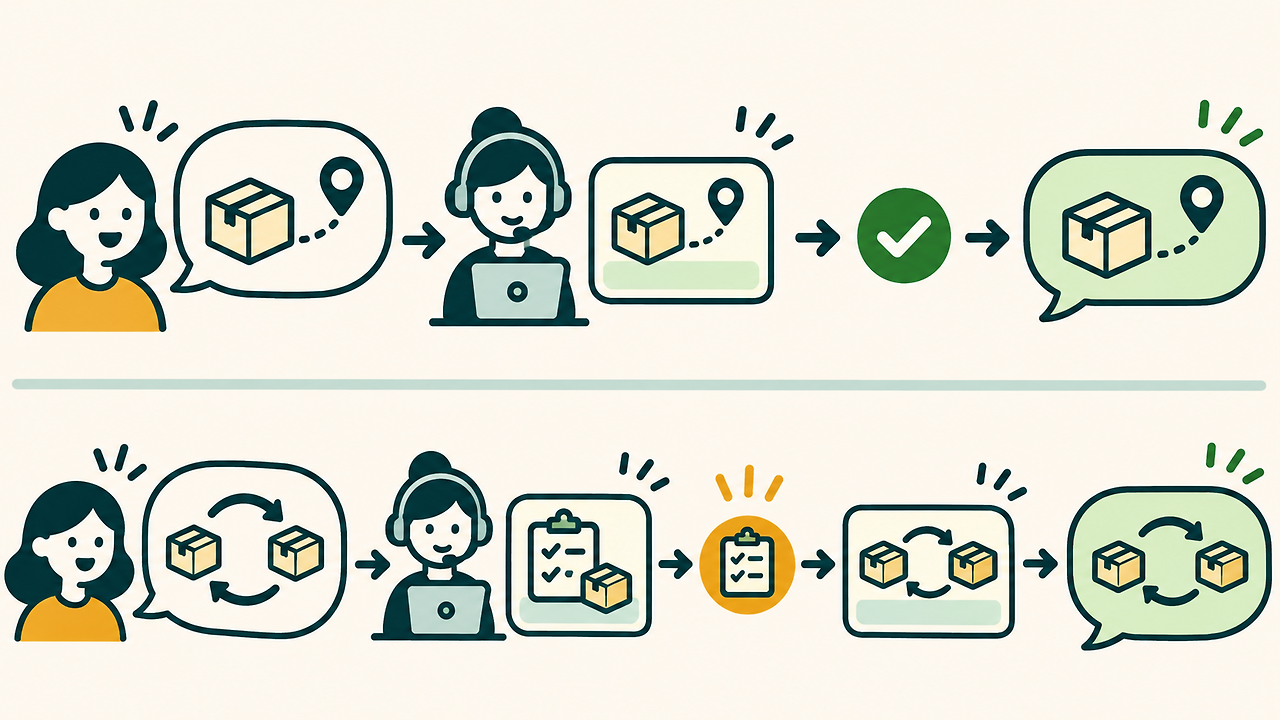
3. Dos consultas de envío hipotéticas
Una pregunta sencilla sobre dónde consultar el estado del envío puede resolverse con la primera respuesta. Si supera el umbral, no se llama al segundo modelo.
Se ahorran llamadas posteriores, no la primera generación ni su evaluación. Una respuesta plausible tampoco demuestra que se haya consultado el pedido del cliente.
Cambiar la dirección de un pedido parcialmente enviado desde varios almacenes plantea más condiciones. Una primera respuesta que proponga cambiar todos los artículos puede omitir sus distintos estados y provocar otra generación.
La respuesta posterior debe conservar los puntos que requieren comprobación. Si faltan datos del pedido, consultar su interfaz o derivar a una persona es un paso distinto: llamar a más modelos no modifica un pedido.
4. El alcance de las cifras publicadas
Los experimentos principales utilizaron 14 API de seis proveedores, con precios y resultados de marzo de 2023. Se dividieron los datos por mitades para entrenamiento y prueba, con un máximo experimental de tres modelos por consulta.
En HEADLINES, una clasificación de titulares financieros en cuatro categorías, la tabla 2 indica 33,1 USD para GPT-4 y 0,6 USD para FrugalGPT a igual precisión, con un ahorro publicado del 98,3 %. Son valores históricos redondeados, no tarifas actuales ni una garantía general.
La versión final también compara modelos de 2024 en HEADLINES y SCIQ, manteniendo iguales indicaciones y temperaturas dentro de esa comparación. Sus condiciones de modelos y precios difieren de las del experimento principal.
5. Medir calidad y latencia por separado
Las llamadas secuenciales pueden aumentar los tiempos de las respuestas más lentas aunque baje el gasto medio. Hay que incluir el evaluador, las derivaciones y la distribución de la latencia.
Una buena clasificación no acredita respuestas fiables sobre políticas complejas de entrega. Deben comprobarse condiciones, excepciones y afirmaciones infundadas de acceso a datos del cliente.
Los cambios de políticas, consultas o modelos pueden alterar la relación aprendida entre puntuación y calidad. La evaluación debe corresponder al servicio previsto, sin trasladar porcentajes históricos automáticamente.
6. Documentar el mecanismo técnico
Registre cada modelo, respuesta, puntuación, umbral y motivo de parada o continuación. Especifique también las condiciones que una respuesta debe cubrir.
La comparación con un sistema que decide solo a partir de la pregunta permite aislar el efecto de observar la respuesta. Debe distinguirse de simplemente añadir otra llamada.
Una memoria técnica debe describir entradas del evaluador, reglas aprendidas, derivación y posibles cambios de la siguiente entrada. Enumerar marcas de modelos no explica el proceso.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Los envíos son ejemplos hipotéticos. Los costes y porcentajes corresponden a las condiciones históricas del artículo.
Registro de publicación en OpenReview
Repositorio de investigación Stanford FrugalGPT
Lost in the Middle: por qué importa dónde aparece el documento con la respuesta
Consulte los proyectos de IA de IPLEX sobre selección de modelos, evaluación de calidad y lógica de derivación.
Conozca la experiencia de Yongduck Kim en IA