
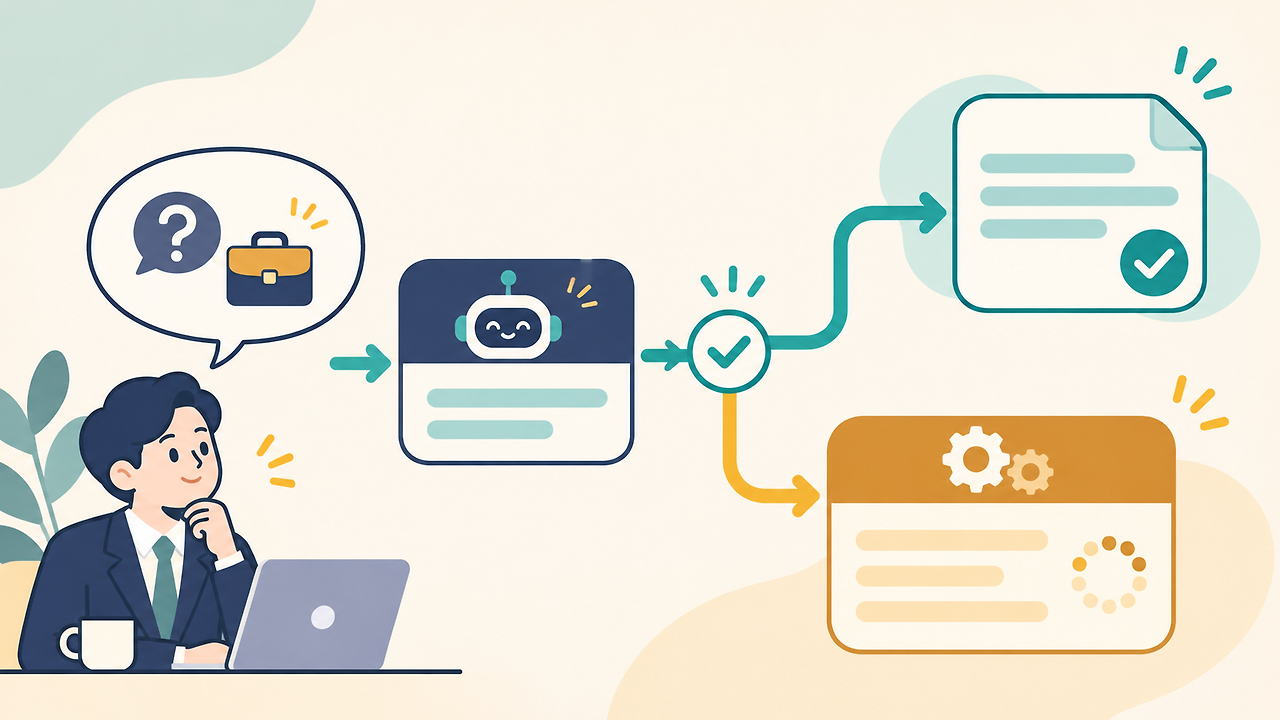
FrugalGPT先学习模型顺序与停止阈值,再根据已经生成的答案决定是否调用下一模型。它利用的是问题和实际答案,而不是仅凭输入提示预先分配模型。
1. 生成答案后再决定是否继续
Lingjiao Chen等人在TMLR 2024最终论文中描述:模型先作答,独立评分器评估答案,再由阈值决定返回结果还是继续级联。
继续时,下一个模型对同一问题生成新的答案。因此实际调用次数取决于运行过程中得到的回答。
模型顺序和阈值在平均预算约束下联合优化,并不保证每一个问题的成本都低于单模型调用。
2. 分数并非正确性的保证
论文实现采用基于DistilBERT的评分器,针对不同API分别训练。输入是问题与该API的答案,训练标签是答案是否正确。
这一分数是外部模型对质量的预测,不是回答模型的自信程度;高分答案仍可能有误。
提高停止阈值通常意味着增加调用和成本,以争取更高的回答质量。顺序与阈值需要作为整体评价。
即使最终选用后一个答案,前面的生成与评分成本也已经发生。优化对象是多个问题上的预期质量和平均支出。
3. 两个假设的配送问题
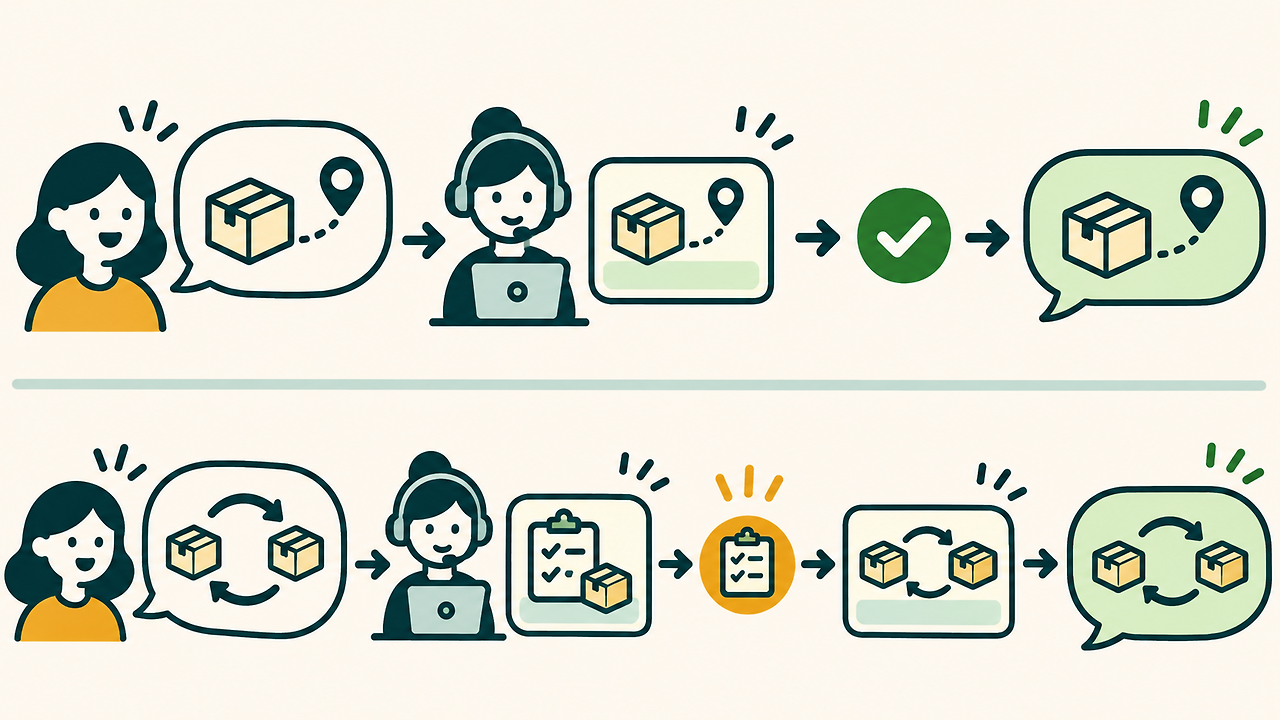
如果用户只问在哪里查看配送状态,第一个模型可能已给出足够的答案。评分达到阈值后,即可停止,不再调用第二个模型。
节省的是后续调用,而不是首次生成和评分。答案看起来合理,也不意味着系统已经查询了客户订单。
若问题涉及多个仓库、一部分商品已发货以及修改地址,条件就更复杂。第一份答案若只说修改全部商品地址,忽略发货状态差异,就可能触发再次生成。
后续答案应保留需要核实的条件。订单事实仍不明确时,查询订单界面或转人工是另一步骤;多调用语言模型不会自行修改订单。
4. 如何理解论文中的节省比例
主要实验使用6家提供者的14个API,价格及结果采集于2023年3月。数据一半用于训练、一半用于测试,该实验每个问题最多调用3个模型。
在金融新闻标题四分类任务HEADLINES上,表2报告相同准确率下GPT-4成本为33.1美元,FrugalGPT为0.6美元,节省比例为98.3%。这些是经过取整的历史实验数据,不代表现行价格或普遍保证。
最终论文还用2024年的新模型在HEADLINES和SCIQ上进行了比较,并在该组实验内保持相同提示和温度。其模型、价格条件与主要实验不同。
5. 成本下降不等于所有指标改善
串行调用可能降低平均API支出,却增加较慢请求的延迟。实际评估还应计入评分器、人工升级处理和延迟分布。
分类基准上的成功不能直接证明系统能可靠回答复杂配送规则。应检查必要条件、例外情况以及无根据声称已查询客户数据的问题。
规则、查询分布或模型发生变化后,原有评分关系也可能失效。需要在目标业务上重新评价,不能直接沿用过去的节省比例。
6. 技术说明需要保留什么
记录各阶段调用的模型、生成答案、评分、阈值及停止或继续的原因,并明确回答必须覆盖哪些条件。
与只根据问题进行预路由的基线比较,才能说明观察答案后再选择的作用,也应区别于单纯增加调用次数。
技术交底应说明评分器输入、学习得到的决策规则、升级处理和后续输入的修改方式。仅罗列模型品牌不能完整说明产生效果的处理流程。
图中保留原始标注与形态,相关内容在正文中说明。
配送场景为假设示例;成本和比例仅描述论文当时的实验条件。
读懂Lost in the Middle:答案文档放在什么位置也会影响结果
可通过IPLEX的AI项目及咨询准备资料,了解模型选择、质量评分和升级处理的技术整理。