
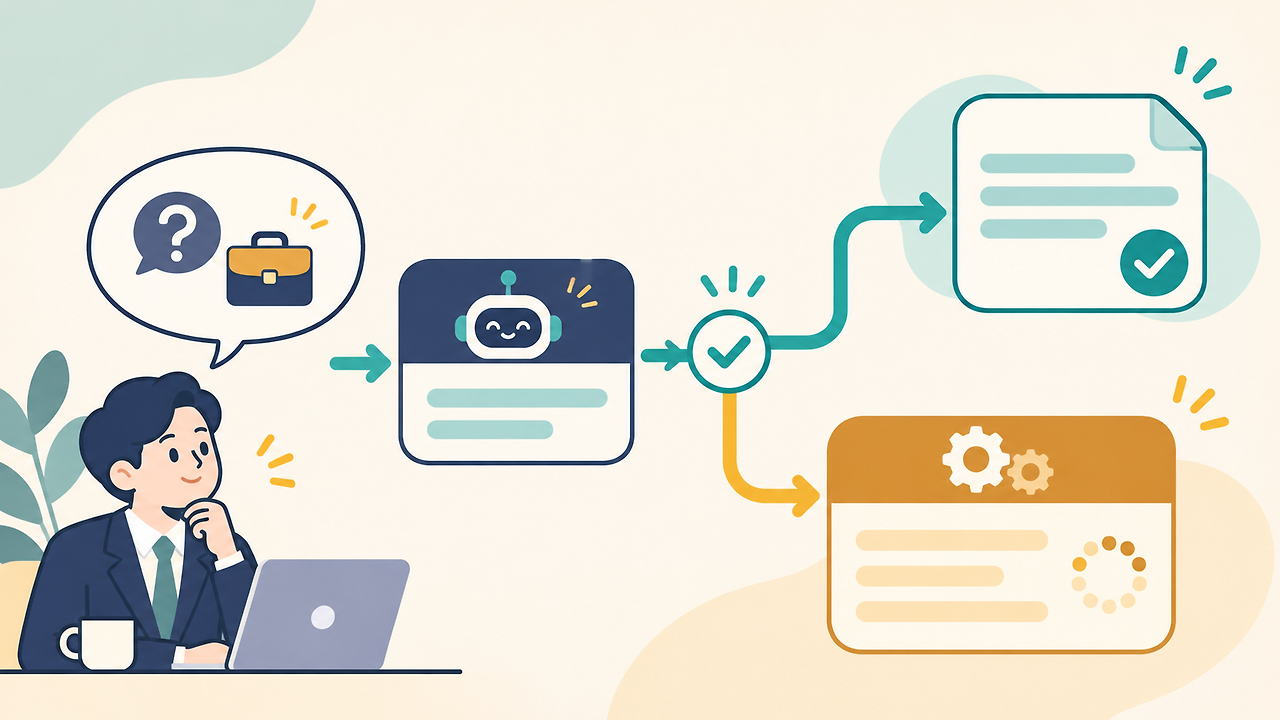
FrugalGPTはモデルの順番と停止しきい値を学習し、生成された回答を評価してから次のモデルを呼ぶか判断します。入力された質問だけで行う事前ルーティングとは、判断に使う情報が異なります。
1. 回答を見て止まるカスケード
Lingjiao ChenらのTMLR 2024最終版では、モデルが質問に回答し、別の評価器がその回答を採点します。しきい値に応じて回答を返すか処理を続けます。
続行する場合、次のモデルは同じ質問に新たな回答を生成します。実際の呼び出し回数は途中で得た回答によって変わります。
モデルの順番としきい値は、平均予算の制約の下で一緒に最適化されます。すべての質問が単一モデルより安く処理できるという意味ではありません。
2. 評価点は何を表すか
論文の実装では、APIごとにDistilBERTを基にした評価器を学習します。質問と回答を入力し、正誤のラベルを教師情報として使います。
これは外部の評価器による品質の推定であり、回答モデル自身の確信度ではありません。高い点数でも誤答はあり得ます。
停止しきい値を高くすると、追加呼び出しと費用を伴う代わりに、より良い回答を得られる可能性があります。順番としきい値を合わせて評価する必要があります。
後の回答を採用しても、それ以前の生成と採点の費用は残ります。最適化の対象は質問全体における期待品質と平均費用です。
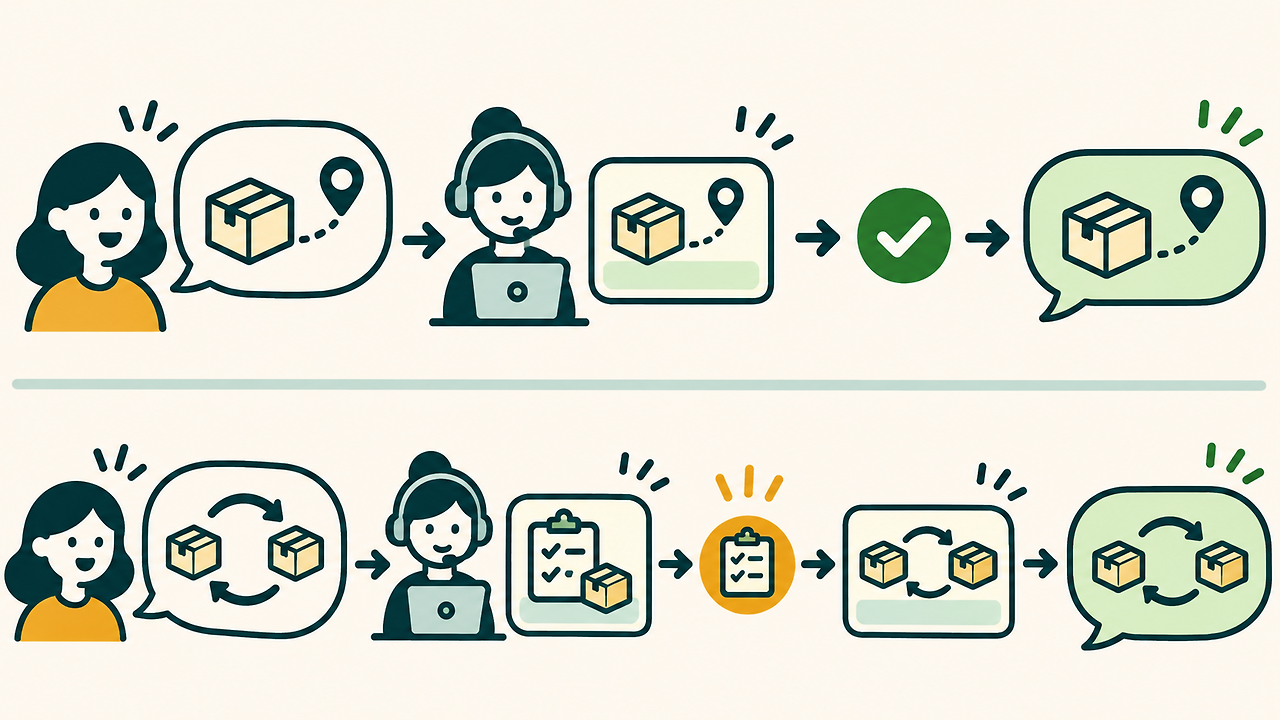
3. 配送に関する二つの仮想例
配送状況を確認する画面の場所を尋ねる簡単な質問なら、最初の回答で足りる場合があります。評価点がしきい値を超えれば、次のモデルを呼ばずに終了します。
省けるのは後続の呼び出しであり、最初の生成と採点ではありません。もっともらしい回答が出ても、顧客の注文情報を取得したことにはなりません。
複数倉庫から一部発送済みの注文について住所変更を尋ねる場合は複雑です。「すべての商品の住所を変える」という最初の回答が発送状態の違いを落とせば、追加生成に進みます。
次の回答でも、確認すべき条件を残す必要があります。注文の事実が不明なら、注文画面での確認や人への引き継ぎが別に必要で、モデルの追加呼び出しだけで注文は変更されません。
4. 論文の削減率を読む条件
主要実験は6提供者の14 APIを使い、価格と実験結果は2023年3月のものです。各データを学習用と評価用に半分ずつ分け、この実験では質問ごとのモデル数を最大3にしています。
金融見出しの4分類であるHEADLINESについて、表2は同じ正解率に達する費用をGPT-4の33.1米ドル、FrugalGPTの0.6米ドル、削減率を98.3%と報告しています。丸められた当時の数値であり、現在の料金や削減保証ではありません。
最終版には2024年の新しいモデルによるHEADLINESとSCIQの比較もあります。その比較内ではプロンプトと温度を揃えていますが、主要実験とはモデルや価格の条件が異なります。
5. 費用以外の評価も必要
逐次呼び出しは平均API費用を減らしても、遅い応答をさらに遅くする場合があります。評価器の処理、人への引き継ぎ、待ち時間の分布も含めて考えます。
分類課題の成果を、そのまま複雑な配送規定への回答品質とみなせません。必須条件や例外、顧客データを取得したと根拠なく述べる回答を確認します。
規定、質問の傾向、モデルが変われば採点の関係も変化します。過去の削減率を流用せず、対象業務のデータで見直します。
6. 技術の違いを記録する
各段階のモデル、回答、評価点、しきい値、停止または続行の理由を記録します。回答に必要な条件をどう表現するかも明確にします。
質問だけでモデルを選ぶ方式と比較すると、回答を見て判断する効果を説明できます。単に呼び出し回数を増やした効果とも区別します。
技術資料では、評価器の入力、学習した判断則、引き継ぎ、次の入力を変更する場合の内容を示します。モデル名の列挙だけでは処理の仕組みは伝わりません。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
配送例は仮想です。費用と削減率は論文当時の実験条件に基づきます。
Lost in the Middleを読む:根拠文書を置く位置で回答は変わるか
投機的デコーディング論文を読む:小さなモデルのドラフトでLLMの応答を速める仕組み
モデル選択、品質評価、引き継ぎの技術整理には、IPLEXのAIプロジェクトと相談準備資料をご覧ください。