
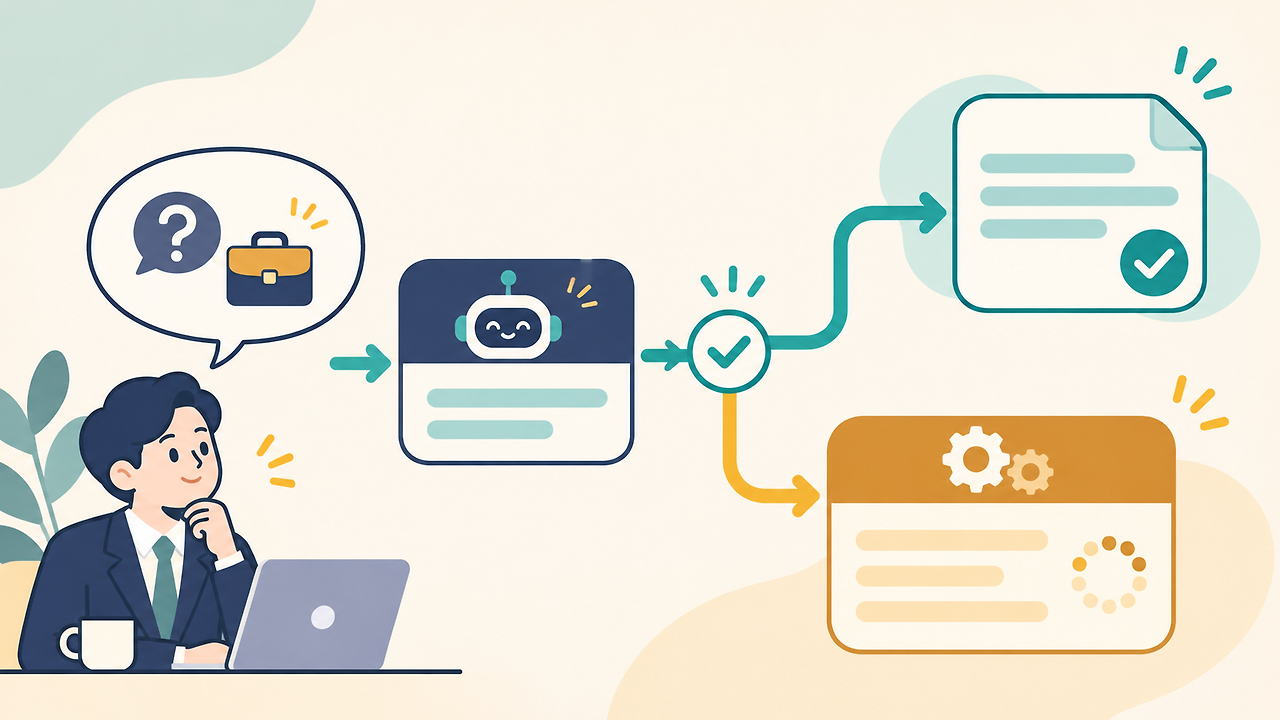
FrugalGPT обучает порядок моделей и пороги остановки, затем оценивает уже полученный ответ и решает, нужна ли следующая модель. Это отличается от маршрутизации, использующей только исходный запрос.
1. Сначала ответ, затем решение
В окончательной статье Lingjiao Chen и соавторов, опубликованной в TMLR в 2024 году, модель отвечает на вопрос, отдельный оценщик выставляет балл, а порог определяет остановку или продолжение.
При продолжении следующая модель заново отвечает на тот же вопрос. Число фактических вызовов зависит от получаемых ответов.
Порядок и пороги оптимизируются совместно при ограничении среднего бюджета. Метод не обещает, что каждый отдельный запрос обойдётся дешевле одного вызова.
2. Смысл оценки качества
В реализации статьи для каждого API обучается оценщик на базе DistilBERT. На вход поступают вопрос и ответ, а обучающая метка указывает правильность ответа.
Это внешняя оценка предполагаемого качества, а не уверенность отвечающей модели в себе. Высокий балл не исключает ошибку.
Более высокий порог обычно увеличивает число вызовов и стоимость ради возможности получить лучший ответ. Его необходимо оценивать вместе с порядком моделей.
При выборе позднего ответа расходы на предыдущие генерации и оценки сохраняются. Оптимизируются ожидаемое качество и средние затраты по совокупности запросов.
3. Два условных вопроса о доставке
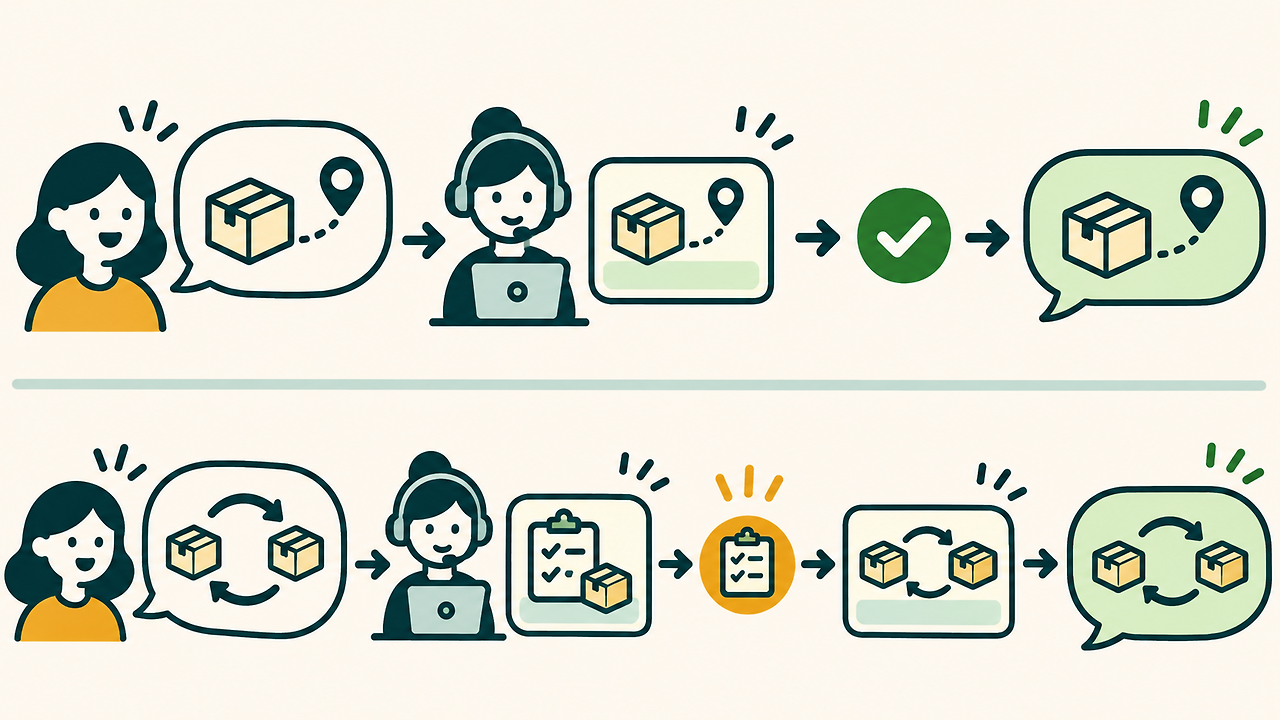
На простой вопрос о том, где посмотреть статус доставки, первый ответ может оказаться достаточным. При достижении порога каскад останавливается без второго вызова.
Экономия касается последующих вызовов, но не первой генерации и оценки. Правдоподобный текст также не означает, что система получила сведения о заказе клиента.
Изменение адреса частично отправленного заказа с товарами на нескольких складах требует большего числа условий. Ответ «изменить адрес для всех товаров» может пропустить различие статусов и вызвать следующую генерацию.
Новый ответ должен сохранять условия, требующие проверки. Если факты о заказе неизвестны, обращение к интерфейсу заказа или сотруднику остаётся отдельным этапом; дополнительные вызовы модели сами заказ не меняют.
4. Как читать опубликованную экономию
Основные эксперименты использовали 14 API шести поставщиков; цены и результаты собраны в марте 2023 года. Данные делили поровну на обучение и тест, а число моделей на запрос в этих опытах ограничивали тремя.
Для HEADLINES, классификации финансовых заголовков по четырём категориям, таблица 2 указывает 33,1 доллара для GPT-4 и 0,6 доллара для FrugalGPT при равной точности, с заявленной экономией 98,3 %. Это округлённые исторические данные, не текущие тарифы и не универсальная гарантия.
В окончательной статье есть и сравнение моделей 2024 года на HEADLINES и SCIQ с одинаковыми запросами и температурами внутри этой серии. Условия моделей и цен отличаются от основного эксперимента.
5. Стоимость не заменяет другие показатели
Последовательные вызовы способны увеличить время самых медленных ответов при снижении средних расходов. Нужно учитывать оценщик, работу сотрудников и распределение задержек.
Успех в классификации не доказывает надёжность ответов о сложных правилах доставки. Следует проверять обязательные условия, исключения и необоснованные заявления о просмотре данных клиента.
Изменения правил, запросов или моделей могут нарушить выученную связь балла с качеством. Исторический процент нельзя автоматически переносить на новую рабочую задачу.
6. Что включить в техническое описание
Фиксируйте модель, ответ, балл, порог и причину остановки либо продолжения на каждом этапе. Определите, какие условия должен содержать ответ.
Сравнение с маршрутизацией только по вопросу помогает выделить эффект оценки готового ответа. Его нужно отличать от результата простого увеличения числа вызовов.
Техническое описание должно раскрывать входы оценщика, обученные правила, передачу человеку и изменения следующего входа. Перечень названий моделей сам по себе механизма не объясняет.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Примеры доставки условные. Цены и проценты относятся к историческим условиям экспериментов статьи.
Окончательная статья TMLR 2024
Исследовательский репозиторий Stanford FrugalGPT
Lost in the Middle: почему важно положение документа с ответом
Разбор спекулятивного декодирования: как черновик небольшой модели ускоряет ответы LLM
Ознакомьтесь с проектами ИИ IPLEX по выбору моделей, оценке качества и передаче сложных запросов.
Опыт патентного поверенного Ким Ёндока в области ИИ