
Traducir una descripción de producto exige trabajar con términos especializados y listas breves de características, además del lenguaje cotidiano. Esta solicitud de patente de Alibaba explica cómo preparar un modelo de traducción mediante el enriquecimiento de las representaciones del vocabulario y la selección de datos de entrenamiento. El ejemplo ficticio de un vendedor de artículos de acampada permite distinguir la preparación del modelo de la traducción posterior de un texto nuevo.
1. Por qué cuesta traducir una descripción de producto
Pensemos en un equipo que prepara una oferta para el extranjero. El texto coreano enumera una «silla plegable de acampada con estructura de aluminio · ligera · portátil». No es una oración completa, sino una lista de material, estructura y uso. Sustituir las palabras una a una no basta necesariamente para presentar el producto con naturalidad. ¿Cómo se prepara un modelo para manejar términos de producto que no conoce bien?
Los nombres de productos combinan marcas, expresiones regionales y vocabulario sectorial. Incluso palabras habituales pueden formar combinaciones propias de una categoría comercial. La traducción debe conservar relaciones como de qué está hecho el objeto y para qué sirve.
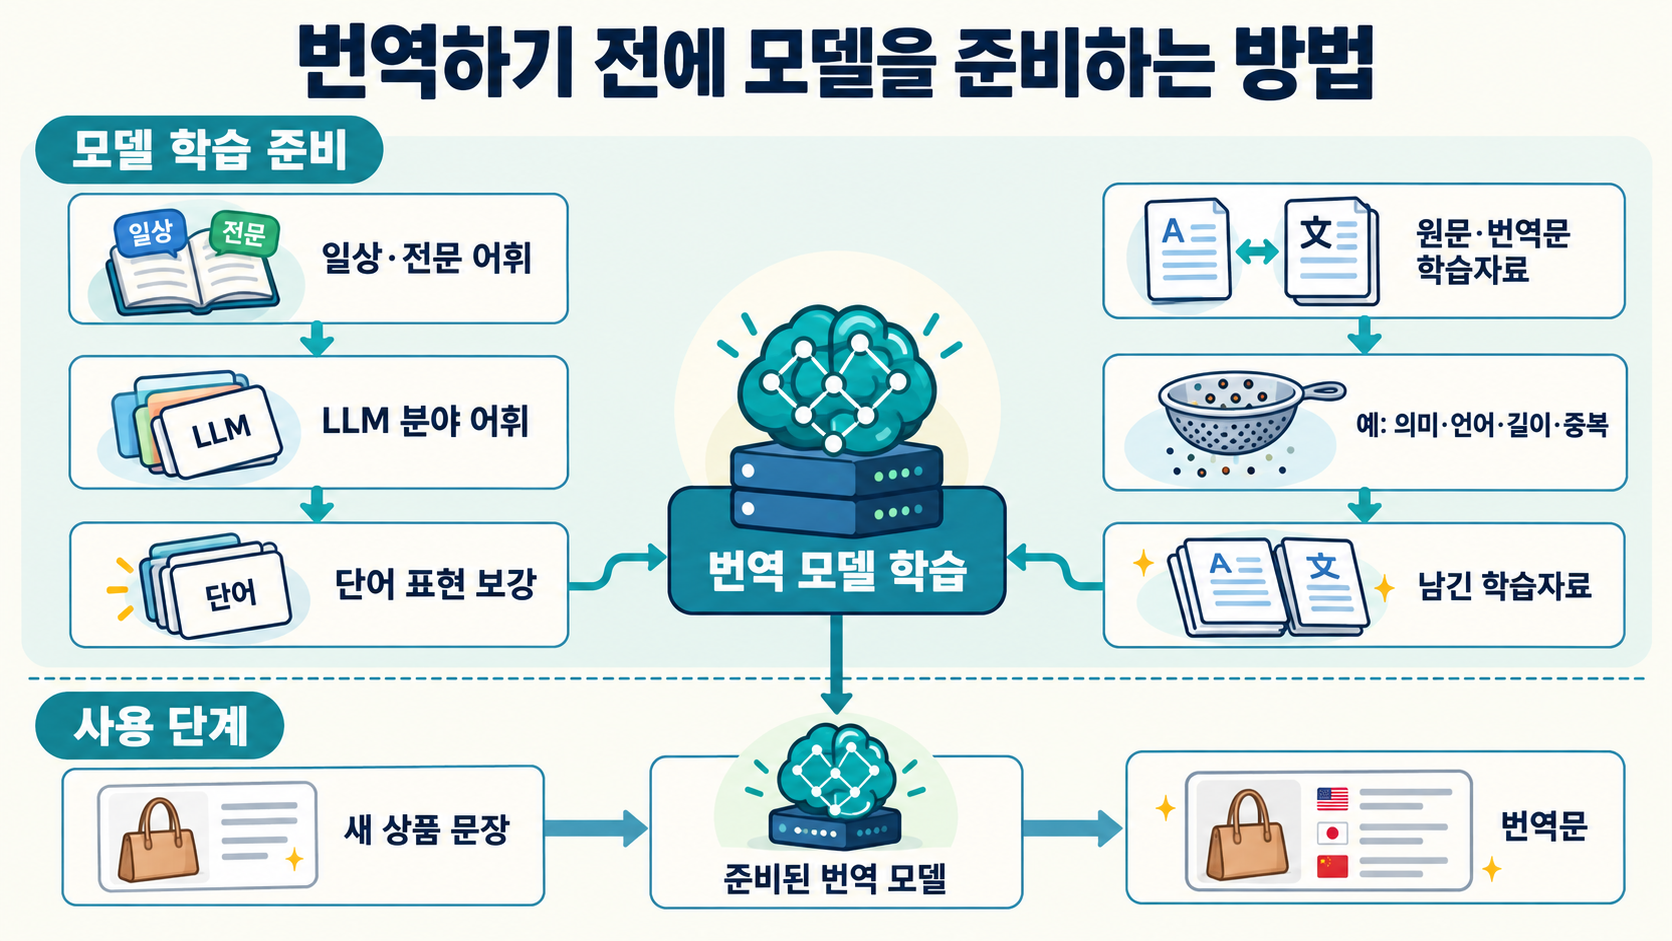
La solicitud aborda la preparación del vocabulario y los datos antes de generar traducciones. Propone ampliar el vocabulario, enriquecer la información que representa las palabras, seleccionar material conforme a criterios de calidad y entrenar el modelo con los datos retenidos.
Conviene separar esa preparación del tratamiento de una nueva petición. El vocabulario especializado interviene al preparar el modelo. Más adelante, el texto que se desea traducir se introduce en el modelo ya entrenado para obtener el resultado en la lengua de destino.
2. El vocabulario y su representación numérica
Aquí llamamos vocabulario al conjunto de palabras y expresiones que el modelo puede procesar. En la solicitud, ese conjunto incluye identificadores, expresiones en distintos idiomas y vectores de características. Un vector de características es un conjunto de valores numéricos que permite utilizar información semántica en los cálculos.
Ampliar el vocabulario significa incorporar de antemano las expresiones que el modelo deberá manejar. La solicitud contempla tanto palabras cotidianas como marcas, expresiones geográficas y culturales, y terminología del comercio electrónico. Así se incorporan al material de aprendizaje las expresiones necesarias para el ámbito del producto.
En el ejemplo ficticio de acampada, cabe pensar en combinaciones como «silla plegable» o «estructura de aluminio». Añadir un nombre a una lista y lograr que el modelo utilice su representación son cuestiones distintas. Aumentar el número de identificadores no explica por sí solo todo el mecanismo.
El modelo descrito tiene un codificador, que convierte la información de entrada en representaciones, y un decodificador, que genera la traducción. Las entradas del vocabulario y sus vectores proporcionan material para estos cálculos. La forma de prepararlos se vincula, por tanto, con el entrenamiento posterior.
3. Enriquecer las representaciones con vocabulario de un LLM
Un modelo de lenguaje de gran tamaño, o LLM, se entrena con grandes cantidades de texto. La solicitud describe cómo pedirle términos especializados de un ámbito concreto y utilizar su respuesta para ajustar los vectores de características del vocabulario del modelo de traducción.
En el caso del vendedor ficticio, la petición podría referirse a términos de artículos de acampada y sus expresiones equivalentes. El LLM aporta material léxico del sector. Después, ese material sirve para adaptar las representaciones del modelo de traducción a la terminología pertinente.
Un vector numérico puede entenderse como unas coordenadas que representan significado. Permite tratar computacionalmente las relaciones de una palabra con otras. El vínculo técnico descrito consiste en enriquecer esas representaciones con el vocabulario especializado obtenido del LLM.
Enumerar las entradas y salidas aclara la función de cada etapa: una consulta sobre un ámbito entra en el LLM, este devuelve vocabulario especializado y el procesamiento siguiente ajusta las representaciones del modelo de traducción. Traducir la nueva descripción de un cliente corresponde a la fase posterior de uso del modelo preparado.
4. Seleccionar pares de frases para el entrenamiento
El entrenamiento de traducción puede utilizar pares formados por una frase original y su traducción correspondiente. El conjunto de esos pares constituye un corpus paralelo. Aunque se reúna mucho material público, puede contener lenguas mal identificadas, significados que no se corresponden o datos duplicados.
La solicitud describe la depuración del corpus para conservar los datos que satisfacen criterios de calidad. Entre ellos figuran la proximidad semántica de ambas frases, la coincidencia con las lenguas de origen y destino indicadas, una proporción de longitudes adecuada y la detección de duplicados.
Una descripción de una silla de acampada emparejada con información de un producto totalmente distinto no constituye un buen ejemplo de aprendizaje. También conviene examinar pares en los que un lado es anormalmente largo o que se repiten varias veces. El objeto de esta selección son las frases con las que aprenderá el modelo.
Cada método examina una propiedad diferente de los datos. Distinguir la comparación semántica, la identificación de la lengua y la eliminación de duplicados ayuda a explicar qué ejemplos se conservan. La solicitud no debe interpretarse como una receta única que exija aplicar todos los criterios siempre en el mismo orden y con los mismos umbrales.
5. Entrenar con el corpus seleccionado y controlar las repeticiones
Una vez enriquecidas las representaciones y seleccionados los datos, el modelo se entrena con ese material. El entrenamiento ajusta parámetros de cálculo internos para aprender las relaciones entre las entradas y sus traducciones. La solicitud contempla el uso de distintos métodos de aprendizaje.
Otra cuestión es la repetición excesiva de expresiones en la traducción generada. Las descripciones de productos suelen contener listas breves de palabras clave y pueden producir secuencias repetitivas en la salida. La solicitud incorpora tratamientos adicionales para abordar ese comportamiento.
Eliminar ejemplos duplicados del corpus y reducir las repeticiones de la salida actúa sobre objetos distintos. En el primer caso se comprueba si un mismo par de frases aparece varias veces en los datos. En el segundo se ajusta la tendencia del modelo a reiterar expresiones mientras genera una traducción.
Los métodos descritos incluyen penalizar los tokens repetidos, buscar entre candidatos de salida y ajustar la tendencia a repetir durante el entrenamiento o la predicción. Un token es una pequeña unidad de texto que procesa el modelo. Se trata de controlar la generación, no de borrar indiscriminadamente palabras repetidas que sí sean necesarias para expresar el original.
La documentación de desarrollo puede separar la preparación del vocabulario, la selección del corpus, el entrenamiento y el control de la generación. Esa estructura ayuda a explicar qué modificación de una etapa alteró un comportamiento concreto del modelo.
6. Ejemplo ficticio de artículos de acampada
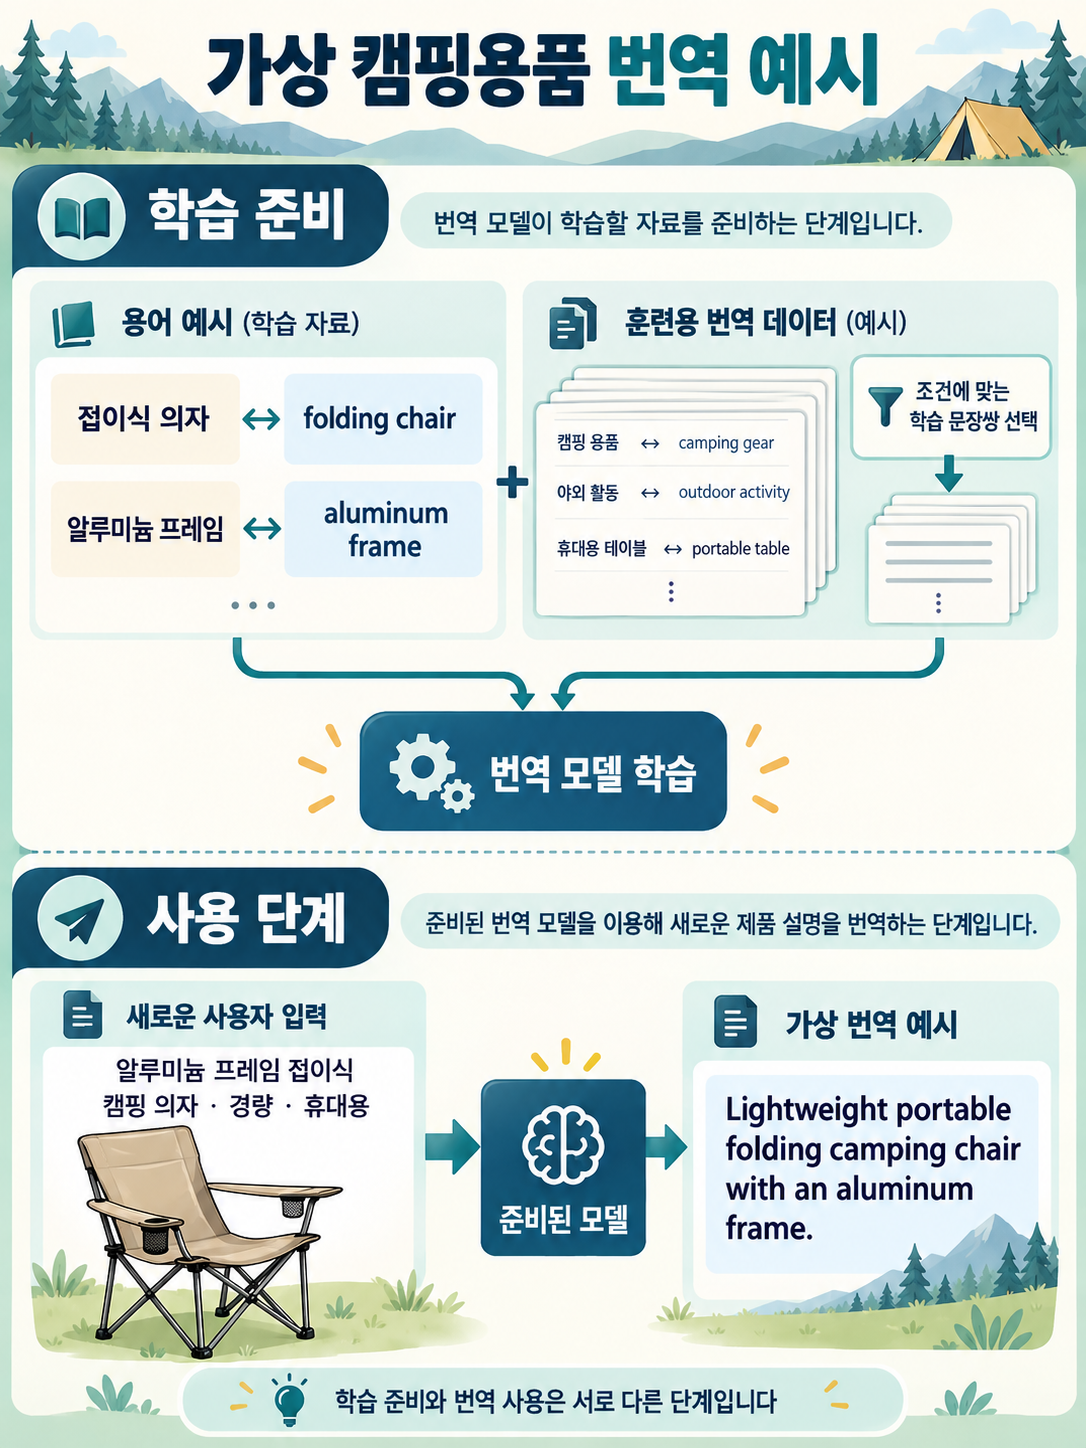
Sigamos a un equipo que quiere presentar artículos de acampada en inglés. Durante la preparación incluye términos del sector junto con palabras cotidianas y utiliza vocabulario obtenido de un LLM para enriquecer las representaciones. «Silla plegable» y «estructura de aluminio» son ejemplos escogidos para facilitar la explicación.
Por otra parte, selecciona pares de originales y traducciones según criterios pertinentes de significado, lengua y duplicación. Tras entrenar el modelo con el material retenido, puede pasar a la fase de uso e introducir una descripción de producto nueva.
El nuevo texto coreano enumera la estructura de aluminio, la silla plegable de acampada, su ligereza y su portabilidad. Una traducción inglesa ilustrativa sería: «Lightweight portable folding camping chair with an aluminum frame.» La frase reúne material, estructura plegable, uso para acampada, ligereza y facilidad de transporte.
No se pretende presentar esa frase como la única traducción correcta. El objetivo es seguir tres operaciones distintas: preparar el vocabulario del sector, seleccionar los pares de entrenamiento y traducir un original nuevo con el modelo entrenado. La separación entre preparación y uso aclara qué entrada interviene en cada operación.
7. Qwen-MT y el diseño de servicios de traducción
Qwen-MT, de Alibaba Cloud, es un modelo que traduce textos de una lengua a otra. Su documentación oficial explica cómo indicar las lenguas de origen y destino y proporcionar correspondencias terminológicas, ejemplos de traducciones existentes e información sobre el ámbito para orientar el resultado.
Una correspondencia terminológica indica qué expresión de destino debe utilizarse para un término del original. La memoria de traducción aporta pares de frases originales y traducciones de referencia. Una instrucción de dominio describe el campo y el estilo deseados. Son recursos para una petición concreta, y no un mecanismo para conservar toda una conversación continua.
Los equipos que utilizan estas funciones pueden diseñar cómo facilitar nombres de productos, marcas y avisos recurrentes. Si además desarrollan un modelo propio, pueden documentar por separado su preparación: vocabulario, representaciones de palabras, composición del corpus y control de las repeticiones de salida.
La diferencia técnica que interesa en esta solicitud de Alibaba va más allá del resultado «la traducción ha mejorado». Importa de dónde procede la terminología, qué datos se conservan para entrenar y en qué etapa se controla la repetición. Relacionar las entradas, las operaciones y los resultados que pasan a la etapa siguiente permite explicar con precisión el funcionamiento.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Servicio relacionado: patentes de IA
Consulte los análisis de tecnología y patentes de IA, las publicaciones y los servicios de asesoramiento técnico de IPLEX.
US20250173522A1 es una solicitud de patente publicada. Este artículo no determina su concesión, validez ni la existencia de infracción. La documentación de Qwen-MT se examina por separado y no acredita que el servicio implemente el método descrito en la solicitud.
Artículo técnico original en Tistory
Solicitud de patente estadounidense publicada US20250173522A1
Alibaba Cloud: guía de uso de Qwen-MT
Alibaba Cloud: documentación de la API de Qwen-MT
La patente de traducción visual de Naver: cómo alinear el texto cuando se mueve la cámara
Cómo aborda Baidu los conflictos entre respuestas del modelo y conocimiento recuperado