
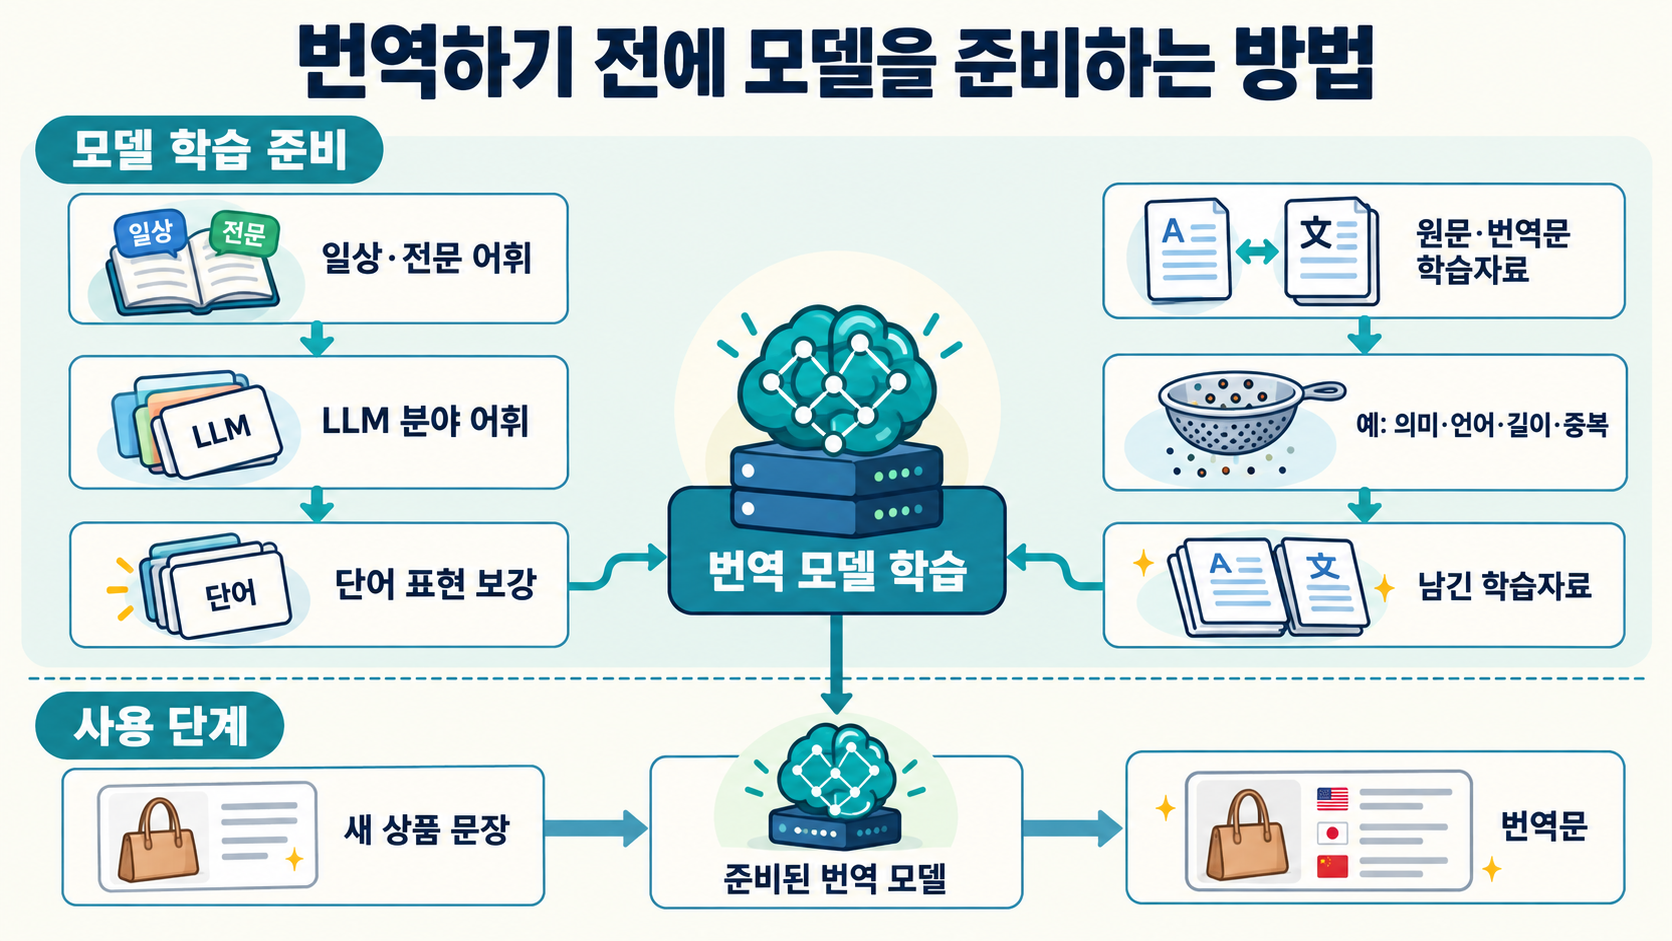
翻译商品描述,不仅要处理日常用语,还要处理专业术语和简短罗列的产品特征。阿里巴巴这件公开专利申请介绍了如何通过增强词汇表示、筛选训练数据来准备翻译模型。下面以一个虚构的露营用品卖家为例,说明模型训练与翻译新的商品描述之间的衔接。
1. 商品描述为什么难翻译
假设一个准备开展跨境销售的团队,需要翻译一段韩语商品介绍,其内容相当于“铝制框架折叠露营椅·轻量·便携”。这更像是材质、结构和用途的简短清单,而不是完整句子。逐词替换未必能自然地传达商品特征。那么,翻译模型如何为陌生的商品术语做好准备?
商品名称往往混合品牌名、地区表达和行业用语。即使是日常熟悉的词,在特定商品领域中也可能形成特殊搭配。翻译需要说明产品用什么材料制成、适用于什么场景等关系。
这件申请关注的是生成译文之前,如何准备模型所使用的词汇和训练数据。其思路是先扩充词汇、增强词语的表示信息,再按质量标准筛选训练材料,用保留下来的数据训练模型。
把训练准备与处理新的翻译请求分开,技术流程就更清楚了。专业词汇参与模型的准备;模型训练完成后,再输入实际需要翻译的新原文,获得目标语言的结果。
2. 词汇及其数值表示
这里把模型需要处理的词语和表达的集合称为词汇表。申请记载的词汇表包含词语标识编号、不同语言中的表达以及特征向量等信息。特征向量是一组数值,用于把语义信息转化为可参与计算的表示。
扩展词汇,就是预先增加模型能够处理的表达。申请列举的对象不仅有日常词汇,还包括品牌名称、地理和文化表达、电子商务专业词汇等。这是把商品领域所需表达纳入学习材料的起点。
在虚构的露营用品示例中,可以考虑“折叠椅”“铝制框架”等搭配。把名称加入列表,与让模型能够有效利用这些表达,是两个不同的问题。因此,不能仅以词语编号数量增加来解释整个过程。
申请描述的翻译模型具有编码器和解码器:前者把输入信息转化为表示,后者生成译文。词汇与特征向量是这些计算所使用的材料。准备阶段如何组织这些材料,会影响后续的训练。
3. 用大语言模型提供的领域词汇增强表示
大语言模型(LLM)是利用大量文本训练的语言模型。这件申请描述了向LLM请求特定领域的专业词汇,再利用输出结果调整翻译模型词汇特征向量的方法。
对虚构的卖家而言,可以向LLM询问露营用品的术语及对应表达。LLM提供的是领域词汇材料,后续处理利用这些材料,使翻译模型的词汇表示更适合相关专业用语。
可以把数值向量理解为承载意义的坐标,用于在计算中表达某个词与其他词的关系。这里的技术联系是:利用从LLM获得的专业词汇,增强翻译模型中的词汇表示。
列明输入和输出,就能看清各自的作用。指定领域的问题输入LLM,得到专业词汇;下一步利用这些词汇调整翻译模型的表示。客户新商品描述的实际翻译,则发生在使用准备好的模型的阶段。
4. 筛选用于训练的双语句对
翻译训练可以使用由原文及其对应译文组成的句对。这样的数据集合称为平行语料库。公开数据即使数量很大,也可能混入语言标注错误、内容不对应或重复的数据。
申请描述了通过数据清洗保留符合质量标准的语料。可以采用的标准包括两句话的语义接近程度、是否符合指定的源语言和目标语言、长度比例是否合理,以及是否存在重复。
例如,露营椅介绍如果配上完全不同商品的译文,就难以成为有效的训练样本。一侧异常冗长,或者同一句对出现多次,也需要检查数据的构成。这里筛选的是用来训练模型的句对。
不同筛选方法考察数据的不同属性。把语义比较、语言识别和去重区分开,更容易解释哪些材料会被保留。不能将这些方法理解为必须始终按相同顺序、采用相同阈值执行的一套固定程序。
5. 利用筛选后的语料训练,并控制重复输出
词汇表示得到增强、训练数据完成筛选后,就可以用这些材料训练翻译模型。训练通过调整内部计算参数,让模型学习输入与译文之间的关系。申请描述了可采用多种训练方法的形式。
另一个问题是译文中同类表达的过度重复。商品介绍经常由简短关键词组成,输出时也可能连续出现近似词语。申请还提出了处理这种重复的附加方法。
训练数据去重与抑制输出重复,作用对象并不相同。前者检查同一句对是否在语料中多次出现;后者调整模型在生成译文时反复输出相似表达的行为。
申请涉及的方法包括对重复词元施加惩罚、搜索输出候选,以及在训练或预测阶段调整重复倾向。词元是模型处理文本的小单位。这些措施用于控制生成过程,不是把原文确实需要的重复词一律删掉。
编写开发文档时,可以分别记录词汇准备、训练数据筛选、模型训练和生成控制。这样,当结果发生变化时,就更容易说明是哪一阶段的改动影响了哪种行为。
6. 虚构露营用品的英译过程
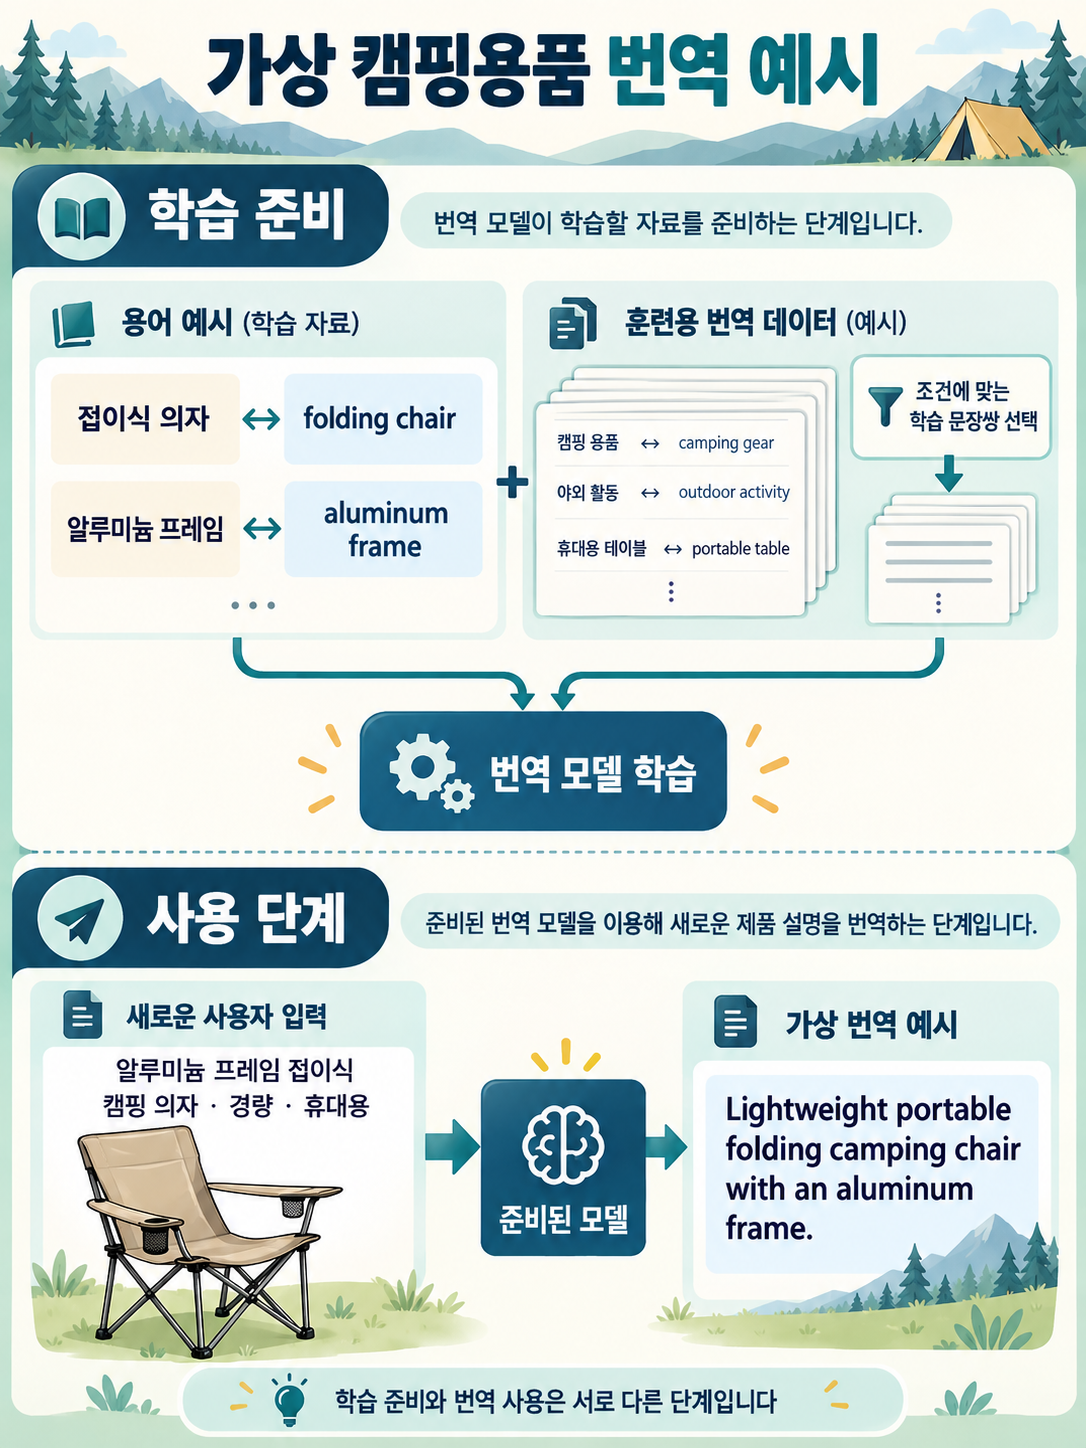
设想一个用英语介绍露营用品的销售团队。在训练准备阶段,团队把露营用品的专业表达与日常词汇一并纳入词汇表,再用LLM提供的领域词汇增强词语表示。“折叠椅”和“铝制框架”是为便于理解而选取的示例。
对于原文与译文成对的数据,团队根据语义、语言和重复情况等适用标准,筛选句对形成训练材料。模型完成训练后,流程转入使用阶段,由销售团队输入新的商品介绍。
新的韩语原文列出了铝制框架、折叠露营椅、轻量和便携等特点。说明性的英文译例是:“Lightweight portable folding camping chair with an aluminum frame.”它把材质、折叠结构、露营用途、轻量和便携性整合为一句介绍。
这个例子不是要把某一句译文设定为唯一正确答案,而是分别展示领域词汇准备、训练句对筛选以及训练好的模型翻译新原文的过程。区分准备与使用,才能明确每项输入究竟用于哪个处理环节。
7. Qwen-MT与翻译服务设计
阿里云的Qwen-MT是将原文翻译成其他语言的模型。官方文档介绍了指定源语言和目标语言,并提供术语对应表、既有对译示例和领域说明来调节翻译的功能。
术语对应表用于指定某个原文表达应采用的译法;翻译记忆提供原文与参考译文的句对;领域提示说明所属领域和期望文体。更准确的理解是,为一次翻译请求准备必要的参考材料,而不是让模型持续记住整个对话。
使用这些功能的团队,可以设计如何传入商品名、品牌名和反复使用的说明文字。同时,开发自有模型的团队,可以单独记录词汇表、词语表示、训练语料构成以及重复输出控制等模型准备环节。
阅读这件阿里巴巴申请时,需要关注的技术差异不只是“翻译变好了”这一结果,还包括专业词汇从哪里进入、哪些材料被保留用于训练,以及在哪个环节控制重复。把输入、处理步骤和传递到下一步的结果联系起来,技术方案会更清晰。
图中保留原始标注与形态,相关内容在正文中说明。
了解IPLEX的AI技术与专利分析、相关著作和技术咨询服务。
US20250173522A1是一件公开专利申请。本文不判断其授权状态、权利有效性或侵权问题。Qwen-MT产品文档另作介绍,并不能据此确认该服务实施了申请所披露的方法。