
商品説明の翻訳では、日常語だけでなく専門用語や短く列挙された特徴も扱う必要があります。アリババの公開特許出願は、語彙の表現を補強し、学習データを選別して翻訳モデルを準備する方法を説明しています。架空のキャンプ用品販売者を例に、モデルの学習と、新しい商品説明を翻訳する段階とのつながりを見ていきます。
1. 商品説明が翻訳しにくい理由
海外販売を準備するチームが、韓国語で「アルミフレームの折り畳み式キャンプチェア・軽量・持ち運び可能」に相当する商品説明を翻訳するとします。これは文章というより、素材、構造、用途を短く並べた表現です。単語を一つずつ置き換えるだけでは商品の特徴は自然に伝わりません。なじみのない商品用語を扱うため、翻訳モデルにはどのような準備が必要でしょうか。
商品名にはブランド名、地域特有の表現、業界用語などが混在します。日常的な単語でも、商品分野では特有の組み合わせで使われます。何がどの素材で作られ、どの用途に使われるかという関係も訳文に反映させる必要があります。
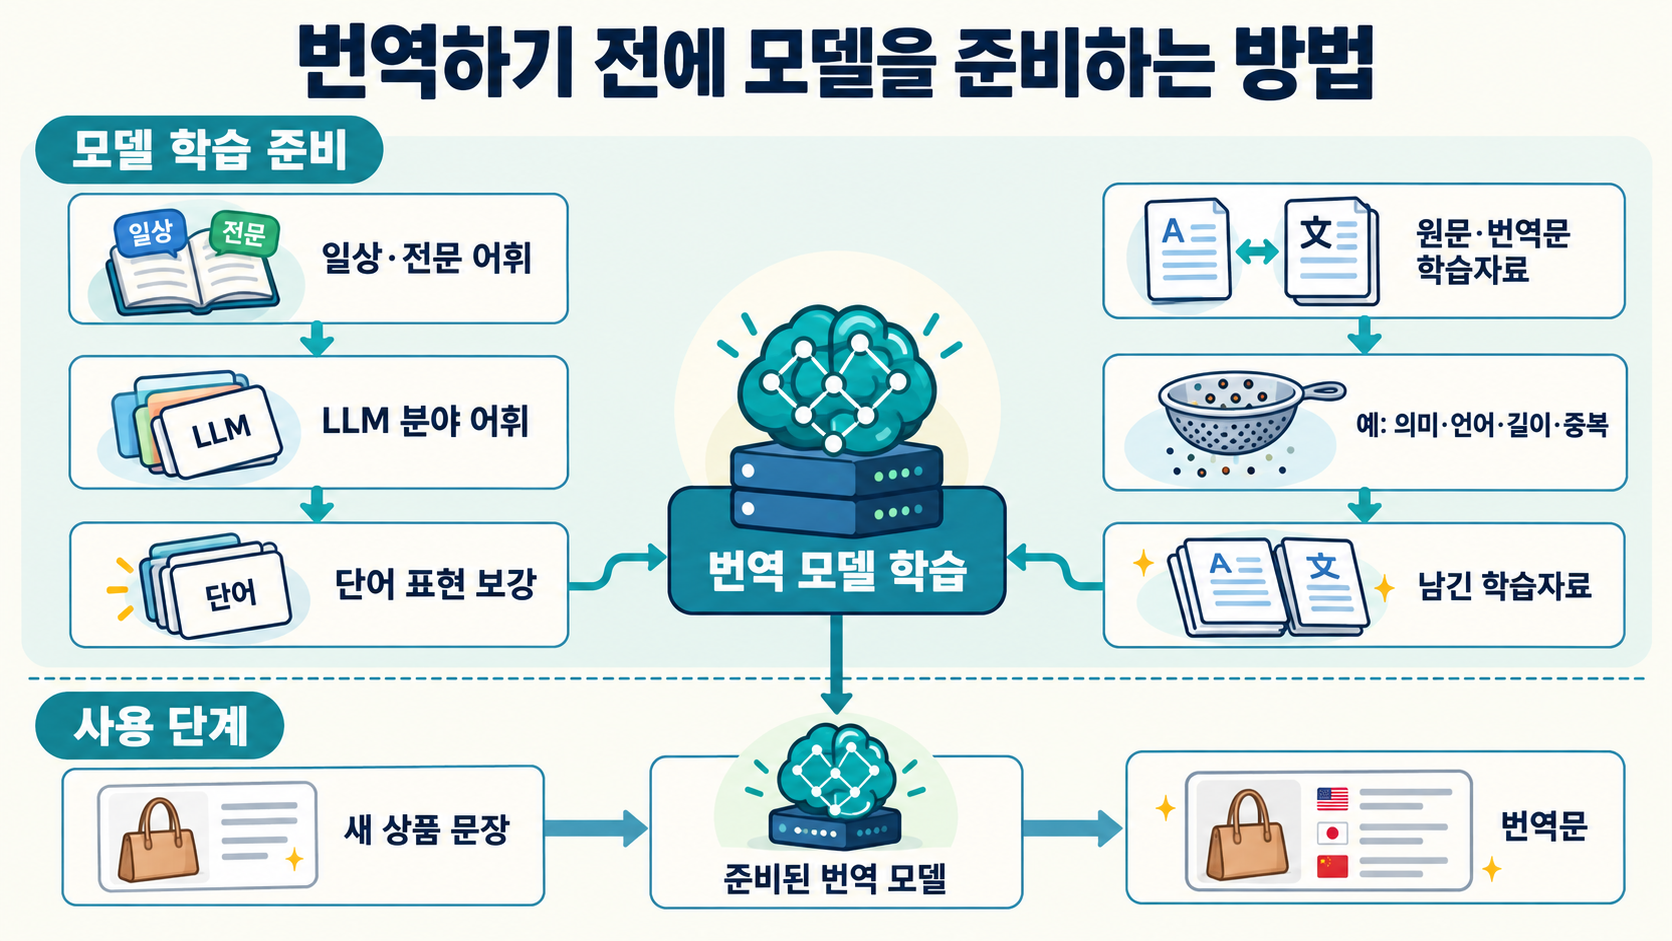
この出願が扱うのは、翻訳結果を生成する前に、モデルが扱う語彙と学習データを整える方法です。語彙を広げ、単語を表す情報を補強し、品質基準に合うデータを選んだ上でモデルを学習させます。
学習の準備と、新しい翻訳依頼の処理を分けると役割が明確になります。専門語彙はモデルの準備に使われ、その後、学習済みモデルに新しい原文を入力して目的言語の訳文を得ます。
2. 語彙と数値による表現
ここでは、モデルが扱う単語や表現の集合を語彙リストと呼びます。出願に記載されたリストには、単語の識別番号、各言語の表現、特徴ベクトルなどが含まれます。特徴ベクトルとは、意味に関する情報を計算に利用できるよう数値の組で表したものです。
語彙の拡張は、モデルが扱える表現をあらかじめ増やす作業です。日常語に加え、ブランド名、地理・文化に関する表現、電子商取引の用語などが挙げられています。商品分野で必要な表現を学習の材料に含める出発点となります。
架空のキャンプ用品の例では、「折り畳み式チェア」や「アルミフレーム」のような組み合わせが考えられます。名称をリストに追加することと、モデルが利用できる表現を整えることは別の課題です。識別番号の数を増やすだけでは、仕組みの説明として不十分です。
記載された翻訳モデルは、入力情報を表現へ変換するエンコーダーと、訳文を生成するデコーダーを備えています。語彙と特徴ベクトルは、これらの計算に用いられる材料です。準備段階で材料をどう構成するかが、その後の学習につながります。
3. LLMの専門語彙で表現を補強する
LLMは、大量のテキストから学習した大規模言語モデルです。この出願では、特定分野の専門語彙をLLMに求め、その出力を使って翻訳モデルの語彙の特徴ベクトルを調整する方法が説明されています。
架空の販売者なら、キャンプ用品の専門用語と対応する表現を問い合わせる場面が考えられます。LLMが提供するのは、その分野の語彙材料です。それを使い、翻訳モデルの語彙表現を専門用語に適した形に整えます。
数値ベクトルは、意味を表す座標のように捉えると理解しやすくなります。他の単語との関係を計算で扱うための表現です。ここでは、LLMから得た専門語彙をその表現の補強に利用する点が重要です。
入力と出力を並べると、処理の分担が分かります。分野を指定した質問をLLMに入力して専門語彙を得た後、次の処理で翻訳モデルの語彙表現を調整します。顧客の新しい商品説明を翻訳するのは、その準備済みモデルを使う後の段階です。
4. 学習に使う対訳文を選別する
翻訳の学習には、原文と対応する訳文を組にしたデータを使用できます。このような文対を集めたものが対訳コーパスです。公開データを大量に集めても、言語の指定が誤った例、意味が対応しない例、重複した例が含まれることがあります。
この出願は、品質基準を満たすデータを残すクリーニングを説明しています。文対の意味的な近さ、原言語・目的言語の一致、文の長さの比率、データの重複などが選別の基準となり得ます。
キャンプチェアの説明に、まったく別の商品案内を訳文として組み合わせても、適切な学習例にはなりません。一方だけが異常に長い文対や、同じ文対が何度も含まれる場合にも、データの構成を確認する必要があります。選別の対象はモデルを学習させるための文対です。
各手法はデータの異なる性質を見ています。意味の比較、言語の識別、重複の検出を区別すると、どのデータを残すか説明しやすくなります。すべての基準を常に同じ順序と同じしきい値で適用する、一つの固定手順と理解する必要はありません。
5. 選別したデータで学習し、出力の繰り返しを抑える
語彙表現を補強し、データを選別した後は、そのデータで翻訳モデルを学習させます。学習では、入力と翻訳の関係を扱えるよう内部計算のパラメーターを調整します。出願には、複数の学習方法を利用できる構成が示されています。
もう一つの論点は、訳文で同じ表現が過度に繰り返されることです。商品説明は短いキーワードを並べる場合が多く、出力でも似た単語が続くことがあります。出願には、この繰り返しを扱う追加処理も記載されています。
学習データの重複除去と、生成される訳文の繰り返し抑制は対象が異なります。前者は同じ文対がデータ内に複数存在するかを見ます。後者は、翻訳の生成中にモデルが似た表現を繰り返す動作を調整します。
記載された方法には、繰り返されたトークンへのペナルティー、出力候補の探索、学習・予測段階での繰り返し傾向の調整などがあります。トークンは、モデルが文章を処理する小さな単位です。これらは生成方法を制御するもので、原文に必要な同じ単語まで機械的に削除する規則ではありません。
開発文書では、語彙の準備、学習データの選別、モデルの学習、出力生成の制御を分けて記載できます。結果が変化したときに、どの段階の変更がどの動作に影響したのかを説明する助けになります。
6. 架空のキャンプ用品を英語で紹介する例
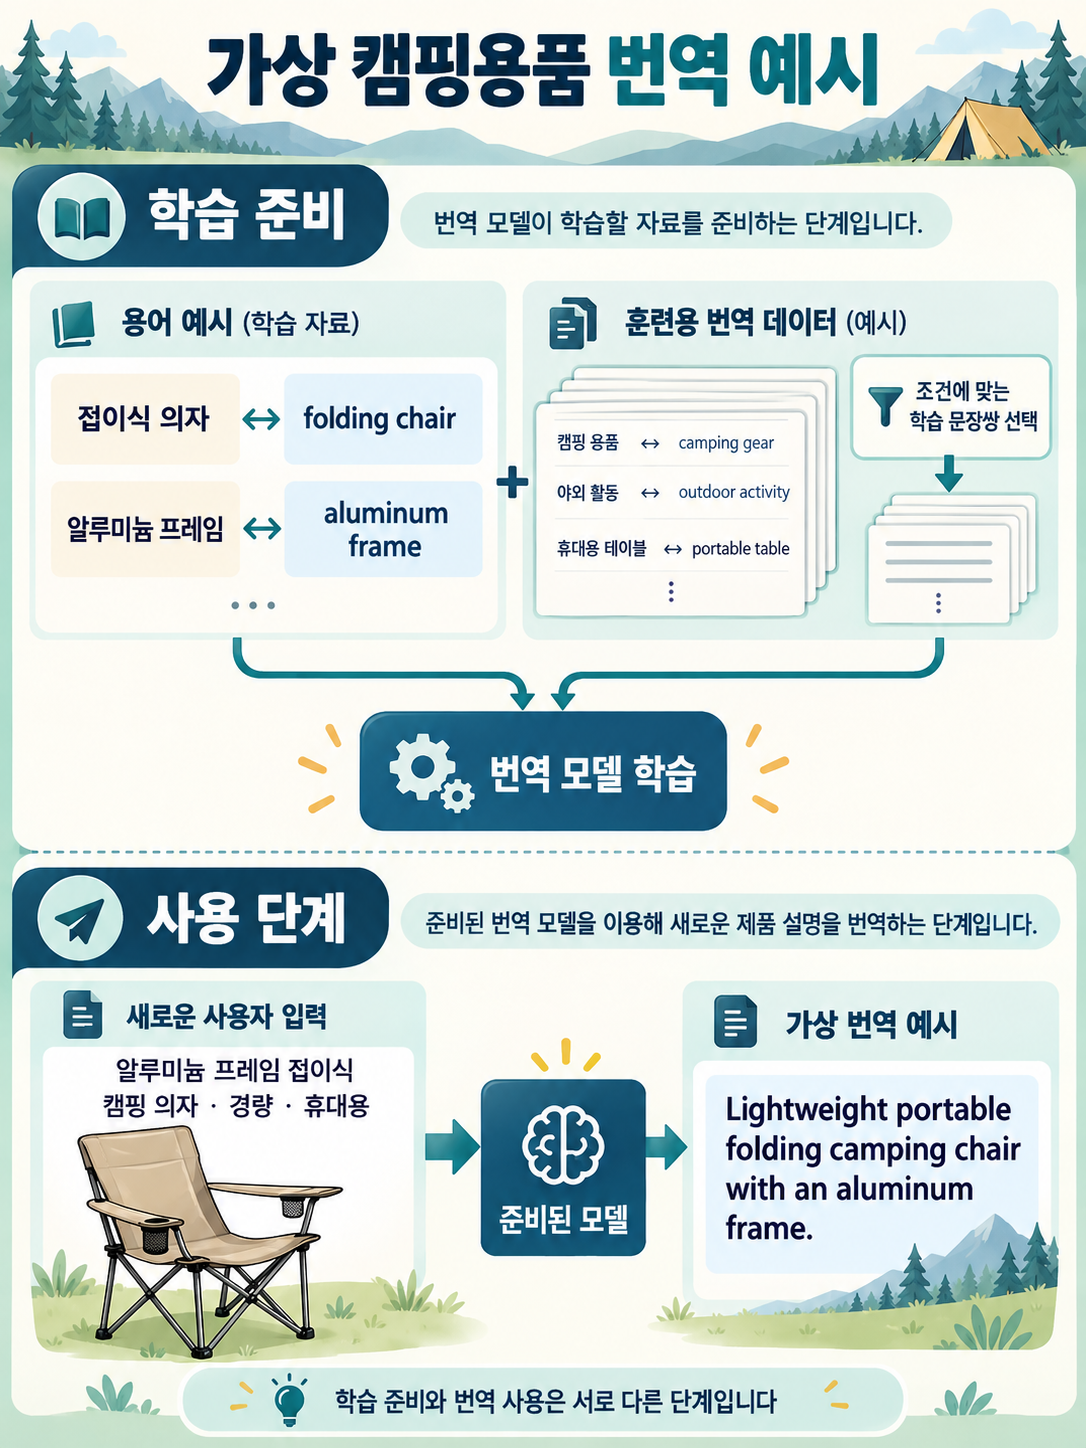
キャンプ用品を英語で紹介する架空の販売チームを考えます。学習の準備では、日常語とキャンプ用品の専門表現を語彙に含め、LLMから得た分野語彙で単語表現を補強します。「折り畳み式チェア」と「アルミフレーム」は、理解のために選んだ例です。
対訳データからは、意味、言語、重複などの必要な基準に合う文対を選びます。そのデータでモデルを学習させると、新しい商品説明を入力する利用段階へ進めます。
新しい韓国語原文には、アルミフレーム、折り畳み式キャンプチェア、軽量、持ち運び可能という特徴が列挙されています。説明用の英訳例は「Lightweight portable folding camping chair with an aluminum frame.」です。素材、折り畳み構造、キャンプ用途、軽さ、携帯性を一つの紹介文にまとめています。
この英文だけを正解として示すことが目的ではありません。分野語彙の準備、学習文対の選別、学習済みモデルによる新しい原文の翻訳を、それぞれ追うための例です。準備と利用を区別して初めて、どの入力がどの処理に使われるかが明確になります。
7. Qwen-MTと翻訳サービスの設計
Alibaba CloudのQwen-MTは、原文を別の言語へ翻訳するモデルです。公式文書は、原言語と目的言語の指定に加え、用語の対応表、既存の対訳例、分野に関する情報を渡して翻訳を調整する機能を説明しています。
用語の対応表は、特定の原語をどの訳語で表すか指定する資料です。翻訳メモリは原文と参考訳文の組であり、ドメインプロンプトは分野や文体を説明する入力です。会話全体を継続して記憶させる仕組みではなく、一回の翻訳依頼に必要な資料を渡す機能として捉えられます。
利用チームは、商品名、ブランド名、繰り返し使う案内文をどの形式で渡すか設計できます。一方、自社でモデルを開発する場合は、語彙リスト、単語表現、学習データの構成、繰り返し出力の制御といった準備段階を具体的に整理できます。
このアリババの出願で注目したい技術上の違いは、「翻訳が良くなった」という結果だけではありません。専門語彙をどこから取り込み、どのデータを残して学習し、どの段階で繰り返しを調整するかにあります。入力、処理、次の段階へ渡す結果を結び付けて説明することが有用です。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
IPLEXのAI技術・特許分析、関連著書、技術相談をご覧ください。
US20250173522A1は公開特許出願です。本稿は特許の成立、権利の有効性、侵害の有無を判断するものではありません。Qwen-MTの製品資料は別に取り上げており、その資料だけで当該サービスが出願記載の方法を実装しているとは確認できません。
ネイバーの画像翻訳特許を読む―動くカメラ映像に訳文を重ねる仕組み
モデル回答と検索知識が食い違うとき――BaiduのRAG処理を読む