
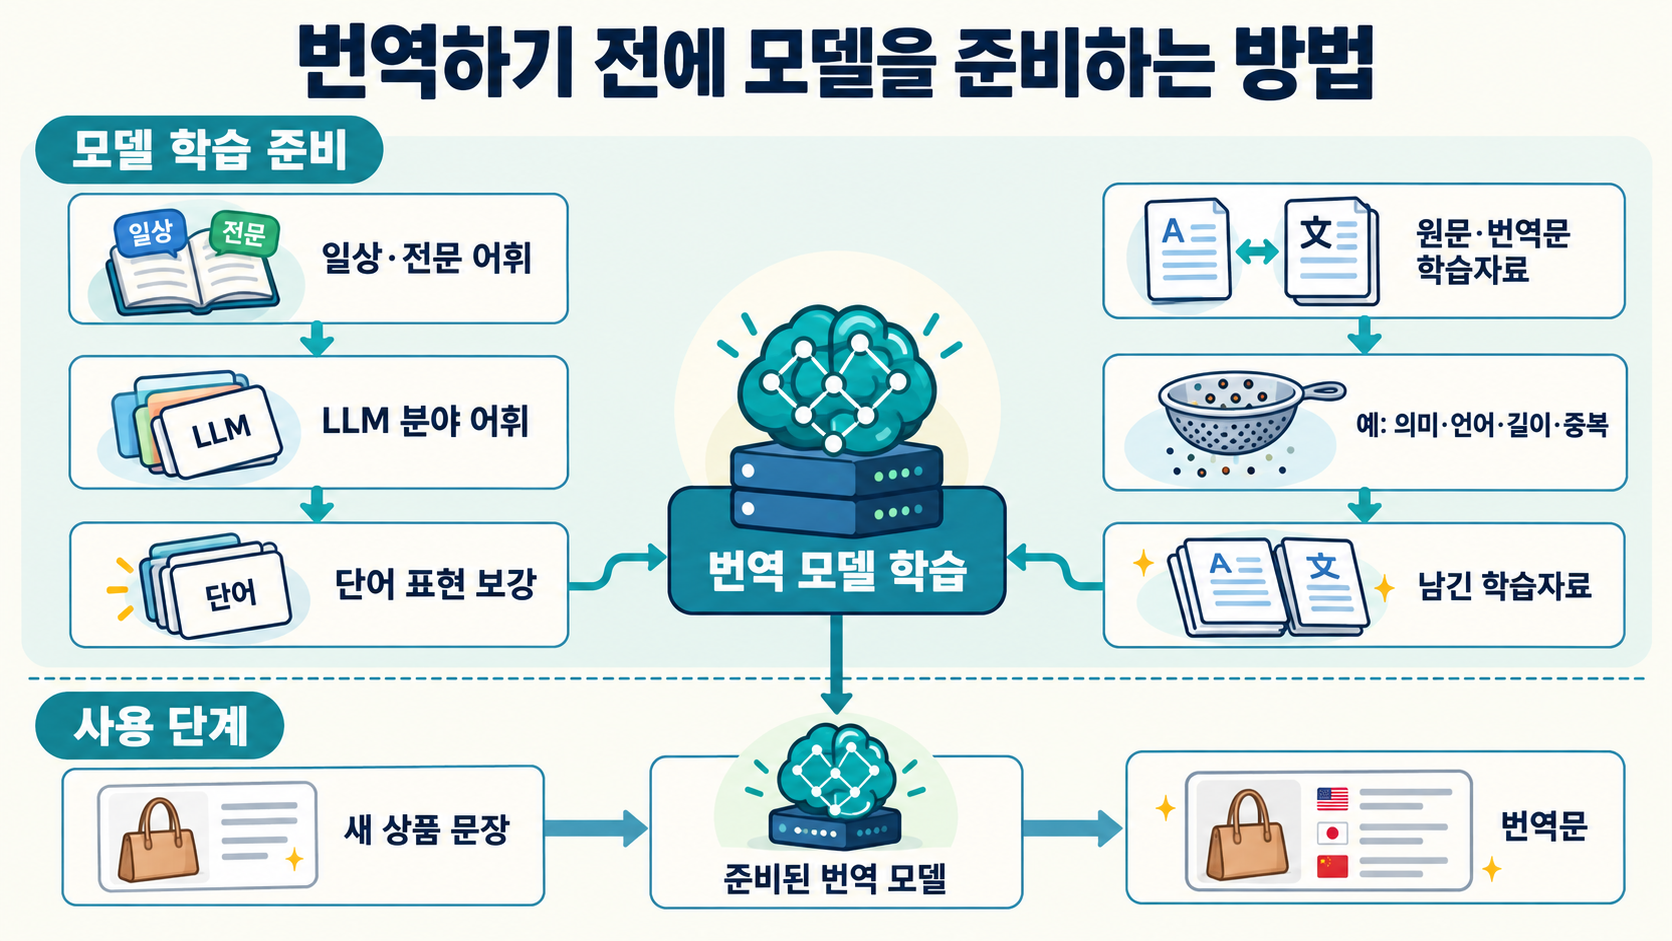
При переводе описания товара необходимо учитывать не только повседневную лексику, но и специальные термины и краткие перечни характеристик. В опубликованной патентной заявке Alibaba описана подготовка модели перевода за счёт улучшения словарных представлений и отбора обучающих данных. Условный пример продавца туристического снаряжения помогает разграничить обучение модели и последующий перевод нового описания.
1. Почему описания товаров трудно переводить
Представим команду, которая готовит товар к продаже за рубежом. В корейском оригинале перечислены характеристики: «складной стул для кемпинга с алюминиевым каркасом · лёгкий · переносной». Это скорее краткий перечень материала, конструкции и назначения, чем полное предложение. Последовательная замена отдельных слов не обязательно даст естественное описание. Как подготовить модель к работе с непривычной товарной терминологией?
Названия товаров могут сочетать бренды, региональные выражения и отраслевые термины. Даже знакомые слова в определённой товарной категории образуют особые сочетания. В переводе важно передать связи: из какого материала сделан предмет и для чего он предназначен.
Заявка посвящена подготовке словаря и данных до того, как модель начинает создавать переводы. Предлагается расширить словарь, дополнить информацию, представляющую слова, отобрать данные по критериям качества и обучить модель на сохранённых материалах.
Подготовку следует отделять от обработки нового запроса. Специальная лексика используется при подготовке модели, а затем в уже обученную модель поступает новый исходный текст, из которого формируется результат на целевом языке.
2. Словарь и числовые представления
Под словарём здесь понимается набор слов и выражений, с которыми работает модель. В заявке он включает идентификаторы слов, выражения на разных языках и векторы признаков. Такой вектор представляет семантическую информацию набором чисел, пригодным для вычислений.
Расширить словарь — значит заранее добавить выражения, которые предстоит обрабатывать. Помимо общеупотребительных слов, в заявке рассматриваются названия брендов, географическая и культурно обусловленная лексика, термины электронной торговли. Это исходный шаг для включения нужных товарной области выражений в учебный материал.
В условном примере туристического снаряжения важны сочетания «складной стул» и «алюминиевый каркас». Добавление названия в список и подготовка представления, которым сможет пользоваться модель, — разные задачи. Поэтому одного увеличения числа словарных идентификаторов недостаточно для объяснения процесса.
Описанная модель перевода содержит кодировщик, который преобразует входную информацию в представления, и декодировщик, формирующий перевод. Словарь и векторы признаков служат материалом для этих вычислений. Их организация на подготовительном этапе связана с последующим обучением.
3. Как специальная лексика от LLM дополняет представления
Большая языковая модель, или LLM, обучается на значительных объёмах текста. В заявке предлагается запросить у неё специальную лексику определённой предметной области и использовать ответ для корректировки векторов признаков словаря модели перевода.
В случае условного продавца запрос может касаться терминов туристического снаряжения и соответствующих им выражений. LLM предоставляет лексический материал предметной области. На его основе затем корректируются словарные представления переводящей модели с учётом специальной терминологии.
Числовой вектор удобно представить как координаты, отражающие смысл. Он позволяет вычислительно учитывать отношения слова с другими словами. Предложенная связь состоит в использовании специальной лексики, полученной от LLM, для уточнения этих представлений.
Если перечислить входы и выходы этапов, распределение ролей становится понятным. В LLM поступает запрос с указанием предметной области, на выходе получается специальная лексика, а следующий этап корректирует представления словаря модели перевода. Перевод нового описания заказчика выполняется позже, при использовании подготовленной модели.
4. Отбор параллельных предложений для обучения
Для обучения переводу можно использовать пары из исходного предложения и соответствующего перевода. Совокупность таких пар образует параллельный корпус. Даже большой открытый набор данных может содержать ошибочно указанные языки, несовпадающие по смыслу тексты и дубликаты.
Заявка описывает очистку данных, при которой сохраняются материалы, соответствующие критериям качества. Можно учитывать смысловую близость двух предложений, соответствие заданным исходному и целевому языкам, допустимое соотношение длин и наличие повторяющихся данных.
Если описанию стула для кемпинга сопоставлен перевод о совершенно другом товаре, хорошего обучающего примера не получится. Внимания требуют и пары с аномально длинной одной стороной или многократным повторением. Здесь отбираются именно предложения, на которых будет учиться модель.
Разные методы оценивают разные свойства материала. Разграничение семантического сравнения, определения языка и удаления дубликатов помогает объяснить, какие примеры сохраняются. Описание не следует понимать как единую жёсткую процедуру, в которой все критерии всегда применяются в одинаковом порядке и с одинаковыми порогами.
5. Обучение на отобранных данных и управление повторениями
После уточнения словарных представлений и отбора данных на них обучают модель перевода. В ходе обучения изменяются внутренние вычислительные параметры, чтобы модель могла усвоить связи между входными текстами и переводами. Заявка предусматривает использование различных методов обучения.
Отдельная проблема — чрезмерное повторение одних и тех же выражений в переводе. Описания товаров часто состоят из коротких списков ключевых слов, и похожие слова могут повторяться в результате. В заявке предусмотрена дополнительная обработка такого поведения.
Удаление дубликатов из обучающего корпуса и подавление повторений в выходном тексте относятся к разным объектам. В первом случае проверяется, не присутствует ли одна пара предложений в данных несколько раз. Во втором регулируется склонность модели вновь выдавать похожие выражения при генерации перевода.
Среди описанных подходов — штраф за повторяющиеся токены, поиск среди кандидатов на продолжение и регулирование повторений при обучении или прогнозировании. Токен — небольшая единица текста, которую обрабатывает модель. Эти методы управляют генерацией, а не требуют безусловно удалять повторяющиеся слова, действительно необходимые для передачи оригинала.
В документации разработки можно раздельно описать подготовку словаря, отбор обучающих данных, обучение модели и управление генерацией. Тогда легче объяснить, какое изменение на каком этапе повлияло на конкретное поведение модели.
6. Условный пример описания туристического товара
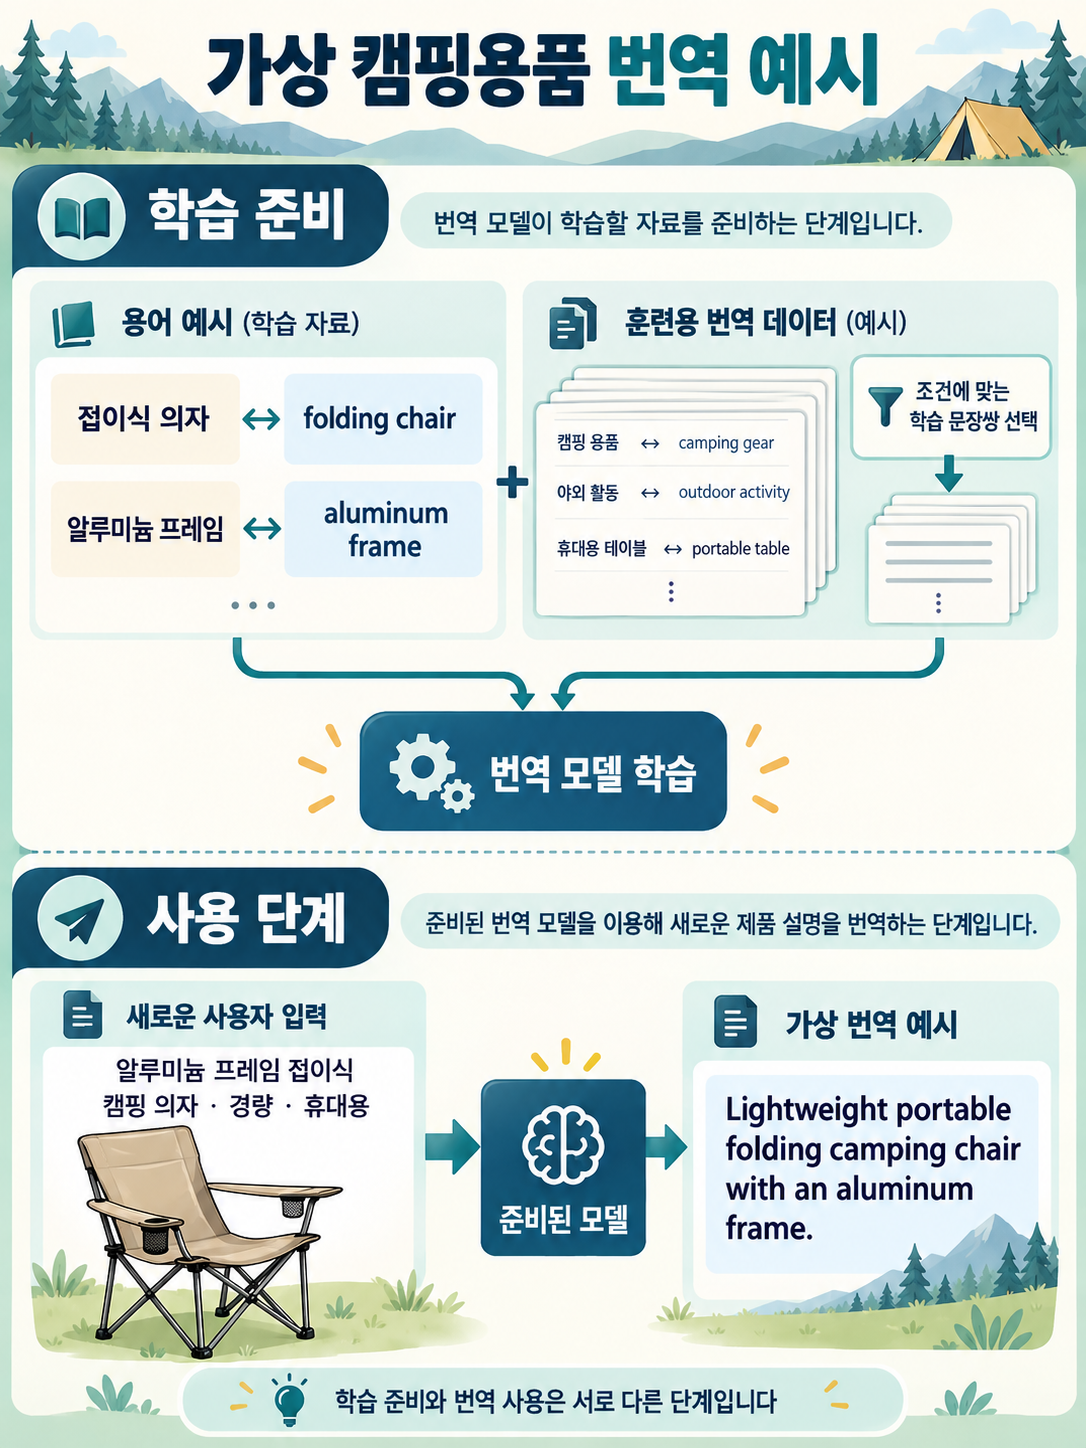
Пусть команда продавца хочет представить туристическое снаряжение на английском языке. При подготовке она включает в словарь отраслевые выражения вместе с повседневными словами и использует полученную от LLM лексику для уточнения представлений. «Складной стул» и «алюминиевый каркас» выбраны здесь только как наглядные примеры.
Из пар оригиналов и переводов команда отбирает обучающий материал по применимым критериям смысла, языка и дублирования. После обучения на сохранённых данных можно перейти к использованию модели и подать ей новое описание товара.
В новом корейском тексте перечислены алюминиевый каркас, складной стул для кемпинга, небольшой вес и возможность переноски. Иллюстративный английский вариант: «Lightweight portable folding camping chair with an aluminum frame.» В нём материал, складная конструкция, назначение для кемпинга, лёгкость и переносимость объединены в одно описание.
Этот вариант не объявляется единственно правильным переводом. Пример нужен, чтобы проследить три отдельных действия: подготовить лексику предметной области, отобрать обучающие пары и перевести новый оригинал обученной моделью. Разделение подготовки и использования показывает, какие входные данные нужны каждому действию.
7. Qwen-MT и проектирование сервиса перевода
Qwen-MT от Alibaba Cloud — модель для перевода исходного текста на другой язык. В официальной документации описаны выбор исходного и целевого языков, а также передача терминологических соответствий, готовых примеров перевода и сведений о предметной области для настройки результата.
Терминологическое соответствие задаёт предпочтительный перевод определённого выражения. Память переводов предоставляет пары исходных предложений и образцов перевода. Предметная инструкция описывает область и желаемый стиль. Это материалы для отдельного запроса на перевод, а не способ постоянно сохранять в памяти весь предшествующий диалог.
Команда, использующая эти функции, может определить формат передачи названий товаров, брендов и повторяющихся уведомлений. При разработке собственной модели отдельно документируются подготовительные решения: словарь, представления слов, состав обучающего корпуса и контроль повторений на выходе.
Технические различия в этой заявке Alibaba не сводятся к утверждению «перевод стал лучше». Важно, откуда поступает специальная лексика, какие данные сохраняются для обучения и на каком этапе регулируются повторения. Связное описание входов, обработки и результатов, передаваемых дальше, делает устройство решения понятным.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Связанная практика: патенты в области ИИ
Ознакомьтесь с анализом технологий и патентов в области ИИ, публикациями и техническими консультациями IPLEX.
US20250173522A1 — опубликованная патентная заявка. В статье не устанавливаются факт выдачи патента, действительность прав или наличие нарушения. Документация Qwen-MT рассматривается отдельно и не доказывает, что сервис реализует описанный в заявке способ.
Оригинальная техническая статья в Tistory
Опубликованная заявка США US20250173522A1
Alibaba Cloud: руководство по Qwen-MT
Alibaba Cloud: документация API Qwen-MT
Патент Naver на перевод изображений: как совместить перевод с движущимся кадром
Как Baidu обрабатывает противоречия между ответом модели и найденными знаниями