
La tecnología de analizar imágenes médicas y diagnosticar enfermedades a través de la inteligencia artificial ha ido creciendo rápidamente recientemente. Muchas start-ups como VUNO, Lunit y JLK Inspection está estudiando la tecnología, y se está realizando una investigación activa para aumentar la exactitud del análisis. En este post, quiero explicar una patente Roonet relacionada con la tecnología que aumenta la precisión en el análisis de imagen médica basado en IA.
Si hace clic en la imagen, puede ver la patente de registro.
La patente.
Utilizar inteligencia artificial para encontrar células divisorias similares en imágenes tomadas por células es un aspecto clave de la invención presente. El modelo de IA utilizado en la presente invención es la Red Neural Convolutional (CNN). Los modelos de red neuronales conversos utilizados en la presente invención pueden clasificar células pseudo-divisionales y células normales en la imagen tomada. Por otra parte, para realizar predicciones más precisas, la presente invención se somete a dos procesos de aprendizaje (adiestramiento paso 1 y entrenamiento paso 2.
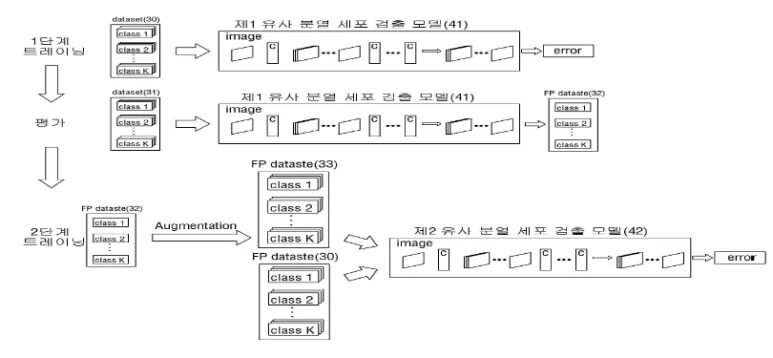
Nivel 1 Capacitación
Un entrenamiento de primera etapa para el modelo se realiza utilizando un conjunto de datos de primera formación dados por un patólogo como resultado de clasificación que apunta a una célula de mitosis o célula normal. Hasta ahora tan común.
Prepárense para el entrenamiento de la etapa 2.
Después de completar la formación de primer nivel, prepare los datos establecidos para la capacitación de segundo nivel. Específicamente, cuando se completa el entrenamiento de primera etapa, se evalúa el modelo para recopilar un falso conjunto de datos positivos (una célula pseudo-división, un conjunto de datos clasificado como una célula normal). Además, el aumento de datos (rotación de imágenes, adición de ruido, etc.) para conjuntos de datos FP se realiza para aumentar la cantidad de conjuntos de datos FP. Preparar el primer conjunto de datos de entrenamiento y el conjunto de datos FP mejorado utilizado para realizar el entrenamiento de primera fase. Aquí, los conjuntos de datos FP son conjuntos de datos que el modelo de IA clasifica erróneamente. En la industria de la salud, parece estar recolectando conjuntos de datos FP porque es el peor caso para que exista la enfermedad, y reducir errores FP (falsos errores positivos) es clave.
Capacitación de nivel 2
Inicializar los pesos en el modelo CNN utilizado en el paso 1. Al utilizar el modelo CNN utilizado en el entrenamiento de primera etapa sin inicialización, los pesos de filtro están bien ajustados. En este caso, la inicialización de peso es necesaria porque la precisión no se mejora mucho. En caso de inicializar los pesos del modelo CNN, el conjunto de datos preparado (primer conjunto de datos de entrenamiento + conjunto de datos FP mejorado) se utiliza para relear el modelo CNN (entrenamiento de segundo nivel). Si la imagen se clasifica con un modelo CNN completado, el error FP se reduce significativamente.
Opiniones sobre patentes
En el proceso de diseño de un modelo de IA, es importante reducir errores falsos positivos (FP) para aumentar la precisión del modelo. Sin embargo, en mi experiencia de tratar con muchas patentes de IA, tengo un poco de pregunta sobre la patente de Lunit. Si usted aprende el modelo CNN según la patente Lunett, es probable que la precisión del modelo sea pobre. De hecho, si aumenta el conjunto de datos FP para relear el modelo con el conjunto de datos existente, el conjunto de datos de entrenamiento puede ser parcial al conjunto de datos FP. Sin embargo, sólo es posible considerar este método para reducir los errores de FP.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.