
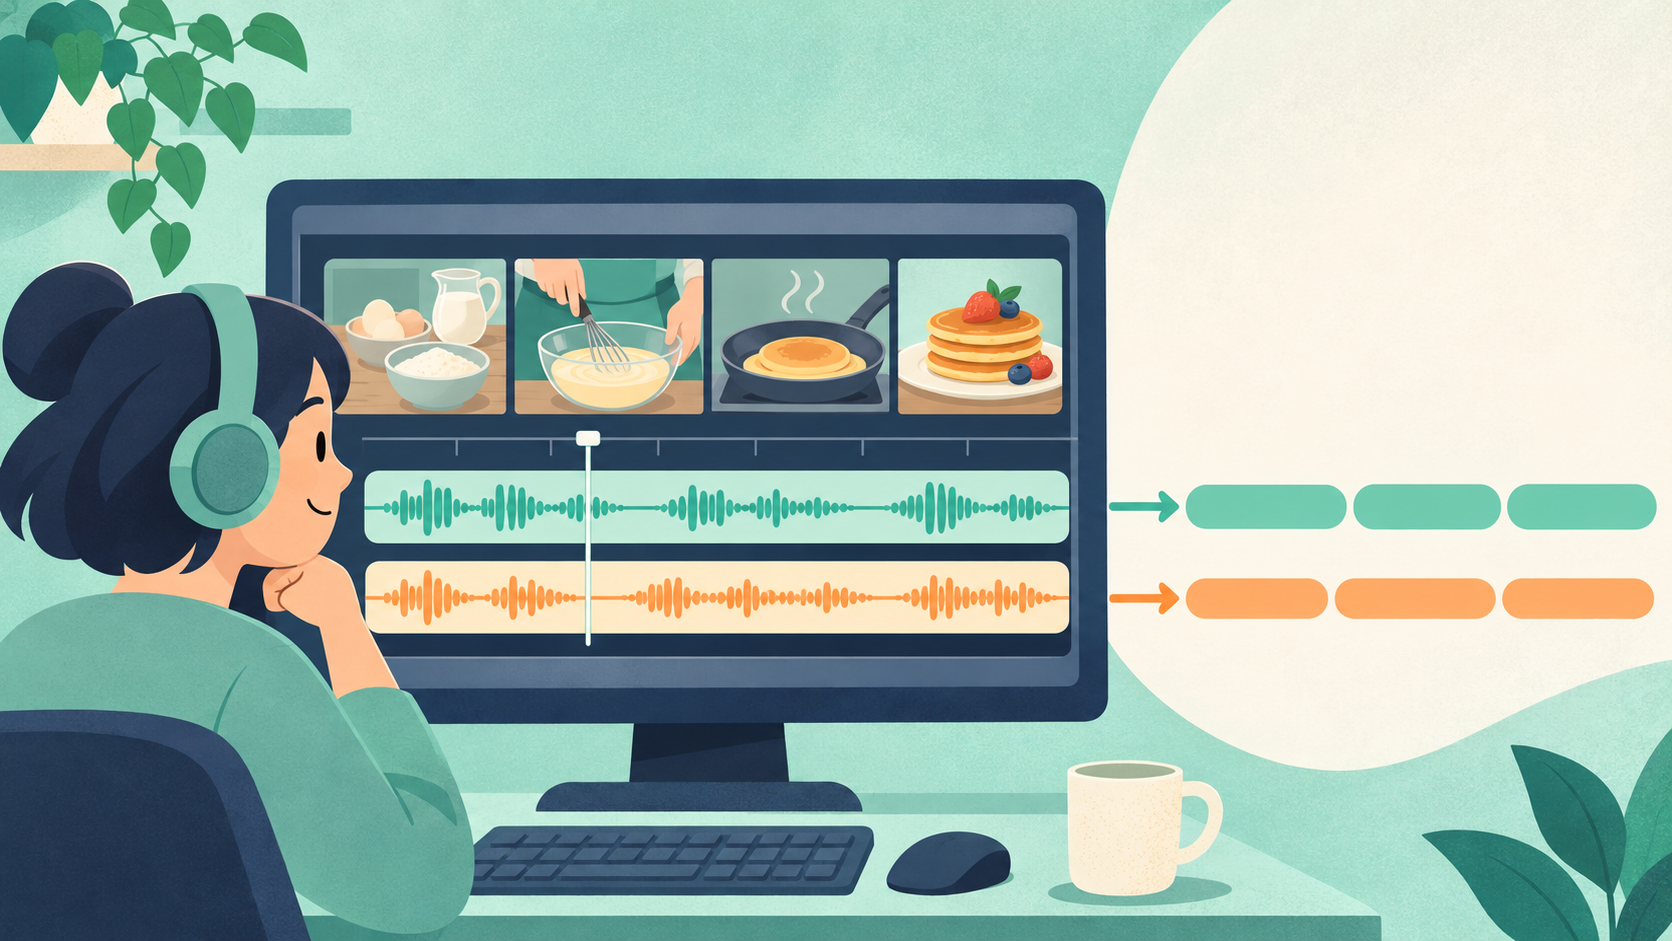
教学视频中,讲解与操作提示可能同时出现。系统既要决定识别哪段语音,也要安排字幕的显示时间。字节跳动的美国专利US11837234B2介绍了逐轨识别、按开始时间排序,以及在字幕重叠时提前结束前一条字幕的处理方式。下面用虚构的教学视频说明这一流程。
1. 讲解与操作提示同时出现时
设想一段模型组装教学视频:主持人介绍部件,另一段单独录制的语音补充操作指令。若只对混合后的声音进行识别,同一时段的两段话可能产生漏字或混淆。
音轨是视频时间轴上的独立声音轨道。旁白、操作提示和背景音乐分轨保存时,编辑人员可以分别调整位置与音量,也可以在混音之前选择需要转写的轨道。
北京字节跳动网络技术有限公司的US11837234B2于2023年12月5日在美国获得授权。本文关注其技术公开:分别识别选定音轨,再把文字片段组合成同一视频的字幕。
2. 对选定音轨分别进行语音识别
自动语音识别把录音中的话语转换为文字。图1描述系统收到字幕生成请求后,查找选定各轨的音频数据并分别识别;图2展示选择一个或多个音轨后生成字幕的界面。
例如,可以选择旁白和操作提示,排除独立的背景音乐轨。每段语音都从原有的独立音轨中识别,这不同于从已经混合的录音中分离说话人。
输出是包含句子或部分话语的文字片段,每个片段关联显示开始与结束时间。即便识别过程分开进行,字幕最终仍须对齐到视频的共同时间轴。
3. 排序后调整前一条字幕的结束时间
把一个音轨的全部字幕接在另一个音轨之前,会破坏实际的时间顺序。图3先按照显示开始时间,对所选音轨产生的文字片段进行综合排序。
随后比较前一片段的结束时间与后一片段的开始时间。在重叠的示例中,把前一片段的结束改为后一片段的开始。两者本来有间隔,或前一条恰好结束时后一条开始,就无需这样缩短。
调整的是字幕显示区间,录音本身不移动。对于同时开始的片段,说明书另有保留结束最晚片段的实施方式。因此,若需呈现全部话语,还应检查最终保留下来的内容。
4. 虚构组装视频中的一秒重叠
假设字幕A“先检查底板的槽”显示于第3至7秒,字幕B“请把侧板立起来”显示于第6至9秒。它们来自不同音轨,在第6至7秒之间重叠一秒。
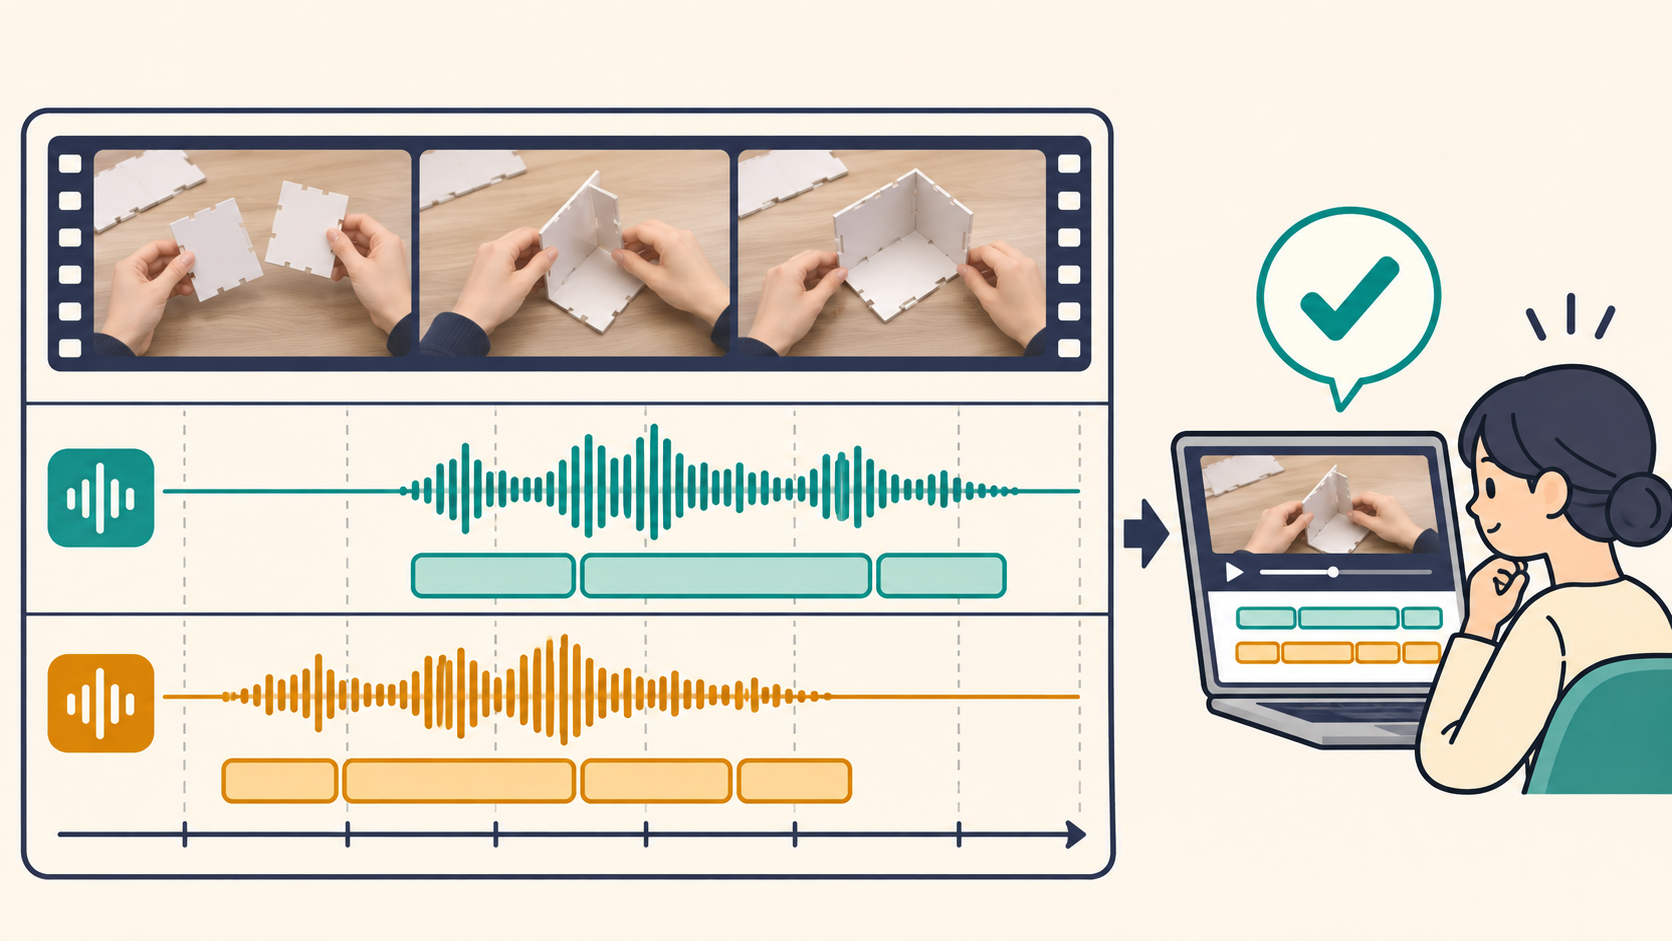
采用图3的方式,将A的结束从第7秒提前到第6秒。A于是显示于第3至6秒,B显示于第6至9秒。字幕文字和录音都不变,只改变显示区间。
消除重叠并不等于保证可读性。如果A很长,三秒可能不足以读完。编辑人员仍需考虑拆分文字或重新安排时间,自动生成的区间只是编辑起点。
5. CapCut公开帮助说明的操作流程
字节跳动在官方产品列表中把CapCut列为视频编辑工具。CapCut帮助页说明,自动字幕通过语音识别生成文字;桌面端可选择音频来源与语言,再在时间轴上修改文字和显示时间。
教学团队可以播放画面和声音,同时检查字幕初稿。把某个词识别错需要修改文字,提示说完后字幕仍停留则需要调整时刻。这是两类不同的编辑问题。
多段视频沿用相同字幕样式,也不意味着显示时长完全相同。语速加快或增加操作指令时,应结合镜头切换、实际发话和字幕开始时刻确定修改位置。
6. 开发团队可以保留哪些比较记录
分别检查输入、识别和显示结果。记录选择了哪些音轨、何时有重叠语音,再检查必要词语是否遗漏,以及字幕的起止时刻和阅读时间是否合理。
在同一视频上比较混音识别与分轨识别,可以看到重叠处漏词的差别。时间调整测试可覆盖短字幕、长字幕、同时开始和无重叠情形,并记录编辑修改量。
准备专利讨论材料时,可按流程说明音轨选择标准、相邻字幕所比较的时间值,以及缩短后阅读时间不足的处理。记录同一时间轴上不同条件的结果,有助于解释技术贡献。
图中保留原始标注与形态,相关内容在正文中说明。
教学场景为虚构示例。公开产品资料不能单独证明某产品实施了特定专利权利要求。
如需整理语音识别和字幕时间控制技术,可查看IPLEX的AI项目与咨询准备资料。