
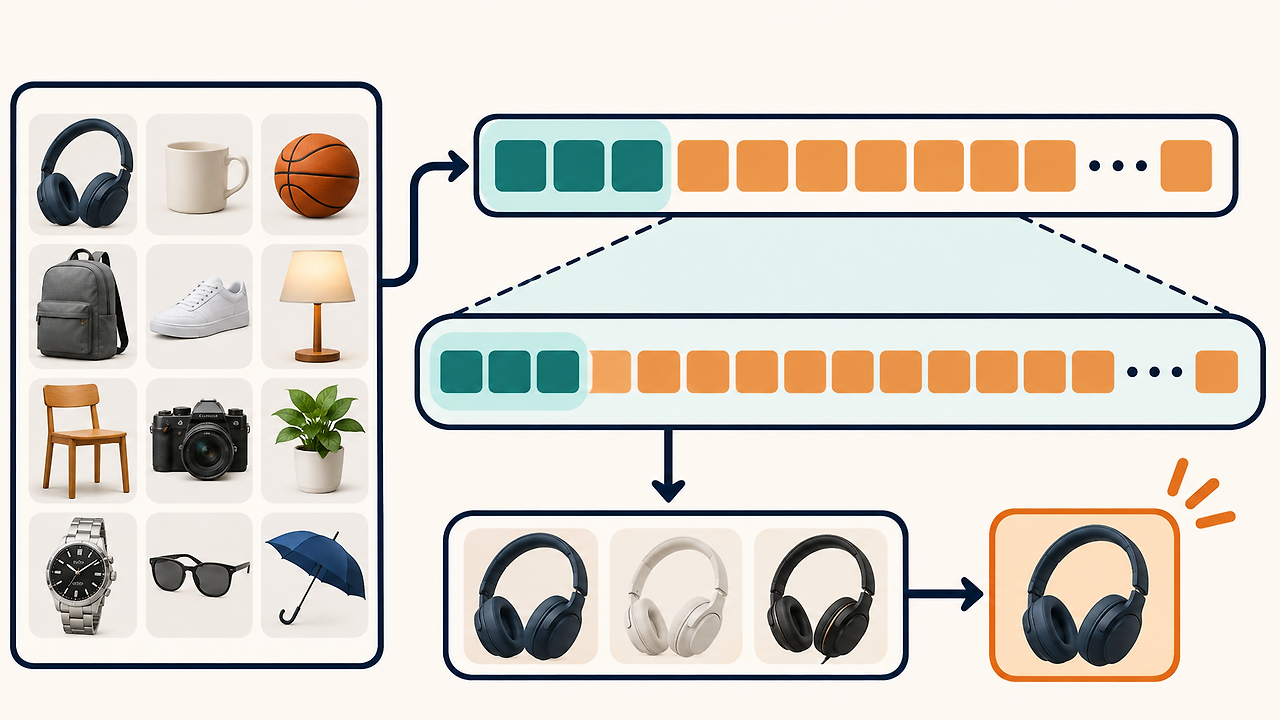
从一开始就对所有商品照片进行细致比较,会增加计算开销。Matryoshka表示学习在训练时同时评估多个前缀长度,使图像嵌入的较短前部也能用于检索。下面结合虚构商品目录和ImageNet-1K实验,说明先筛选候选、再用完整向量重新排序的过程。
1. 搜索一张照片需要比较多少数字
假设收到一张蓝色带把杯子的照片,文件名只有拍摄日期。要从数千张商品照片中找到相似图片,必须比较图像内容,但初步筛选是否需要详细比较每张照片的杯把、杯沿和花纹?
图像模型把照片转换成一组数字,称为嵌入向量;数字的个数就是维度。比较向量间距离可以找到相近图片。面对大量商品反复计算时,所用维数也会影响检索成本。
Kusupati等人在NeurIPS 2022提出Matryoshka Representation Learning,重点是同一嵌入可使用不同长度的前缀:用短表示浏览较大范围,再用长表示细分候选。
2. 在同一输出中共同训练多种长度
图像实验中的模型输出2,048个数,并指定前8、16、32维等嵌套长度。16维向量和32维向量不是两次独立生成的结果,而是同一输出的前16项与前32项。
训练时,每个指定长度都预测图像类别并计算与标签的损失,再将这些损失组合起来更新共享模型。因此,短前缀的预测也直接影响训练,而不是训练结束后才随意截短向量。
论文在分类任务中使用不同长度的分类器;检索则比较训练所得表示之间的距离。进行16维检索时,查询图像和目录图像都取前16项,保证所比较的位置对应。
3. 先缩小商品范围,再对候选重排
设想虚构目录中混有水瓶、马克杯、纸杯和无把杯。上传的蓝杯照片被编码成向量,目录照片已由同一模型预先编码。第一阶段比较短前缀,仅保留距离较近的候选。
第二阶段读取这些候选的较长向量部分,重新计算距离。两只蓝杯可能因为更细的差别而改变排名。这只是流程示例,并不假设某一个维度专门表示颜色或某个部件。
第一阶段负责减少比较对象,第二阶段负责细化次序。若目标杯子在初筛时已经被排除,重排就无法把它找回来。因此,候选数要结合检索质量与计算量共同选择。
4. ImageNet-1K实验报告了什么
研究使用ResNet50学习的表示,在ImageNet-1K中检索与查询图像同类别的照片。一项设置先用16维选出200个候选,再以完整2,048维重排。官方补充材料表8和表11报告了基于距离的精确搜索结果。
对同一MRL表示,直接使用2,048维检索的mAP@10为65.20%,先16维筛选再以完整向量重排为65.27%。mAP@10汇总多次查询中相关图片在前十名的排序表现。两者接近说明在该实验条件下,前十名的质量基本相当。
对应的每次查询检索计算量分别为2,624 MFLOPs和21 MFLOPs,即以百万次浮点运算计数。这不直接等于用户看到的端到端响应时间,后者还包括图像编码和存储读取等环节。
5. 如何选择向量长度与候选数量
前缀越短,每张照片比较的数字越少,但在外观相近或差异细微的数据中,也可能丢掉必要候选。论文对更困难的ImageNet-4K给出了首阶段64维的配置。16维、200候选只是上述实验设置,并非通用默认值。
相关图片的定义也取决于用途。类别检索可能接受同款不同色杯子;识别具体SKU则必须区分把手或花纹相似的不同商品。先确定相关性标准,再比较维数和候选数,更容易找出质量下降的位置。
第二阶段必须能读取候选的长向量。短向量索引做多小、完整向量保存在哪里,是不同的设计问题。分别记录计算量、向量读取延迟和存储空间,可以看清各项选择的成本。
6. 开发时值得保留的对比结果
在同一目录上比较完整向量直接检索与前缀初筛。先记录正确候选是否进入名单,再记录重排后的名次,这样可区分初筛遗漏与后续排序问题。
还可以测试光照变化、局部裁剪和不同拍摄角度。清晰标准图像的结果未必适用于用户实际照片。除了平均响应时间,也应记录较慢请求的条件,再判断是否调整候选数或向量读取方式。
为专利讨论整理技术资料时,应串联训练阶段评估的长度、候选选择规则,以及第二阶段复用的信息。同一目录上控制条件所得的结果,有助于区分表示学习与检索流程设计各自的效果。
图中保留原始标注与形态,相关内容在正文中说明。
商品目录为虚构示例。准确率与计算量仅对应论文实验条件,不是对实际服务性能的保证。
读懂Lost in the Middle:答案文档放在什么位置也会影响结果
如需梳理嵌入模型与检索流程,可查看IPLEX的AI项目和咨询准备资料。