
1.译文生成时,画面可能已经移动
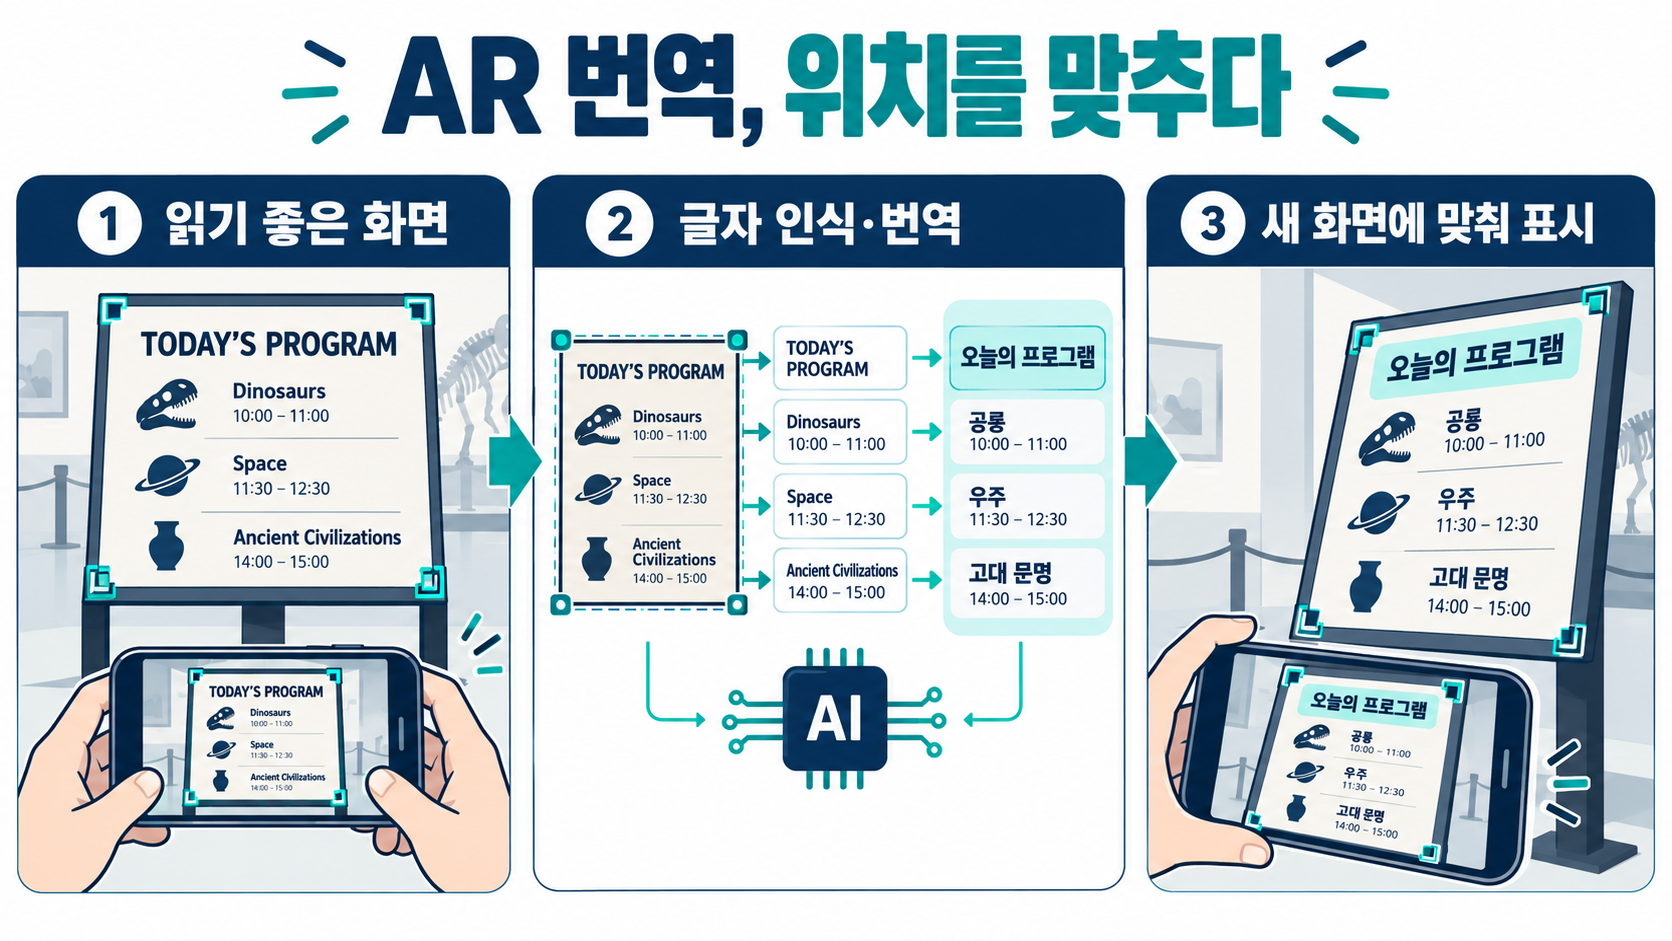
设想用户在展会上用手机拍摄英文指示牌,准备查看韩文译文。翻译尚未完成,手部轻微移动就可能改变指示牌的位置和倾角。即使译文准确,仍按原坐标显示也会影响阅读。NAVER的美国专利US12197883B2围绕这种时间差和位置对齐问题,提出增强现实图像翻译的处理流程。Papago的官方介绍有助于理解使用场景,但产品介绍与专利公开内容本身,并不足以证明现行产品的每项功能均采用了同一实施方式。
2.从缓冲帧中选择适合识别的输入
视频由连续的图像帧组成。该方案先在缓冲区暂存若干近期帧,再选取符合预设条件的一帧。亮度、清晰度、文字或边缘数量以及图像处理程度等,均可作为选择依据。因此,最新到达的帧不一定就是最佳输入。相机短暂抖动造成某帧模糊时,相邻帧可能仍然清晰。缓存多少帧、采用何种筛选规则、何时开始新一轮处理,都是翻译模型之外需要考虑的设计参数。
3.文字识别与翻译区域的确定
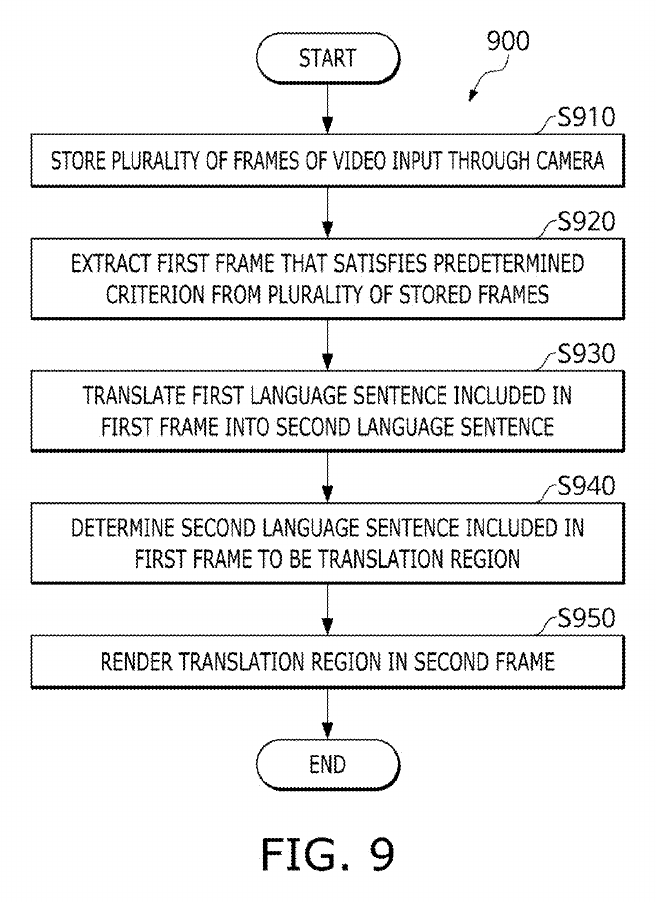
光学字符识别(OCR)将图像像素中的文字转换成可处理的字符信息;把这些文字转换成另一语言,则属于后续翻译步骤。说明书介绍了神经网络文字识别以及利用外部图像翻译装置的方式。系统还依据文字及周边特征确定译文所在区域。例如,指示牌上同时存在标题和时间表时,空间对应关系能避免两部分译文混淆。图9依次展示了存储帧、选择帧、翻译、确定翻译区域以及在另一帧中渲染该区域的流程。
4.将译文映射到当前视角
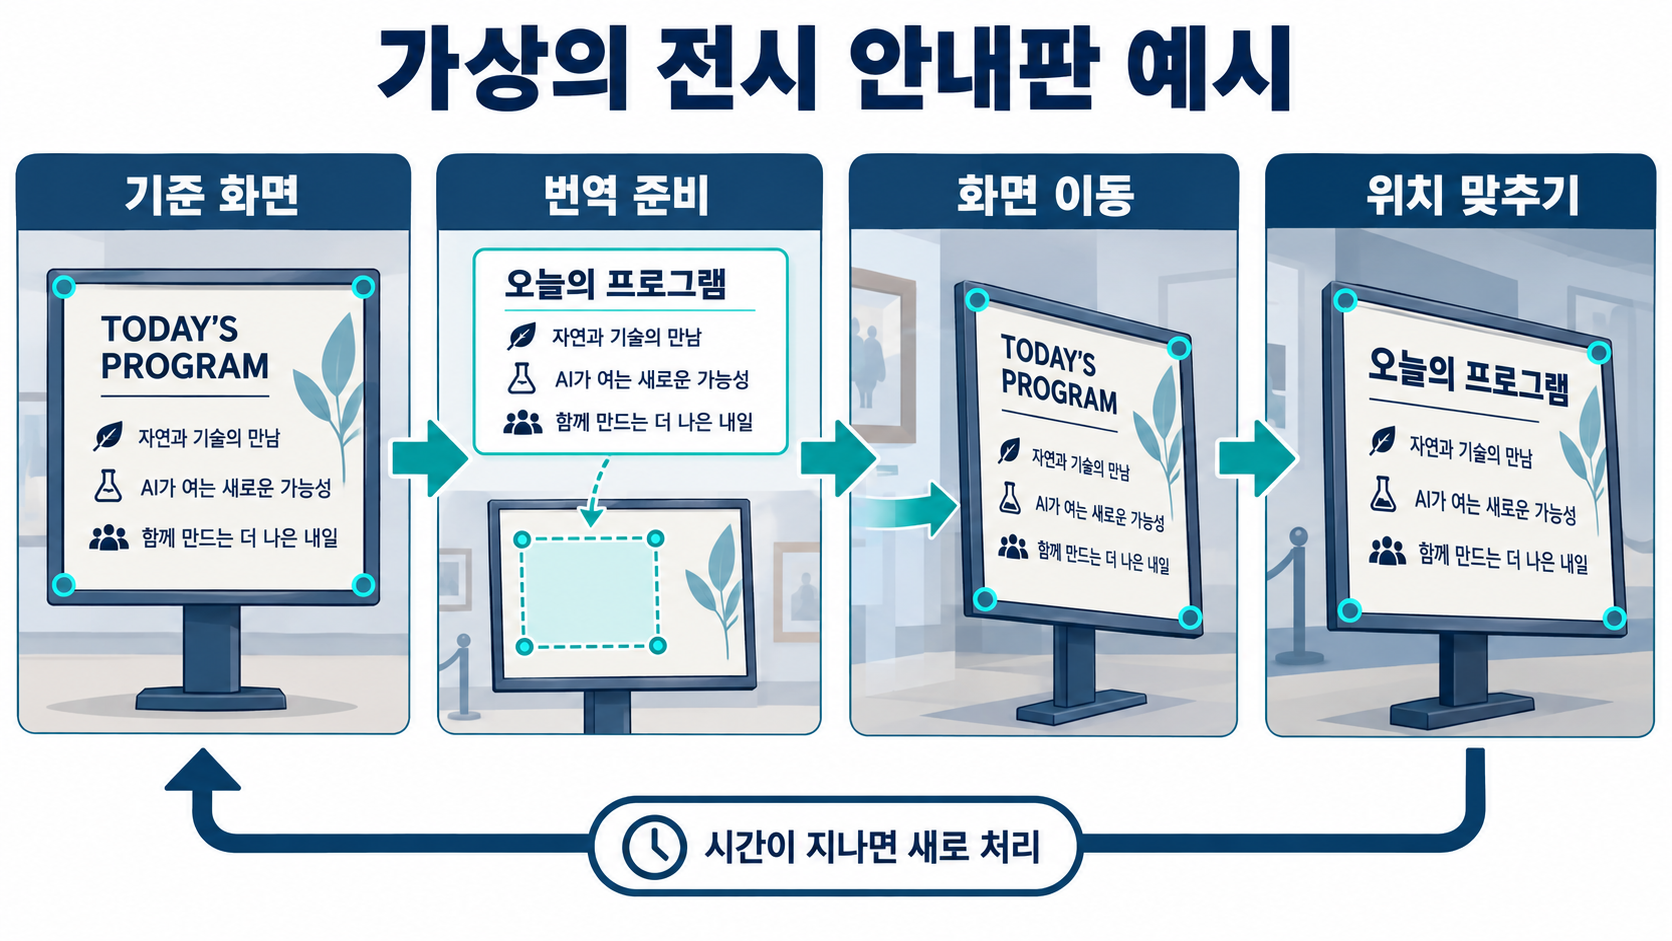
原本位于画面中央的指示牌,在后续帧中可能向一侧移动,或呈现倾斜的四边形。系统利用角点、周边图案等可辨识的关键点,建立两帧之间的对应关系,再通过特征变换模型确定翻译区域的新位置。其中一种实施方式采用单应性矩阵,对同一平面在不同视角下的图像进行射影映射。渲染则是将译文合成到后续帧的相应区域。将翻译内容与显示几何关系分开处理,有助于在相机持续运动时更新结果的显示位置。
5.按时间间隔选择匹配或跟踪
该专利区分时间间隔较长和较短的帧。间隔较长时,可以分别提取两帧中的关键点和描述子,进行特征匹配并估计变换;间隔较短时,则可利用光流跟踪已有关键点的移动。这是显示区域更新方法的选择,并不是更换翻译模型。文中的虚构示例将指示牌标题“TODAY’S PROGRAM”译为韩文,随后按相机移动后指示牌的新位置调整译文。图中关键点为便于理解而作了简化,不代表实际产品的性能测试。
6.及时更新已经过时的结果
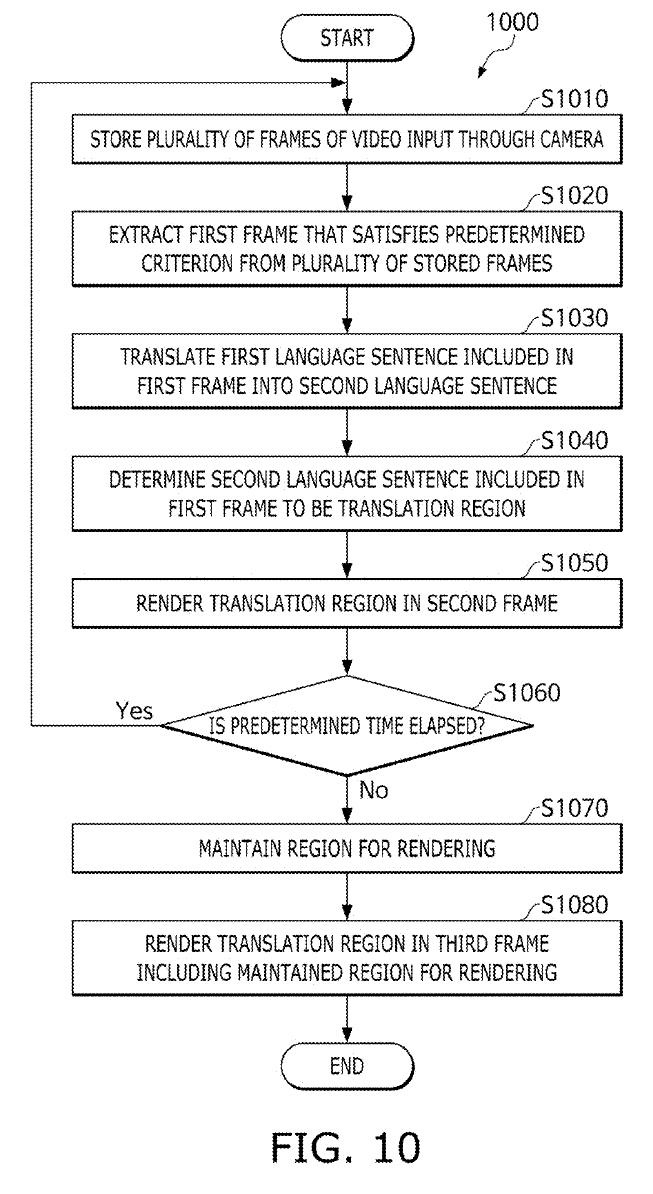
相机转向另一块指示牌后,不能无限沿用此前准备好的译文。图10给出时间驱动的循环:渲染后判断是否经过预定时间;尚未经过时,维持区域并继续显示;达到条件时,则返回存储、选择新帧并重新翻译的步骤。其他实施例还描述了时间差或运动差异过大时,不显示原有结果而重新开始处理的情形。该规则判断的是结果能否继续用于当前画面,而不是评估译文本身的语言准确性。
7.对AI产品设计与专利分析的启示
Papago官方材料介绍了图片翻译和AR实时翻译,NAVER Cloud文档则说明识别图中文字后返回译文文本或合成图像的功能。开发团队除关注翻译模型外,还应检查输入选择、计算期间的画面变化以及显示区域的重算条件。可分别测试静止指示牌、缓慢移动、斜向拍摄和目标切换,并记录输入帧、显示帧及更新时点,以定位具体环节的问题。专利分析应关注权利要求中处理步骤的组合,而不是笼统地把“翻译指示牌”视为受保护的全部内容。原始附图与虚构示例用于解释技术关系,不作为性能数据。