
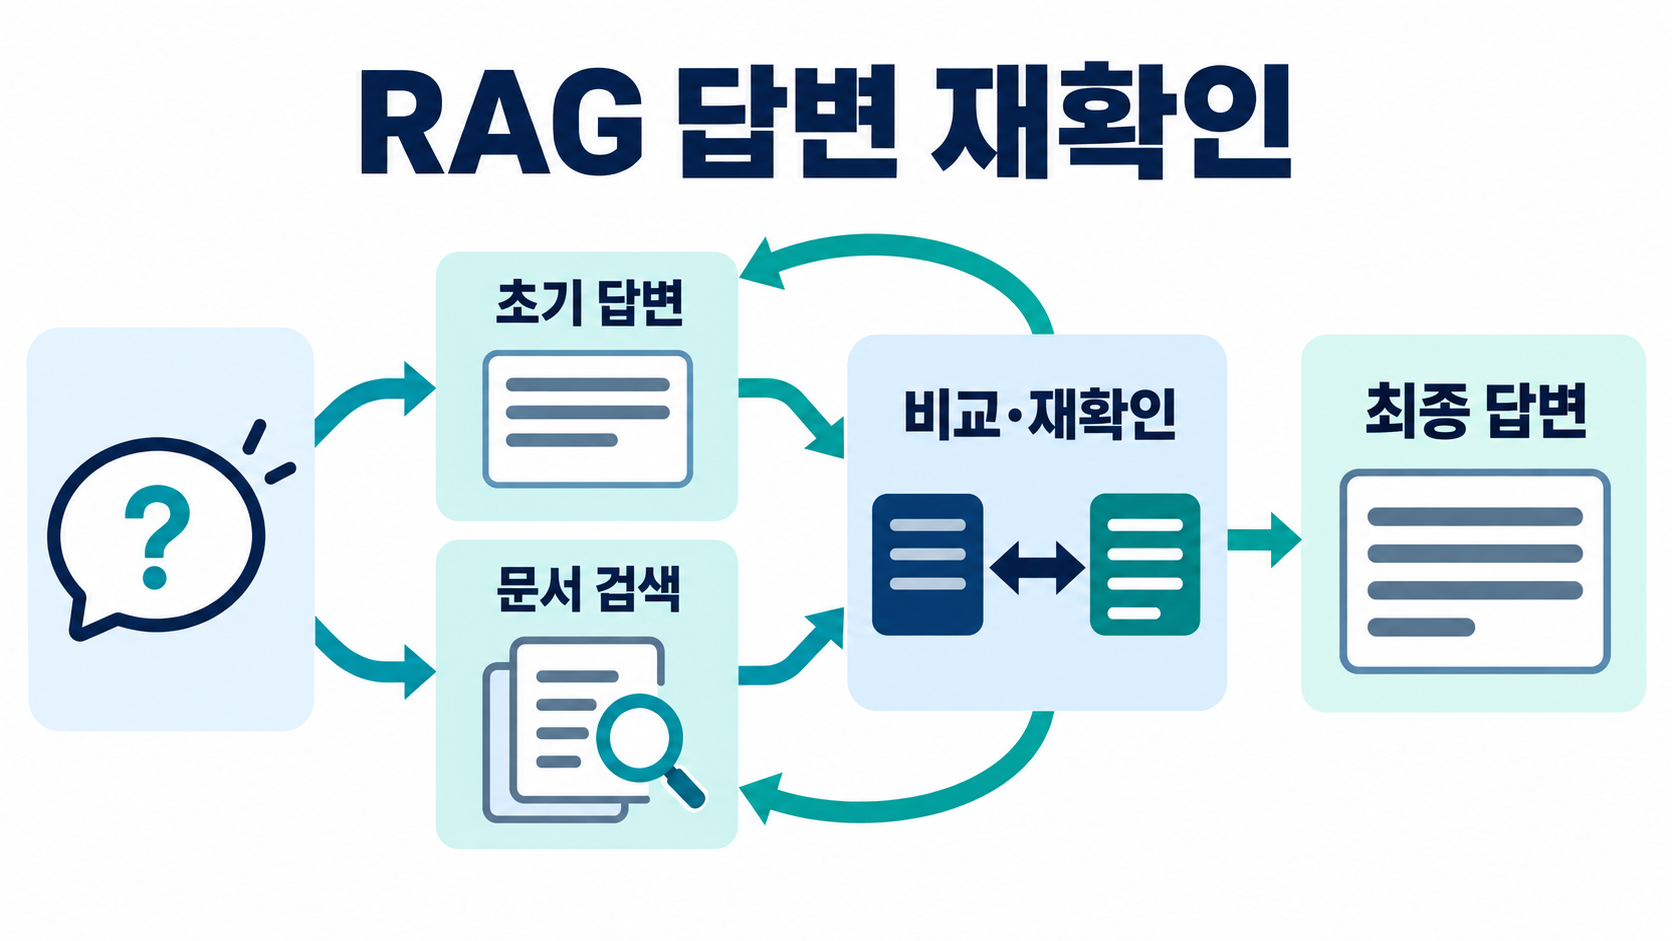
两种看似合理的答案
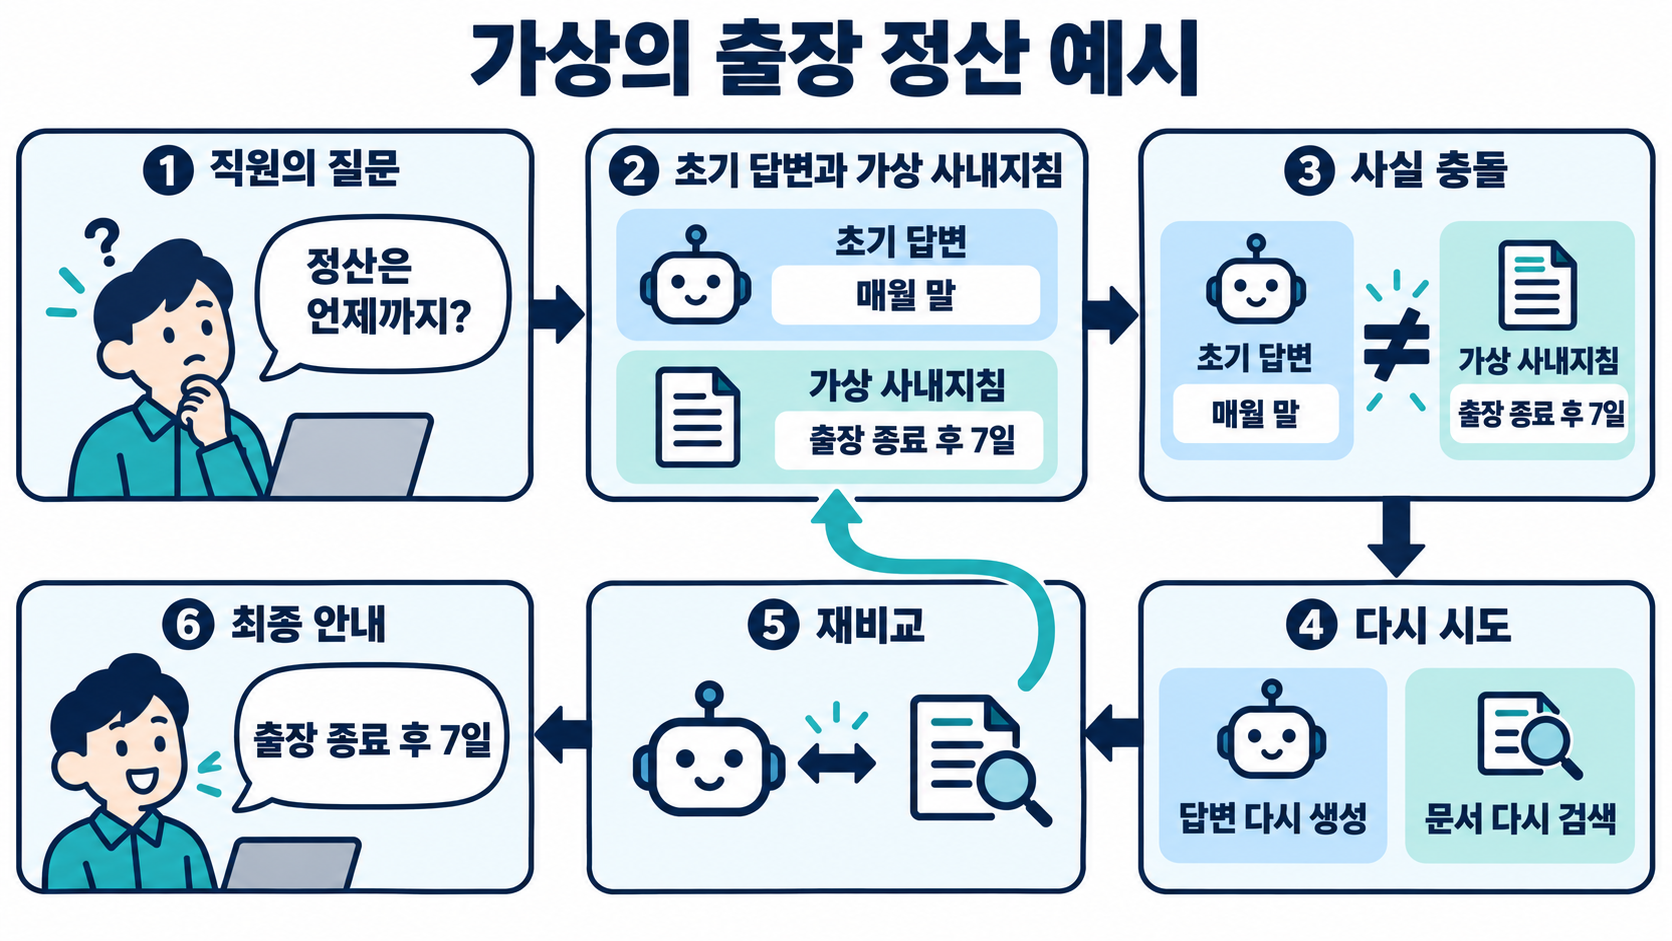
假设模型回答报销截止时间为“月底”,检索到的制度却写着“出差结束后七日内”。这只是教学示例,不是百度真实制度。增加检索资料不等于解决应采信哪项信息的问题。模型训练形成的参数化知识可能与外部资料不一致,而RAG通常是在推理时补充检索内容,并不必然重新训练模型。
本文分析的是2026年3月26日公开的美国专利申请US20260087055A1,申请人为Baidu Online Network Technology (Beijing)。A1表示申请公开,不证明已获授权。以下讨论限于公开的处理流程,不据此认定当前法律状态或某商业产品已实施该方案。
初始结果不只包含一句回答
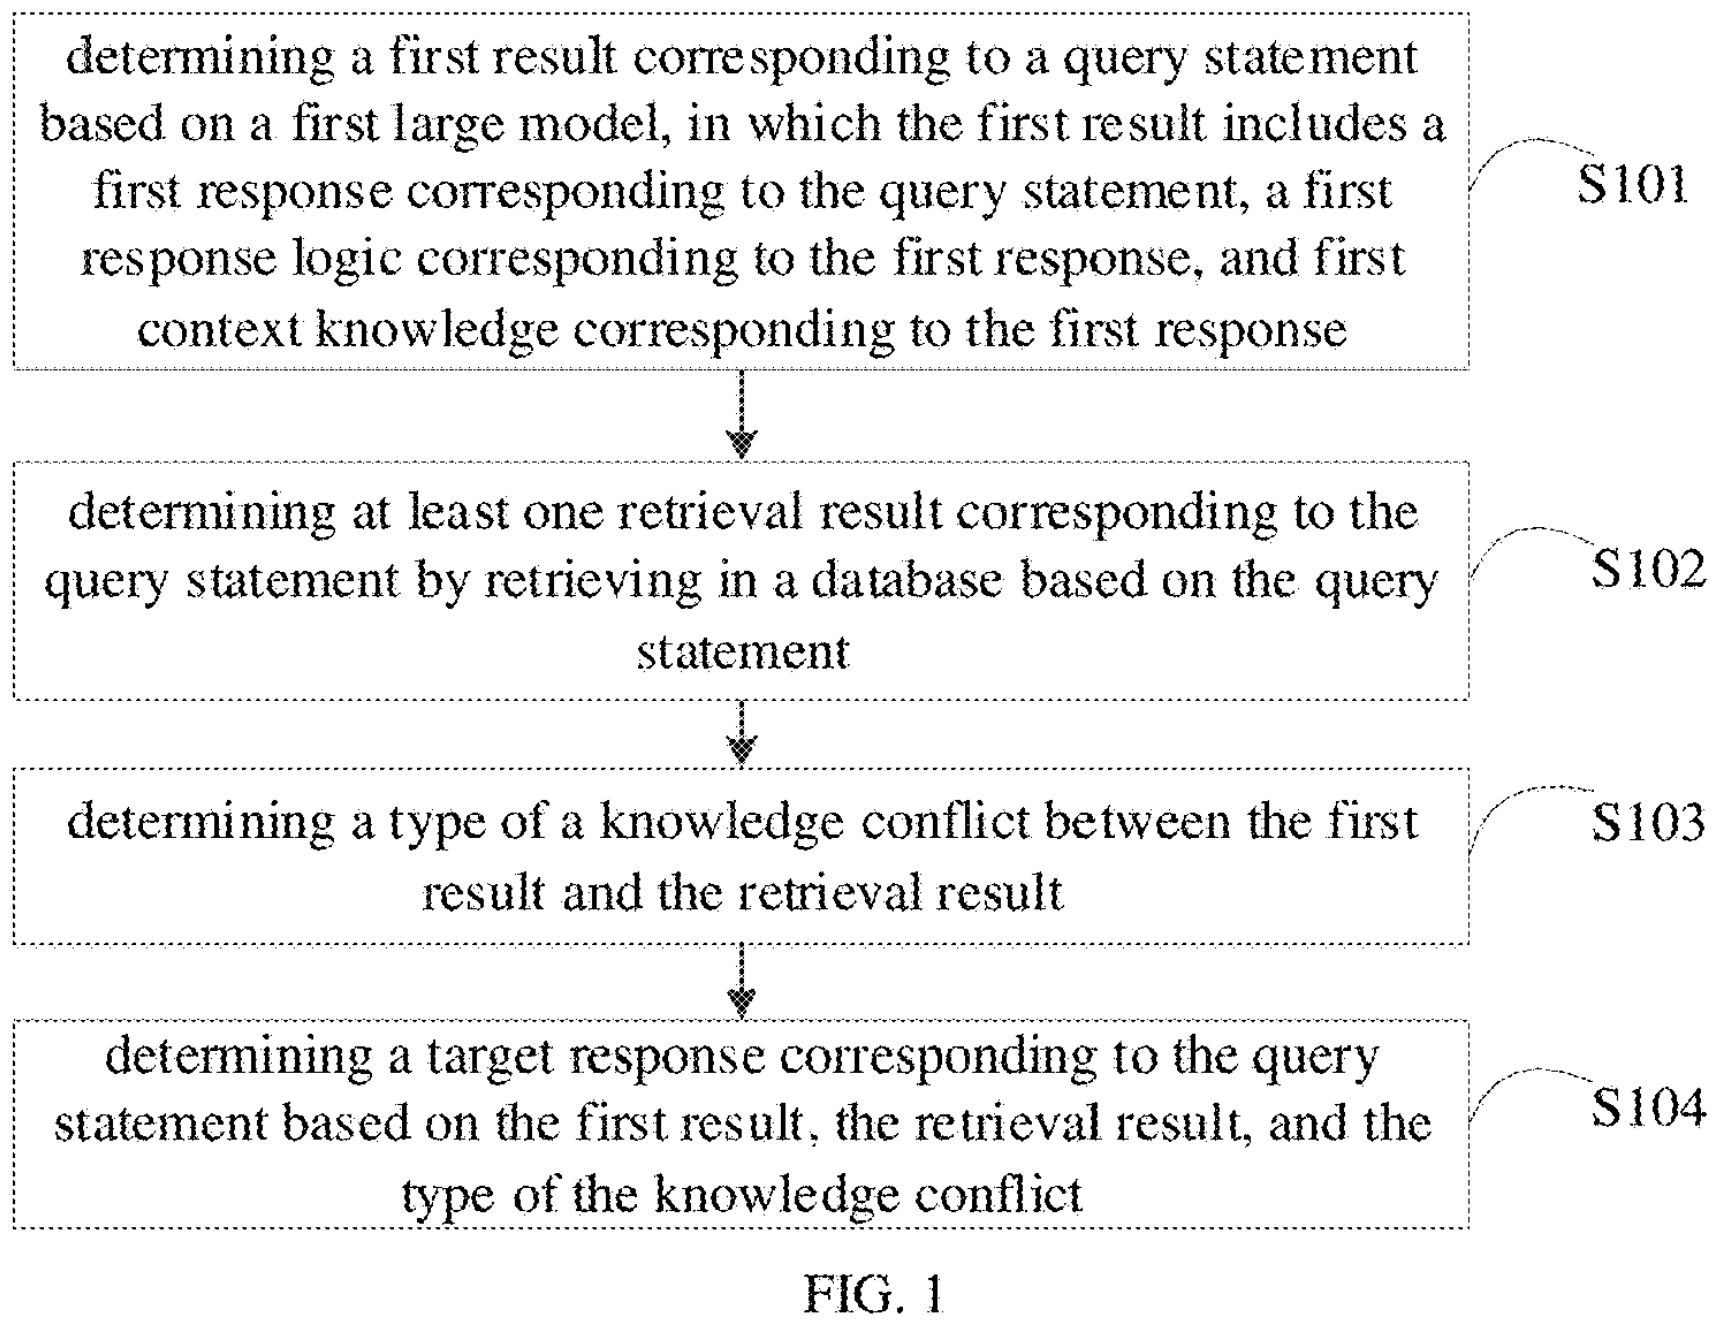
申请中的第一结果包括回答、回答逻辑和上下文知识,为与外部结果的比较提供更多材料。“回答逻辑”是生成的解释,不能直接视为模型隐藏计算过程的真实记录。系统同时根据问题从数据库或其他相关来源检索。
图1将初始生成、检索、知识冲突类型判定和目标回答生成分开。相关来源可以是文档集合、数据库或网页,不同实现可使用相同或不同来源。技术分析重点在于各阶段交换的数据和后续分支,而不只是给语言模型增加搜索入口。
区分事实不一致与语义关系错误
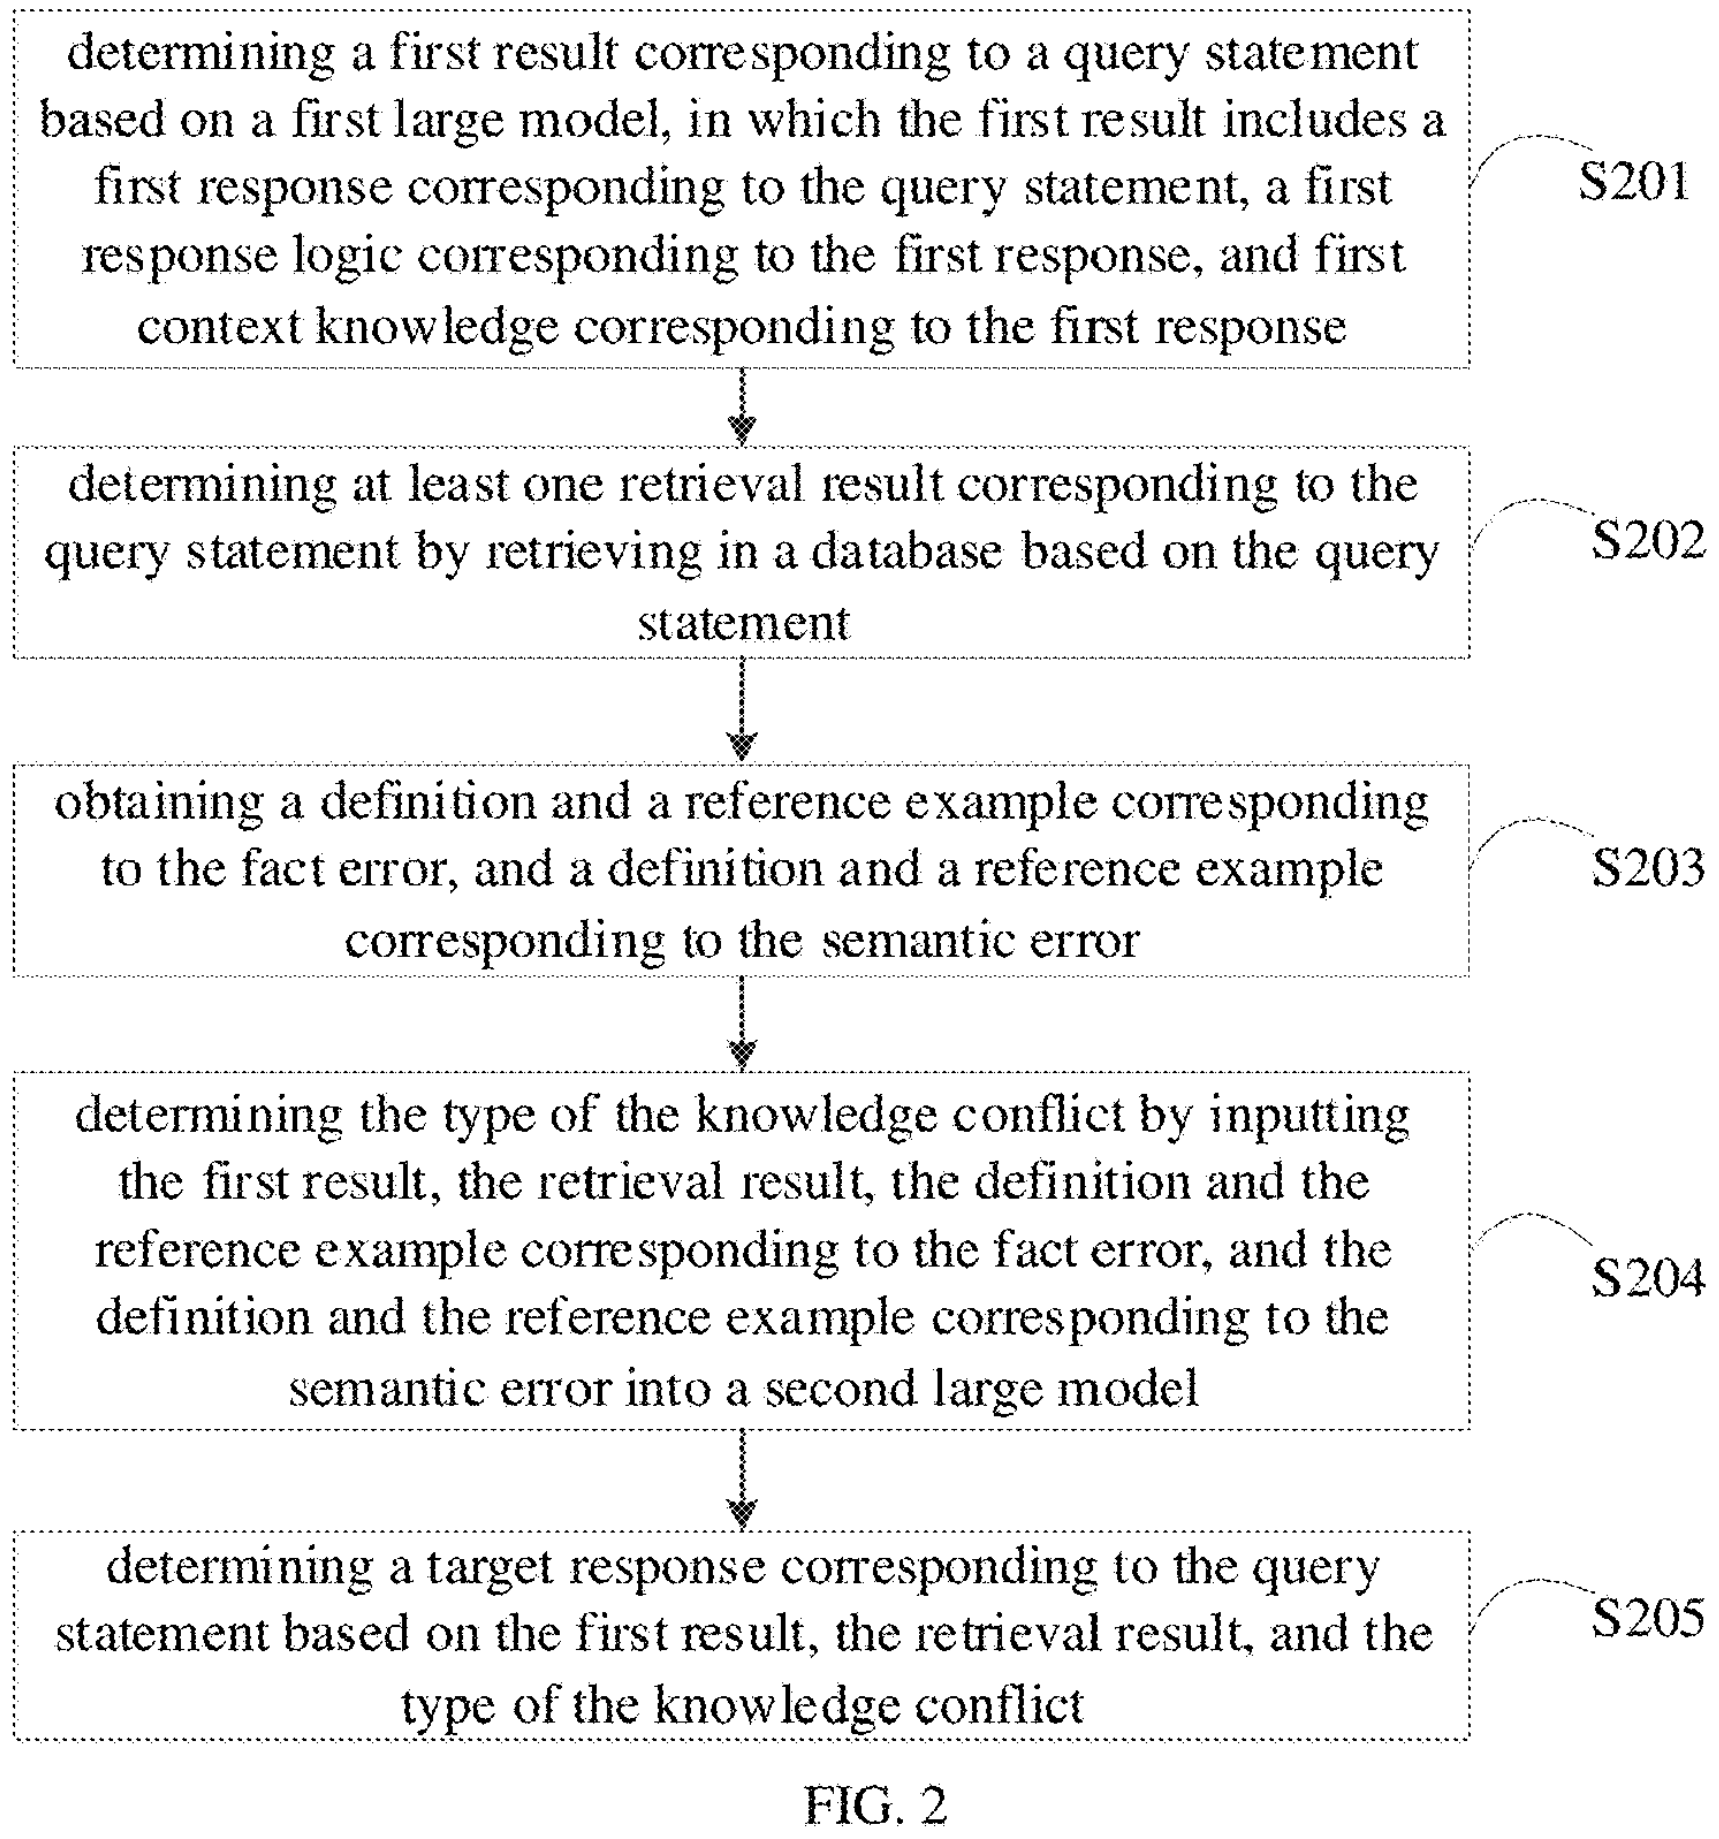
事实冲突涉及日期、金额、期限等信息;语义冲突涉及角色和关系,例如“主管审批员工申请”与“员工审批主管申请”虽然词语接近,含义却不同。也可以定义其他类别,但本申请重点展开事实错误和语义错误。
图2的分类环节输入初始结果、检索结果以及冲突定义和参考示例。各环节可由同一模型或不同模型承担。明示定义与例子有助于明确分类任务,但不能保证模型作出的类别判断一定正确。
不同冲突进入不同处理分支
语义冲突分支可将两类结果、冲突类型及相应定义、示例交给回答处理模型,重新处理语义关系。这不等同于直接用检索句子覆盖原回答;模型生成的说明仍需验证。
事实冲突分支则再次向原模型提问、重新检索并对新结果重新分类,直到冲突类型不再属于事实错误。更新的并非只有模型答案,检索资料也可能过时或有误。报销示意图仅用于解释这一流程;两边一致或分类改变,本身并不能证明结论真实。
千帆平台提供的实际技术背景
百度千帆支持大模型和Agent工作流。其知识库节点提供全文检索、语义检索、混合检索及重排序,并把召回片段传递给下游。官方RAG工作流将知识内容和用户原始问题分别作为模型输入。
这些说明帮助理解检索与生成如何组合,但不证明千帆产品实现了本申请每项权利要求,也不证明所有工作流使用冲突循环,更不能作为授权证明。产品文档与专利公开内容应分别核查。
工程记录及专利分析
可沿问题、第一结果、检索证据、冲突分类、处理分支、最终回答逐步记录。文档版本、处理延迟和再次检索的条件值得关注。循环上限、人工升级处理及证据质量控制属于合理的部署考虑,不能未经核对就写成申请必然要求的技术特征。流程日志也不等于更新模型权重。
知识产权分析应明确输入信息、定义、决策条件及处理变化,再与在先技术和实际权利要求比较。IPLEX可依据能够公开分享的系统流程图、冲突实例与评价条件,协助分析AI及软件的技术差异。本文并未据此确认新颖性、有效性、自由实施或实测性能优势。