
生成処理に必要なメモリー
本稿はWoosuk Kwon、Zhuohan Liらが2023年9月12日に提出した「Efficient Memory Management for Large Language Model Serving with PagedAttention」のarXiv第1版を解説します。自己回帰モデルはトークンを一つずつ生成し、KVキャッシュに計算済みのキー・値を保持します。これは利用者の文章をそのまま保存する文書ではありません。系列が長いほど容量が増え、要求ごとに大きな連続領域を予約すると未使用領域や断片化が生じます。対象はモデル再学習ではなく、割当てと共有です。
論理順序と保存位置を分ける
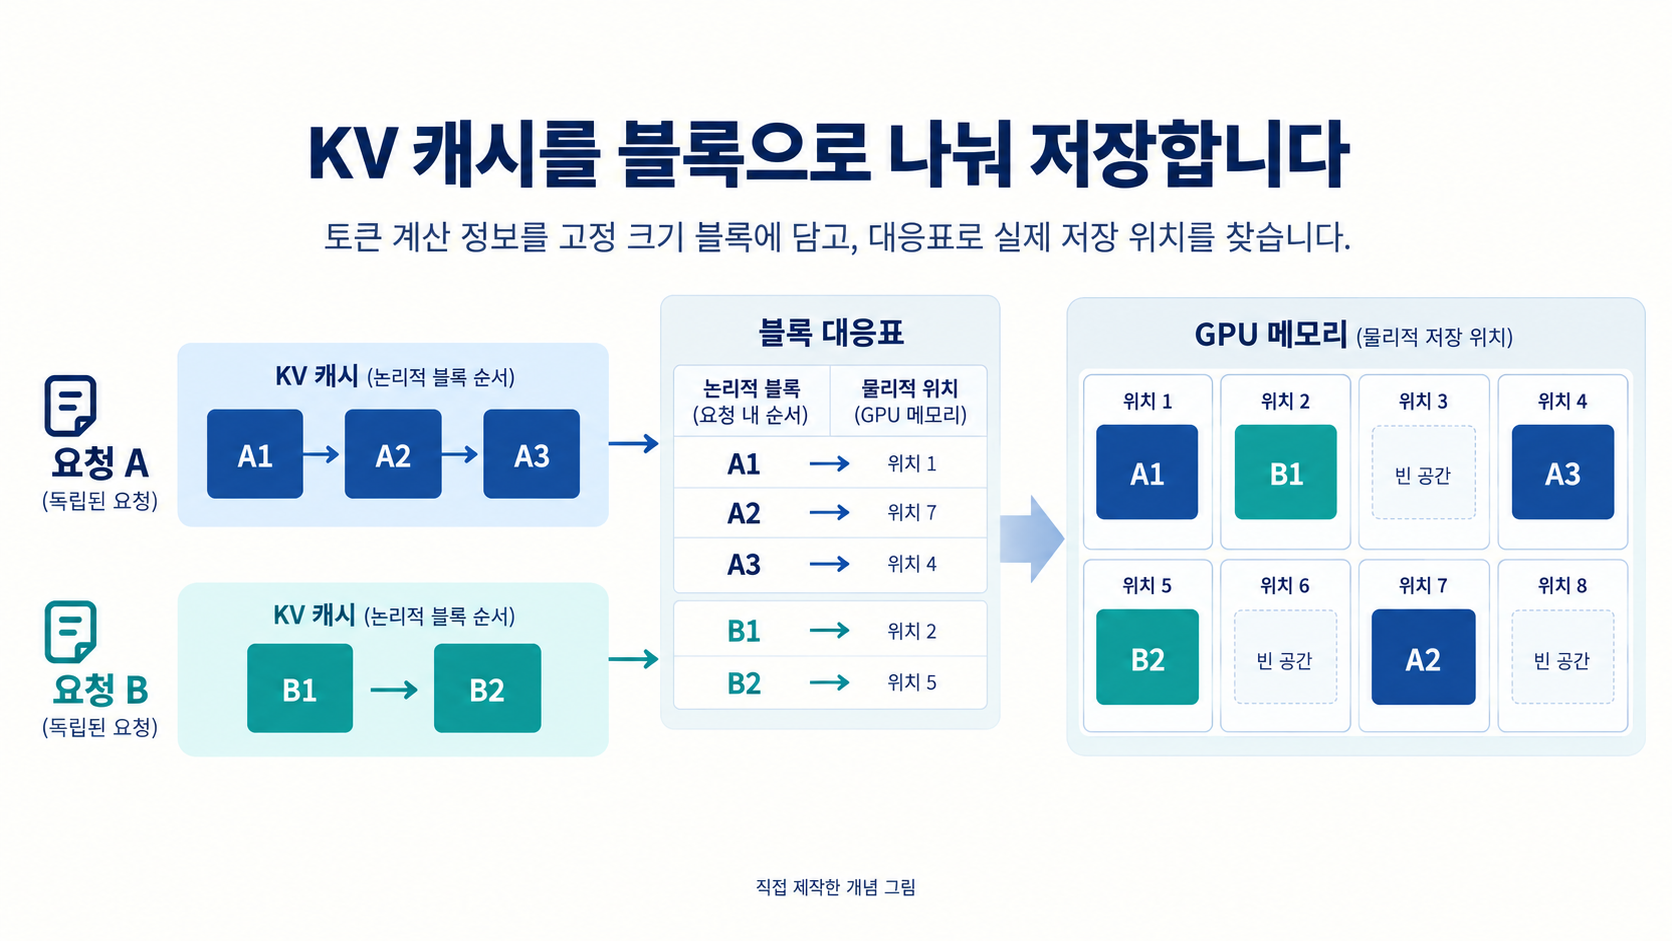
一定数のトークンのKV情報を一つのブロックに格納し、ブロックテーブルが要求内の論理順序とGPU上の物理位置・使用状況を対応付けます。論理的に隣接していても物理的に連続する必要はありません。入力に必要な分を確保し、最後のブロックの空きを使い、満杯になった時に追加します。注意計算はこの対応をたどるため順序を保持します。メモリープールを共用しても要求ごとの対応表は独立し、無関係な利用者の会話を混ぜる仕組みではありません。
同じ入力から二つの回答候補を作る例
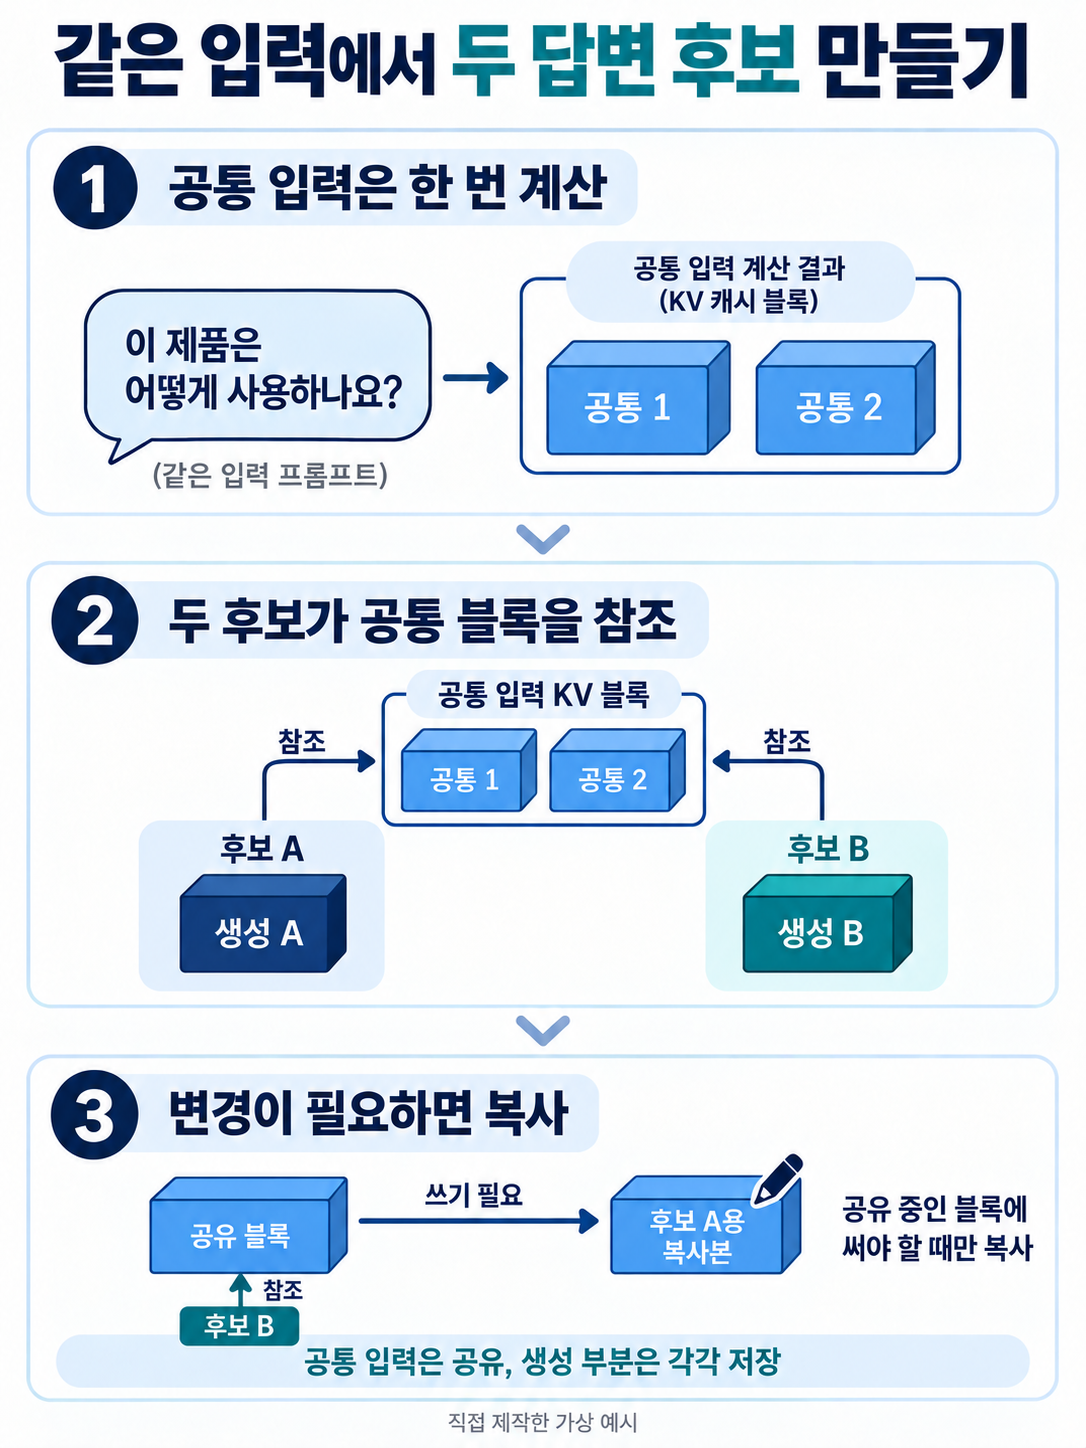
同一の質問と指示から回答候補A・Bを生成する仮想的な相談ツールを考えます。入力部分の対応表は同じ物理ブロックを参照できますが、分岐した生成部分は別に保存します。同じ単語でも文脈や位置が異なればKVは一致しません。共有する末尾ブロックに空きがあり、他の参照を残したまま書き込む場合は書込み時コピーを用います。満杯の共通ブロックは共有を維持し、分離が必要な部分だけを複製又は新規割当てします。参照がなくなれば回収します。図は概念例で、製品画面や測定結果ではありません。
約2倍という結果の読み方
論文6.5節では、チャットボット実験で三つのOrca比較方式に対して約2倍の要求到着率を処理できたと報告しています。対象はその遅延条件下での処理能力で、回答精度2倍や全回答の時間半減ではありません。要求の到着時刻は実験用に生成され、会話ターン間のKVキャッシュも保持していません。仮想の相談サービスの実測ではなく、入力・出力長、GPU容量、到着パターンで改善幅は変わります。
保存管理と技術的な差異の整理
ブロック管理は必要な履歴だけを検索したり重要度の低いトークンを捨てたりする方法ではなく、モデルの文脈長を自動拡張もしません。小さいブロックは末尾の空きを減らしますが、対応表の管理負担もあります。FlashAttention-2が計算順序・並列配分を扱うのに対し、こちらは増え続けるKVの配置・共有が中心です。開発や知財相談では、割当て時点、対応表、共有条件、複製・回収、入力出力長と同時要求数を記録し、単なる「省メモリー」以上の処理差異を説明します。これは論文実験と区別する実務上の提案です。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。