
Por qué la generación necesita memoria
Se analiza la versión 1 de arXiv del trabajo de Woosuk Kwon, Zhuohan Li y colaboradores, presentado el 12 de septiembre de 2023. Los modelos autorregresivos generan un token cada vez. La caché KV conserva claves y valores calculados para la atención, no un documento con el texto literal del usuario. Su tamaño aumenta con la secuencia. Reservar una región contigua grande por solicitud deja espacio sin utilizar y produce fragmentación entre peticiones de distinta longitud. PagedAttention modifica la asignación y el uso compartido de memoria, no el entrenamiento del modelo.
Separar orden lógico y ubicación física
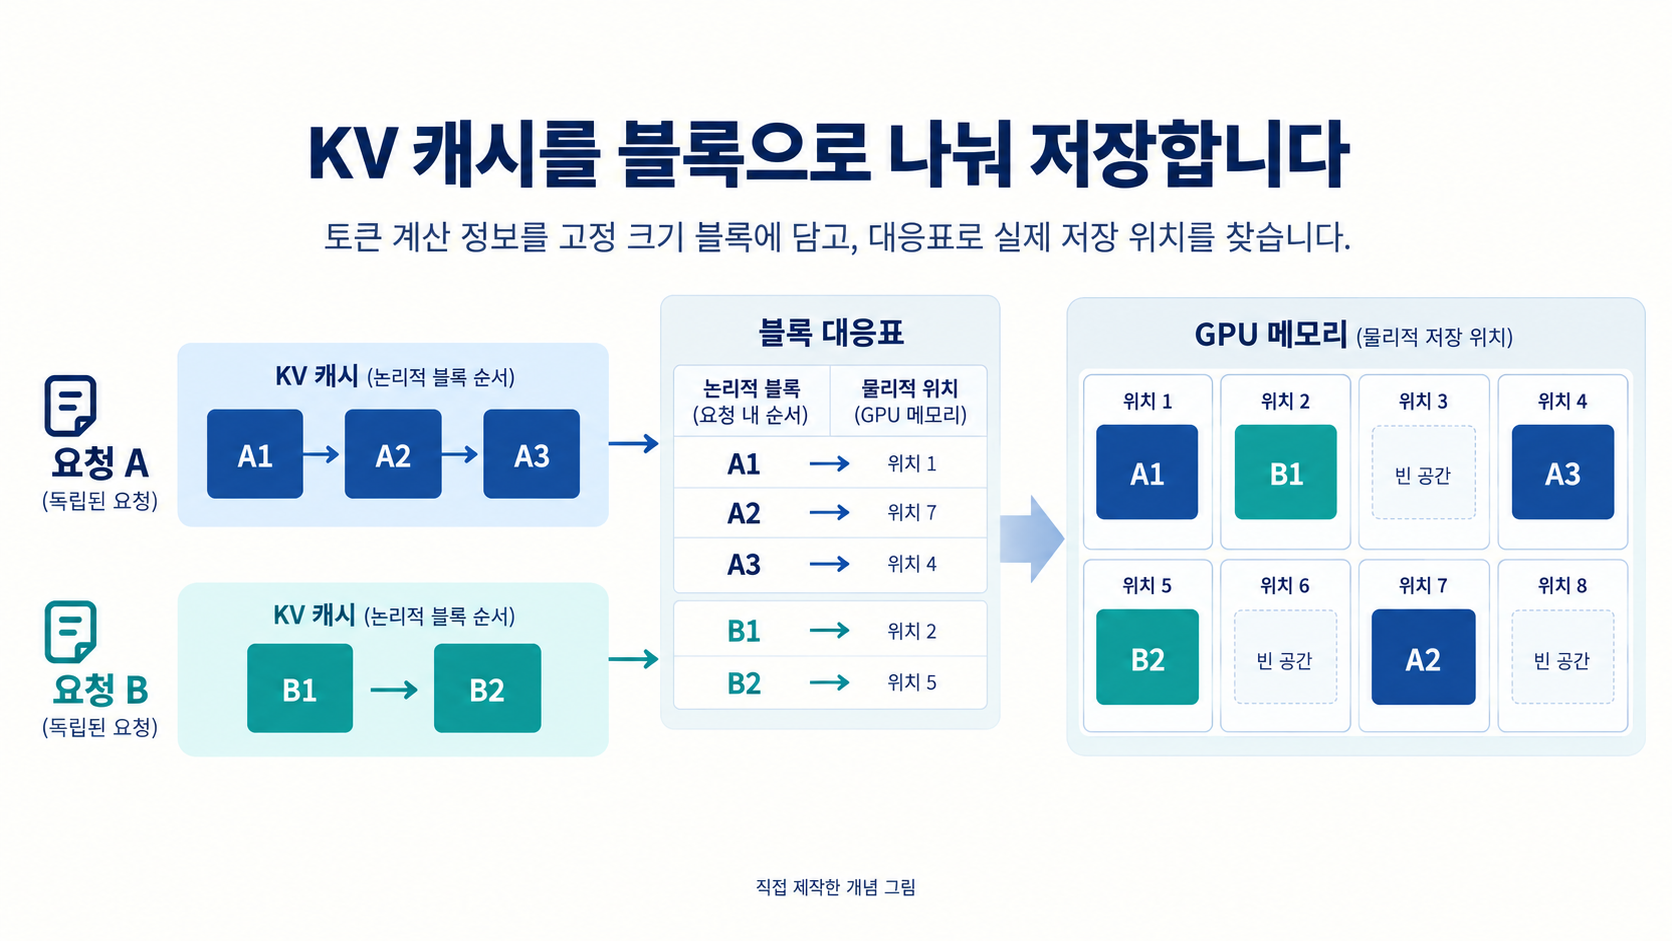
Cada bloque contiene datos KV de un número fijo de tokens. Una tabla relaciona el orden lógico de la solicitud con bloques físicos y posiciones ocupadas; los bloques contiguos lógicamente no necesitan estar juntos en la GPU. Se asigna lo necesario para la entrada, se completa el último bloque y se añade otro cuando hace falta. La atención sigue esa correspondencia y mantiene el orden. Compartir un conjunto de memoria no mezcla conversaciones ajenas: cada solicitud conserva su propia asignación.
Dos respuestas a una entrada: ejemplo hipotético
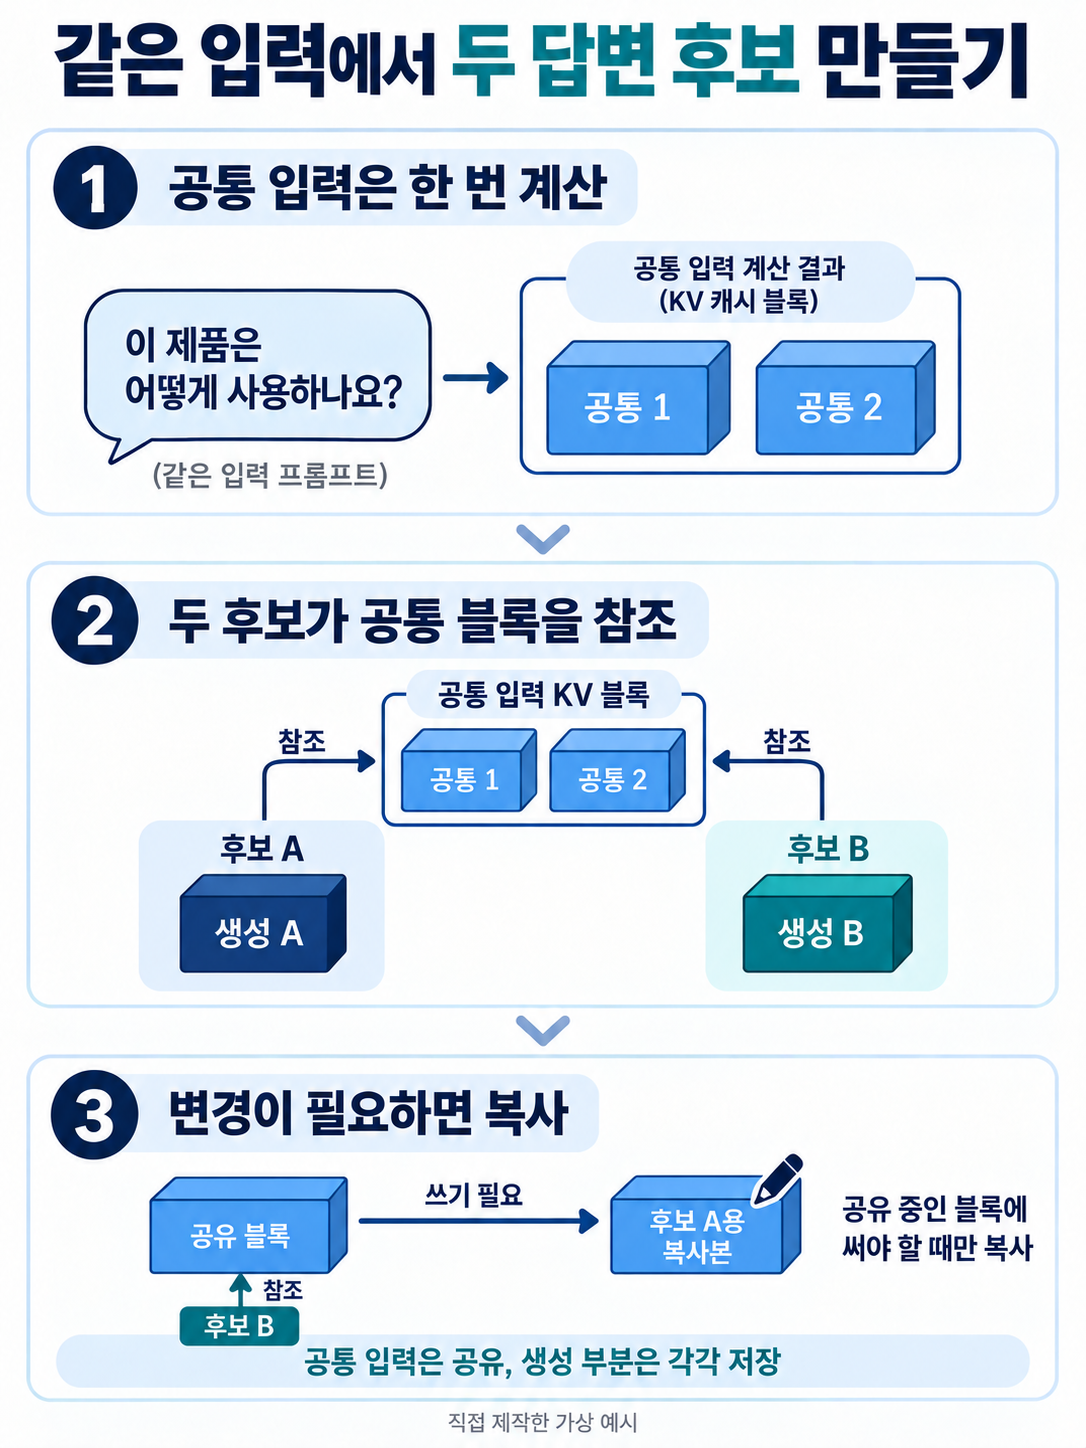
Imaginemos que una herramienta de atención genera A y B desde el mismo texto e instrucciones. Ambas tablas pueden apuntar a los bloques físicos de entrada comunes. Las partes generadas divergen y necesitan almacenamiento separado; compartir palabras no implica valores KV iguales, pues importan contexto y posición. Si queda espacio en un bloque compartido, se copia al escribir cuando existen otras referencias. Los bloques comunes completos siguen compartidos; solo se separa el necesario o se asigna uno nuevo. Los bloques sin referencias se liberan. La ilustración es conceptual, no una pantalla real ni un resultado medido.
Qué significa el resultado de aproximadamente el doble
La sección 6.5 indica que vLLM sostuvo aproximadamente el doble de solicitudes por unidad de tiempo que tres variantes de Orca en un experimento de chatbot. Se refiere a capacidad bajo las condiciones de latencia ensayadas, no a duplicar la precisión ni a reducir a la mitad todas las respuestas. Las llegadas se generaron experimentalmente y no se conservó la caché entre turnos de conversación. No son mediciones del servicio hipotético. Longitudes de entrada y salida, capacidad de GPU y tráfico condicionan la mejora.
Gestión de memoria y documentación técnica
Dividir en bloques no selecciona solo parte del historial, no elimina tokens poco relevantes ni amplía automáticamente la ventana de contexto. Los bloques pequeños reducen huecos finales, pero añaden costes de gestión. FlashAttention-2 optimiza cálculo y paralelismo; PagedAttention se centra en ubicar y compartir KV que crece durante la generación. Para revisión técnica y de PI, documente cuándo se asigna, cómo se mapea, cuándo se comparte, copia y libera, y mida longitudes y concurrencia. Son recomendaciones prácticas, distintas de los experimentos: describa los pasos modificados, no solo «menos memoria».
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Servicio relacionado: patentes de IA
Artículo PagedAttention, versión 1
Análisis técnico original en Tistory