
生成过程为何需要缓存
本文分析Woosuk Kwon、Zhuohan Li等人于2023年9月12日提交的《Efficient Memory Management for Large Language Model Serving with PagedAttention》arXiv第一版。自回归模型逐词元生成,KV缓存保存已计算的注意力键和值,而不是原样储存用户文本的文档。序列越长,缓存越大。为每个请求预留大块连续显存会产生未用空间,长度差异还会造成碎片。PagedAttention解决分配与共享问题,并不重新训练模型。
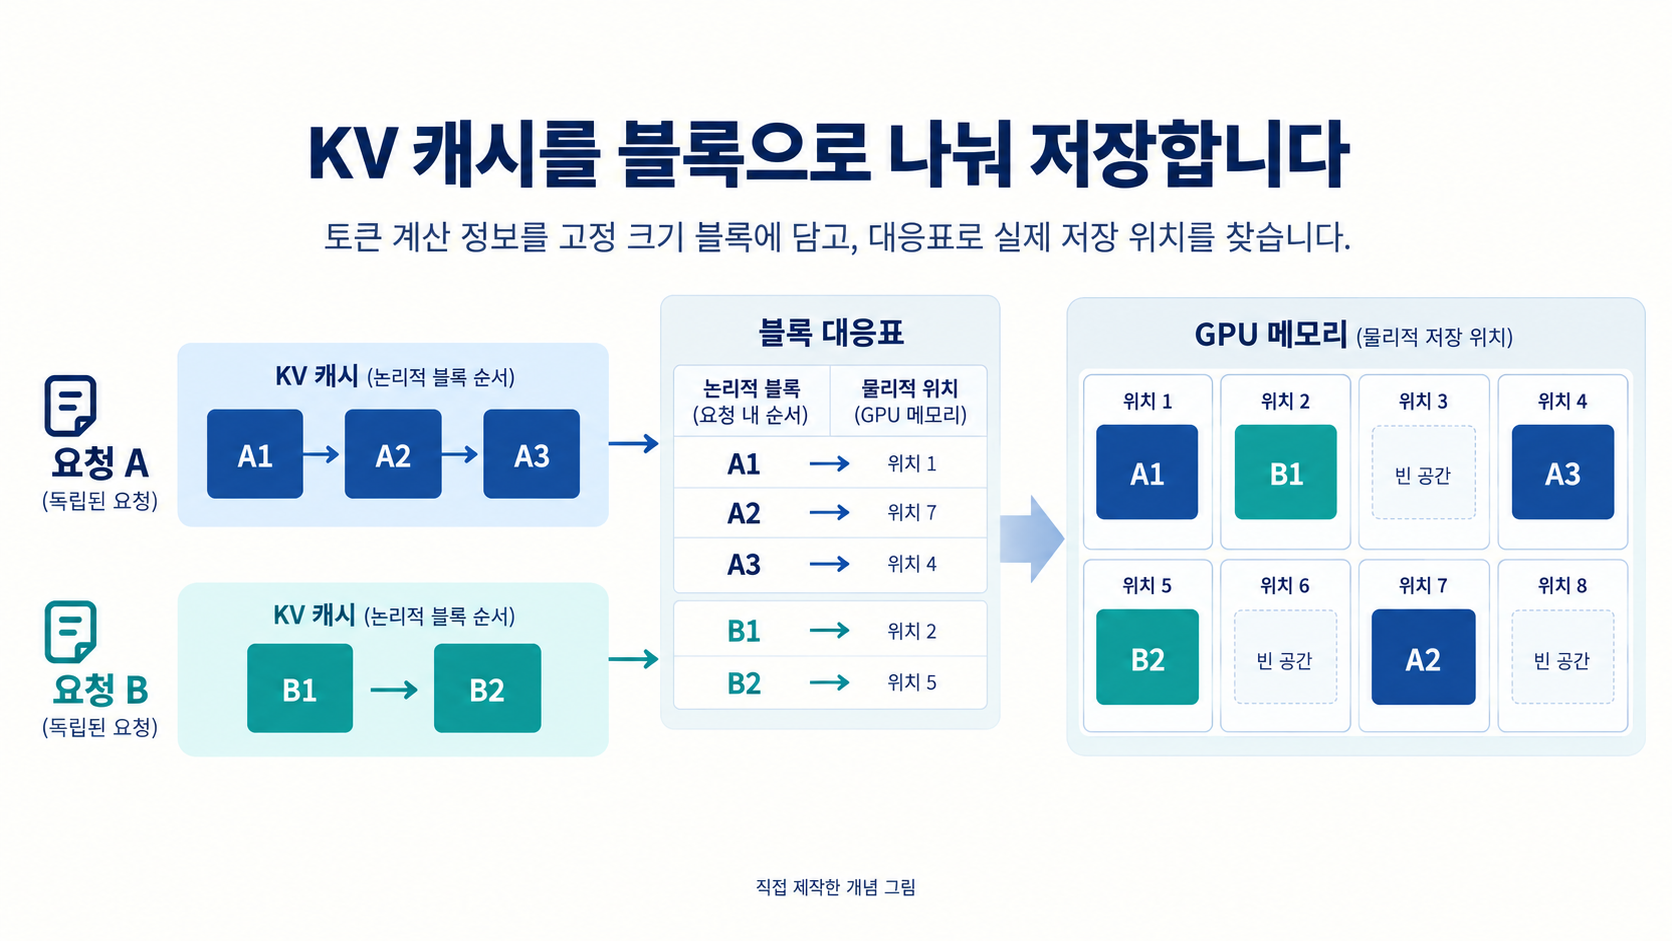
分离逻辑顺序与实际存储位置
每个块保存固定数量词元的KV信息,块表将请求中的逻辑顺序映射到GPU物理块,并记录已填位置。逻辑相邻的块不必物理连续。先为输入分配所需块,后续词元写入末块空位,填满后才增加新块。注意力按映射读取,词元顺序保持不变。多个请求可使用同一显存池,但各自保有映射,并不是把不同客户的对话合并。
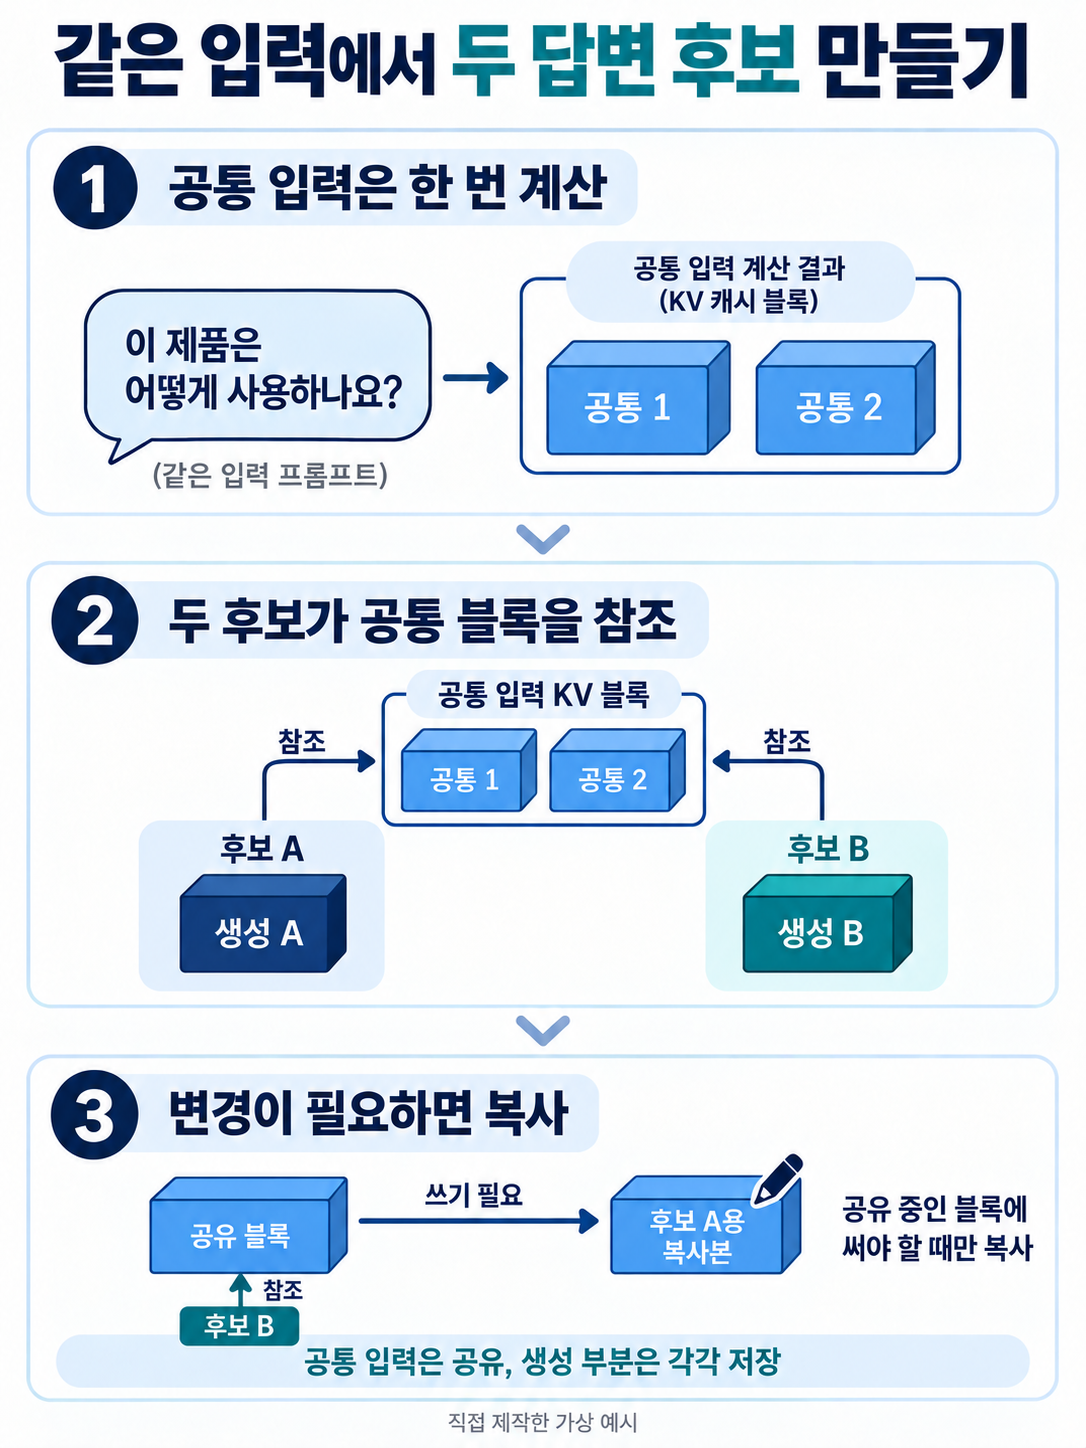
同一提示生成两个回答的假想例子
设想咨询工具根据完全相同的提示和指令生成A、B两个候选回答。两张块表可指向同一组输入物理块,分叉后的生成部分则需独立保存。同一个词也不保证KV相同,因为上下文和位置会影响计算。若共享的输入末块仍有空位,且还有其他引用,写入新词元前需写时复制。已填满的共同块继续共享,仅复制需要分离的块,或分配新块;不再被引用的块可回收。示意图为假想原理图,并非产品界面或测量结果。
如何理解约两倍的实验结果
论文6.5节报告,在聊天机器人实验中,vLLM可承受约为三个Orca基线两倍的请求到达率。这是在所测延迟表现下的吞吐能力,不是回答准确率翻倍,也不表示每个回答都用一半时间完成。实验使用合成的请求到达时刻,且没有在对话轮次之间保留KV缓存。它不是上述假想咨询服务的实测,收益还受输入输出长度、GPU容量和流量模式影响。
存储管理与实现差异记录
分块不是只检索部分历史、丢弃低重要性词元,也不会自动扩展模型上下文窗口。较小块减少尾部空闲,但需考虑映射管理开销。FlashAttention-2侧重注意力计算顺序和并行工作,PagedAttention侧重持续增长KV数据的放置与共享。开发及知识产权咨询可记录分配时机、映射结构、共享条件、复制和回收流程,并结合输入输出长度、并发请求数等测量。这些实务建议应与论文实验分开,明确改变的处理步骤,而不只宣称“节省显存”。
图中保留原始标注与形态,相关内容在正文中说明。