
Зачем генерации нужна память
Статья рассматривает первую версию работы Woosuk Kwon, Zhuohan Li и соавторов, поданную в arXiv 12 сентября 2023 года: Efficient Memory Management for Large Language Model Serving with PagedAttention. Авторегрессионная модель генерирует токены последовательно. KV-кэш хранит вычисленные ключи и значения механизма внимания, а не документ с исходным текстом пользователя. Длинным последовательностям требуется больше памяти. Резервирование большой непрерывной области для каждого запроса оставляет неиспользуемое место и создает фрагментацию. PagedAttention меняет распределение и совместное использование памяти, а не обучение модели.
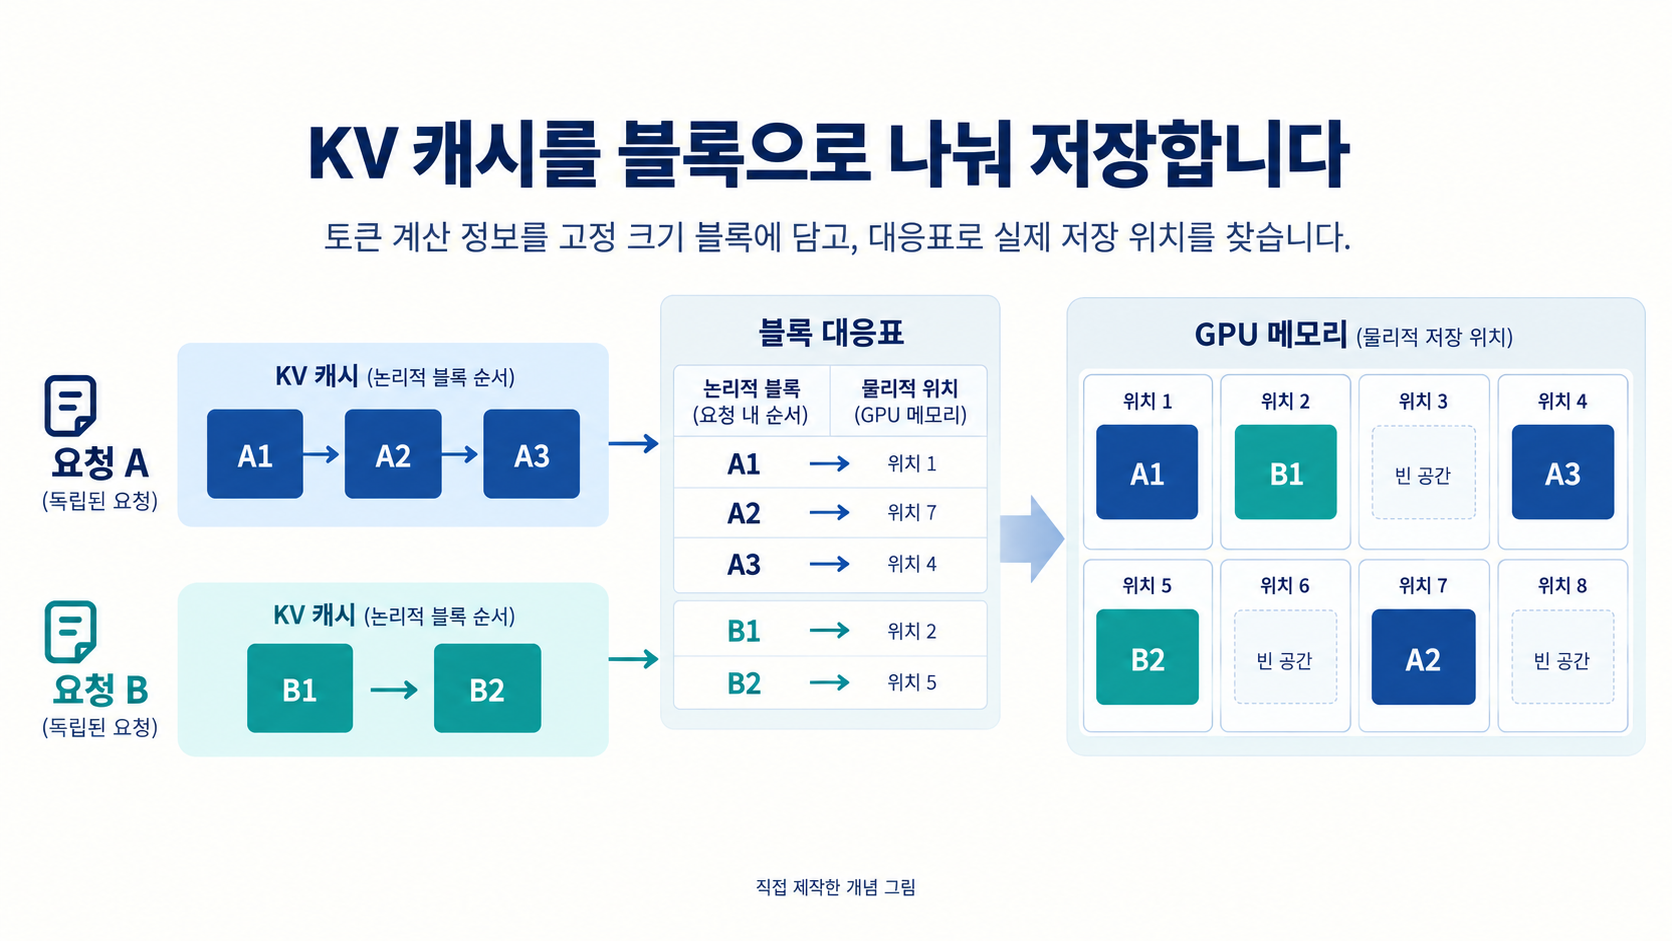
Логический порядок отдельно от физического размещения
Каждый блок содержит KV-данные фиксированного числа токенов. Таблица сопоставляет логическую последовательность запроса физическим блокам GPU и заполненным позициям; соседние логические блоки могут находиться далеко друг от друга. Сначала выделяется память для входа, затем заполняется последний блок, и только при необходимости добавляется новый. Внимание читает данные по таблице, сохраняя порядок. Общий пул памяти не объединяет чужие разговоры: у запросов остаются собственные отображения.
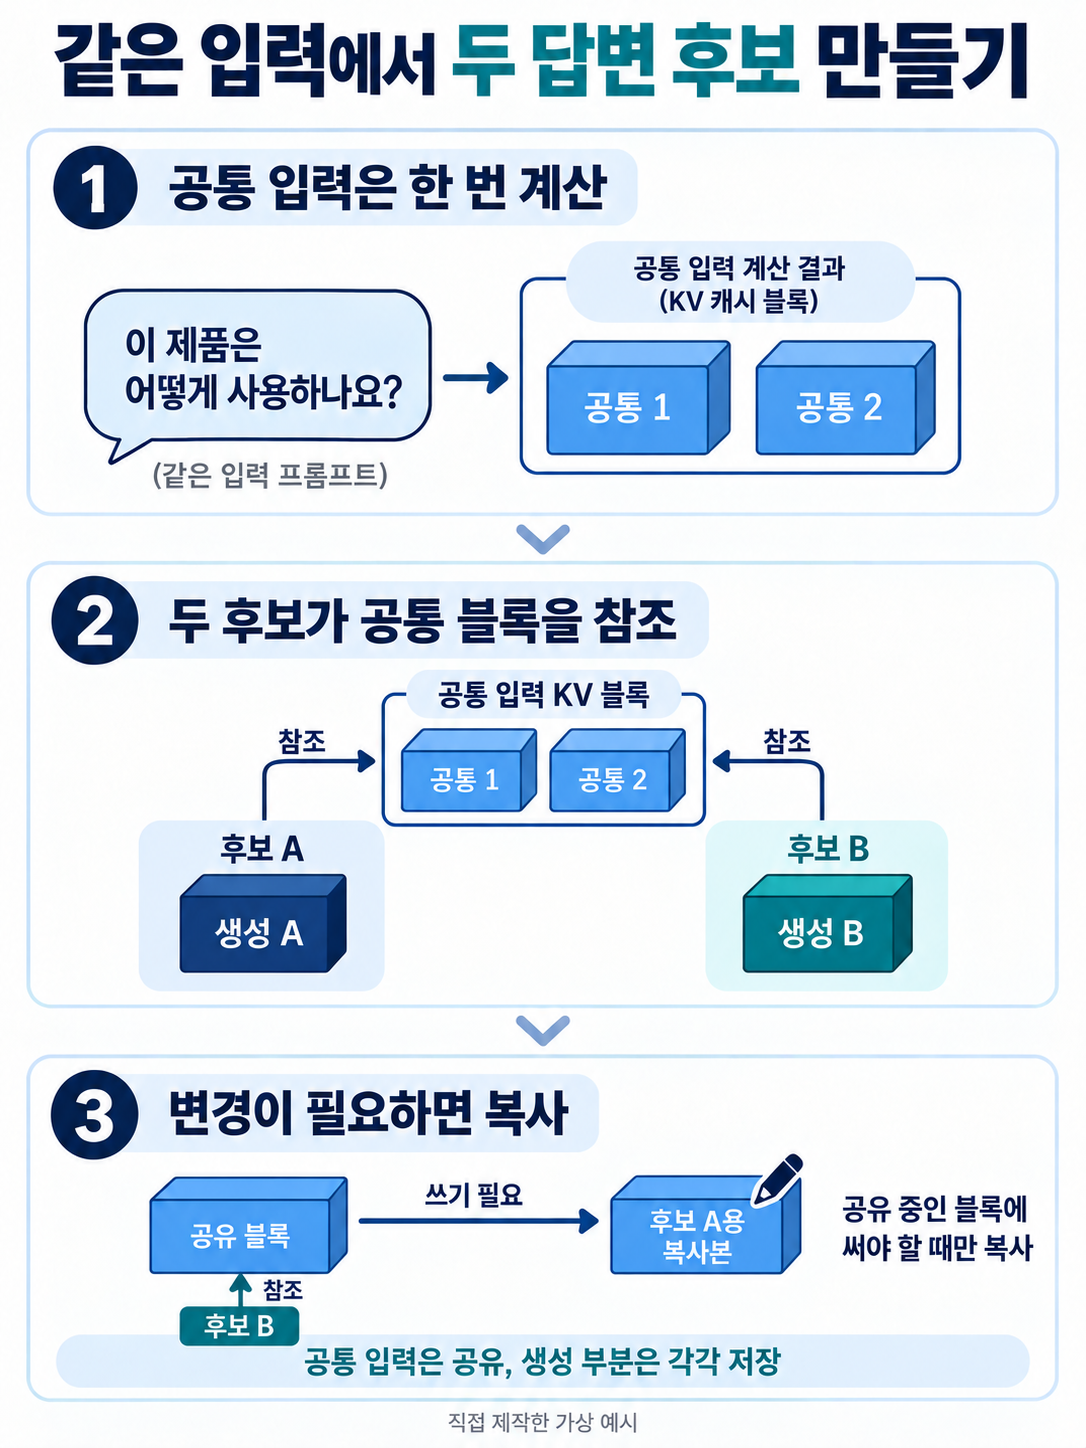
Два ответа на один запрос: условный пример
Предположим, сервис поддержки формирует ответы A и B из полностью одинакового входа и инструкций. Их таблицы могут ссылаться на общие физические блоки входа. Разошедшиеся продолжения хранятся отдельно; одинаковые слова не гарантируют равенства KV, поскольку важны контекст и позиция. Если в последнем общем блоке есть место, при записи и наличии других ссылок применяется копирование при записи. Заполненные общие блоки остаются общими; копируется только требующий разделения блок либо выделяется новый. Блоки без ссылок освобождаются. Иллюстрация условная, не снимок продукта и не результат измерений.
Что означает результат примерно в два раза
В разделе 6.5 сообщается, что vLLM выдерживал примерно вдвое более высокую частоту запросов, чем три варианта Orca в эксперименте с чат-ботом. Речь о пропускной способности при исследованной задержке, а не об удвоении точности или сокращении времени каждого ответа вдвое. Моменты поступления запросов моделировались, KV-кэш между раундами разговора не сохранялся. Это не измерение условного сервиса поддержки. Результат зависит от длины входов и выходов, памяти GPU и характера нагрузки.
Управление памятью и описание технических отличий
Разбиение на блоки не выбирает лишь часть истории, не удаляет малозначимые токены и не расширяет автоматически контекст модели. Мелкие блоки уменьшают свободный остаток, но увеличивают расходы на отображение. FlashAttention-2 улучшает вычисления и параллелизм; PagedAttention управляет размещением и совместным использованием растущих KV-данных. Для разработки и анализа ИС фиксируйте моменты выделения, таблицы, условия совместного использования, копирование и освобождение, длины последовательностей и число одновременных запросов. Это практические рекомендации, отличные от экспериментов статьи: описывайте измененные операции, а не только экономию памяти.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Связанная практика: патенты в области ИИ
Статья PagedAttention, версия 1
Исходный технический разбор в Tistory