
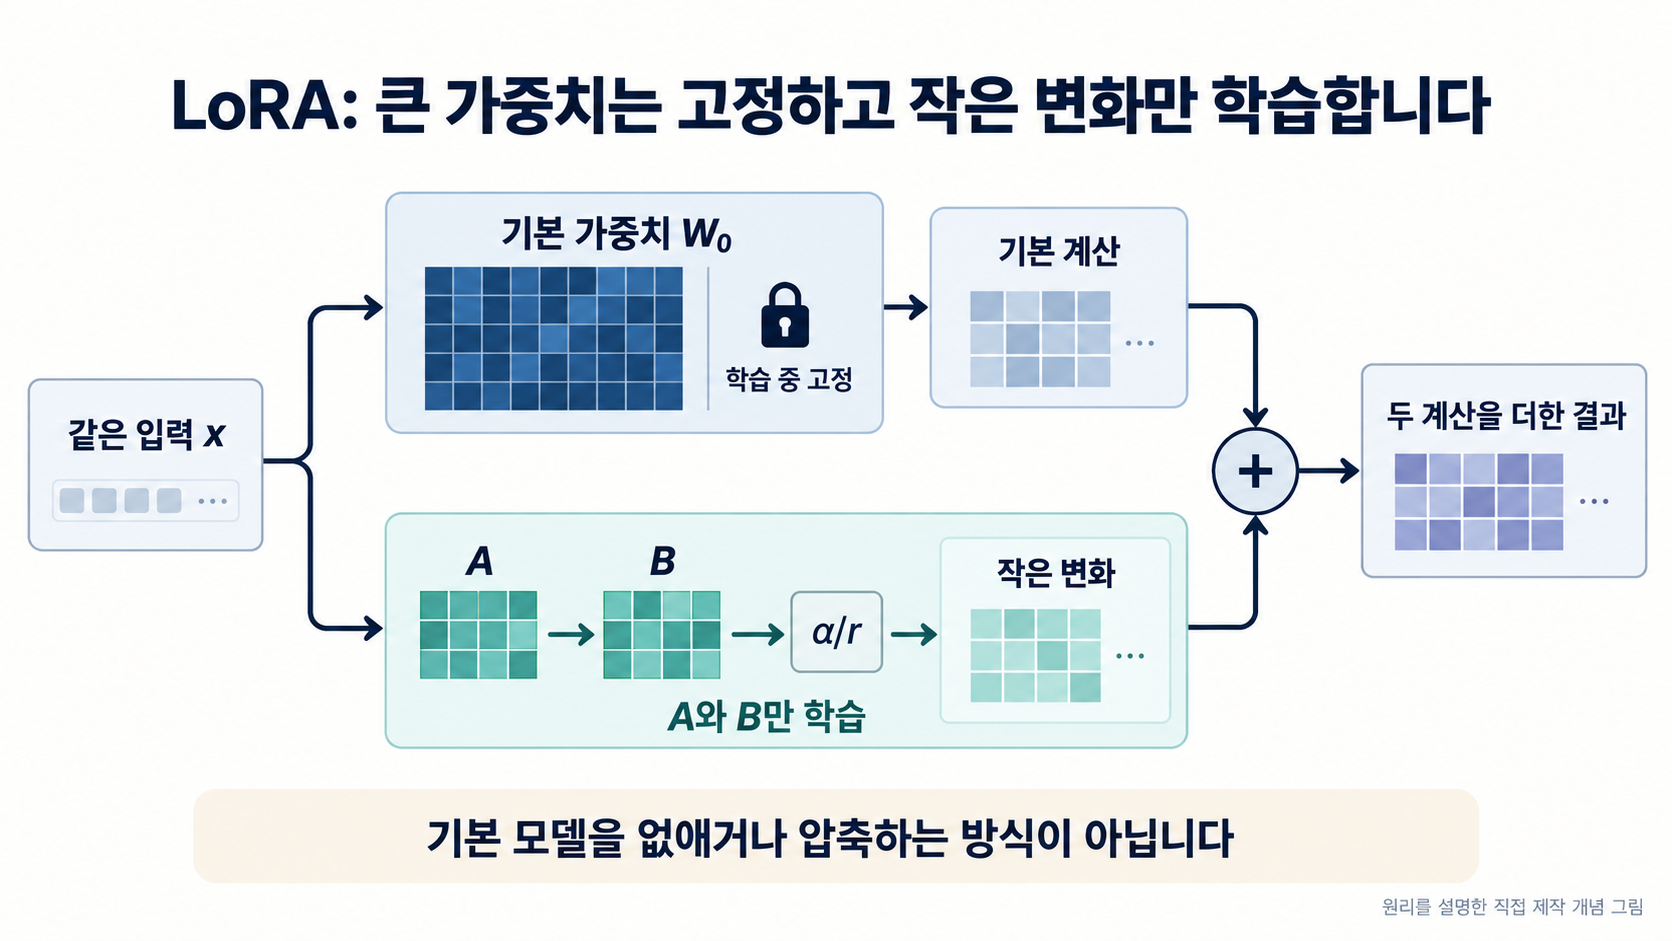
LoRAは、事前学習済みAIモデルの重みを固定し、二つの小さな行列で表した変化分だけを学習する手法です。企業や業務ごとにモデル全体を調整し、保存する負担を抑えることを狙っています。架空のオンラインショップの案内業務と原論文の実験を通して、何が小さくなり、何が引き続き必要なのかを見ていきます。
対象はEdward J. Hu、Yelong Shenらによる論文「LoRA: Low-Rank Adaptation of Large Language Models」です。2021年6月17日に初公開され、同年10月16日に改訂されたarXiv v2を参照しています。
1. 業務ごとのモデル調整で増える負担
同じ言語モデルでも、顧客への案内と商品説明では求められる文章が異なります。案内では手順を順序立てて分かりやすく示し、商品説明では特徴を一定の形式にまとめたい場合があります。こうした業務の例を用いた追加学習がファインチューニングです。その際、モデルの重みを毎回すべて更新する必要があるのでしょうか。
重みは、入力情報を次の計算へ伝える際の働きを左右するモデル内部の数値です。全パラメータのファインチューニングでは、既存の重み全般を学習対象にします。大規模モデルでは、更新する値に加え、勾配やオプティマイザの状態も管理しなければなりません。業務ごとにモデル一式を保存すれば、保存容量の負担も生じます。
LoRAは、事前学習の成果を利用しながら、業務への適応に必要な変化を、より少数の値で表せないかと考えます。元のモデルを削除したり、小型モデルへ置き換えたりする手法ではありません。既存の計算に小さな補正経路を加え、その経路を学習します。
2. 元の計算を残し、変化分だけを学習する
モデル内の一つの計算を、数値を並べた行列として捉えます。元の重み行列をW₀とすると、LoRAは追加する変化分を、小さな行列AとBの積で表します。同じ入力がW₀の経路とA→Bの経路を通り、両者の出力が加算されます。
重要なのは、W₀を固定してAとBだけを学習することです。論文ではW₀x + BAxと表し、実際の補正にはα/rというスケーリング係数も用います。xは入力、rは二つの小さな行列をつなぐ中間次元です。固定とは計算を止める意味ではなく、計算には使い続けながら、学習による重みの更新を行わないことを指します。
低ランクとは、変化分を表す独立した方向の数に制約を設けることです。大きな行列の全要素を個別に学習する代わりに、狭い中間次元を持つ二つの行列で変化を構成します。rを小さくすれば学習対象は減りますが、表現できる変化も制限されます。重要度の低い単語や文書を選んで捨てる処理ではありません。
元の重み行列がd行k列なら、要素数はd×kです。Aはr行k列、Bはd行r列なので、学習対象はr×k + d×r個となります。適用する層や重みの種類を増やせば、全体の学習量も増えます。rだけではモデル全体の学習コストを判断できません。
3. オンラインショップの案内と行列サイズの例
架空のオンラインショップが、担当者の作成した案内例を集めたとします。「交換はどのように申し込めますか」という質問と、必要な手順を順番に示す回答を組にして学習します。ベースモデルの重みは固定し、学習例とモデル出力の差を小さくする方向へLoRAの行列を調整します。
商品説明用の例が別にあれば、同じベースモデルに対応する別の補正値を学習して保存できます。利用時には業務に合うアダプターを選択します。ここでいうアダプターは、学習した補正パラメータのまとまりです。二つ用意しても能力が自動的に統合されるわけではなく、異なるベースモデルへそのまま適用できるとも限りません。
仕組みを理解するため、一つの重み行列が4,096行4,096列であると仮定します。全要素を更新する場合の学習対象は16,777,216個です。r=8のLoRAでは、8×4,096のAと4,096×8のBを学習するため、合計65,536個となります。
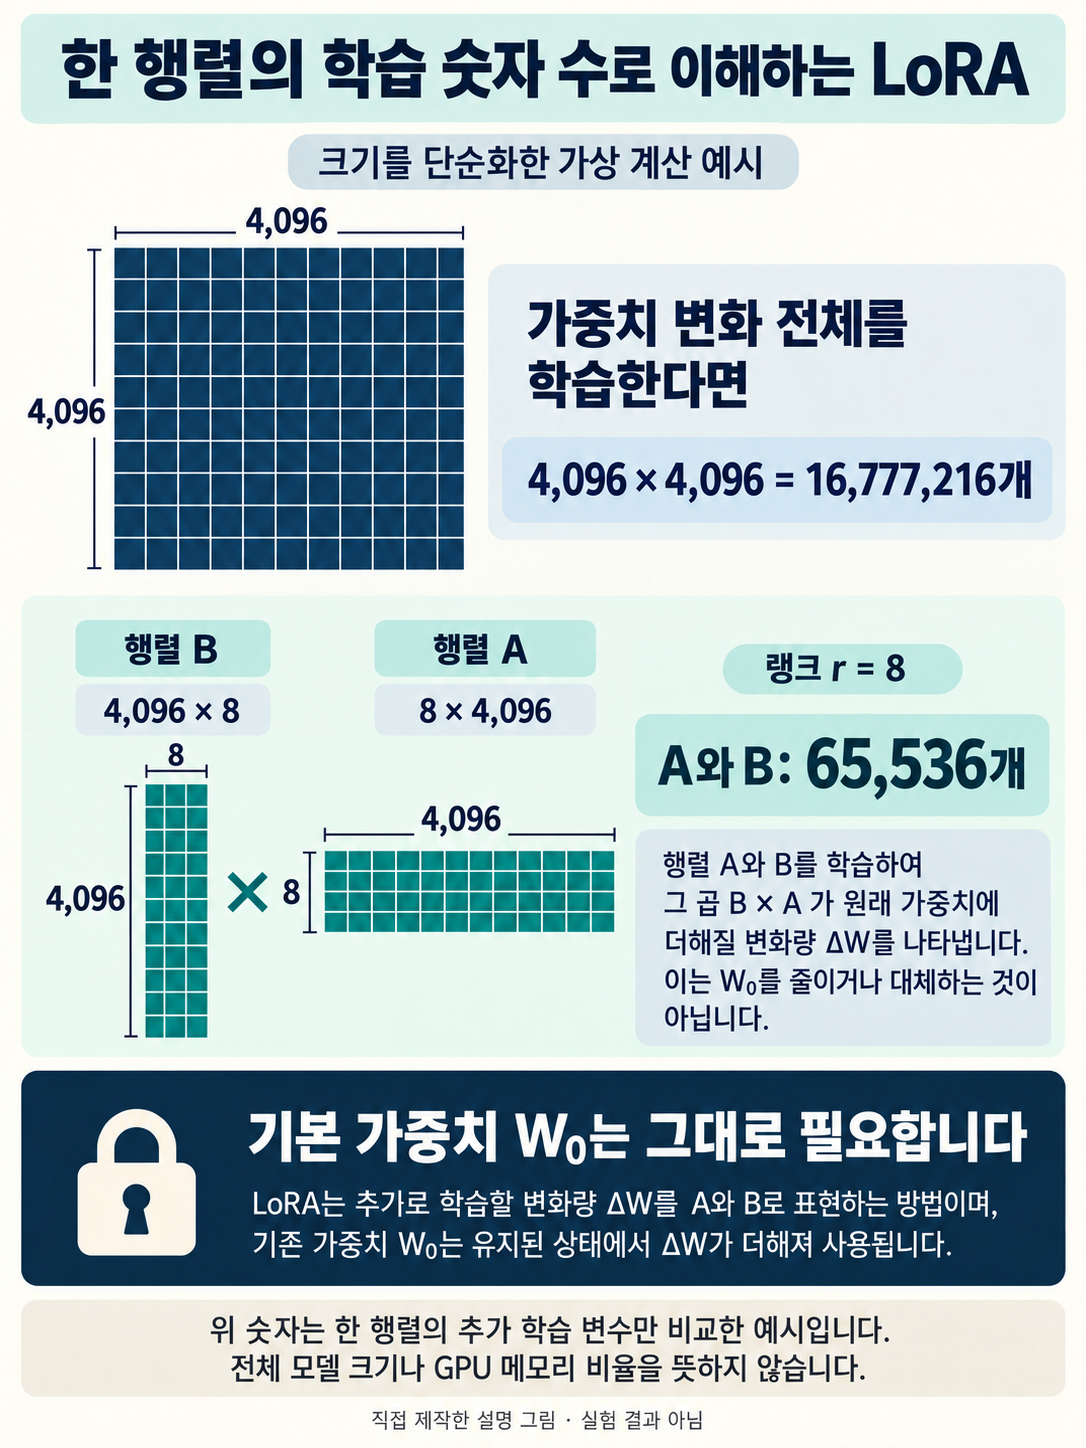
この差から、業務ごとに保存する補正値を小さくできる理由が分かります。ただし実際の顧客案内には、文体だけでなく最新の交換条件や注文情報も必要です。学習例の事実に誤りがあれば、学習にも影響します。LoRAによる適応と、正確で新しい業務情報の提供は、併せて設計する必要があります。
4. 原論文の実験値をどう読むか
arXiv v2の表3は、E2E NLG ChallengeにおけるGPT-2 Mediumの結果を比較しています。飲食店の属性と値を入力し、紹介文を生成するデータ・トゥ・テキストの課題です。以下の表は、その比較から二つの行だけを抜き出したものです。
| 手法 | 学習対象パラメータ | BLEU |
|---|---|---|
| 全パラメータのファインチューニング | 354.92M | 68.2 |
| LoRA | 0.35M | 70.4 ± 0.1 |
Mは百万を意味し、パラメータ数はモデル全体ではなく学習対象の数です。BLEUは、生成文と参照文の表現の重なりを評価する指標であり、顧客案内が正しい確率や事実の正確性を示す百分率ではありません。この実験では、LoRAは学習対象を大幅に減らしつつ、比較対象より高いBLEU値を報告しています。
LoRAは、アテンションのクエリおよびバリューの射影重みに、それぞれr=4を適用しています。付録D.3と表11によれば、学習データ全体を5回通す5エポックで学習し、生成時のビーム幅は10です。三つの乱数シードについて、各実行で最良だったエポックの結果を選び、平均しています。±0.1は表に示された信頼区間の表記で、全パラメータ調整の値は先行研究から引用した比較基準です。
したがって、あらゆる企業の問い合わせ回答が改善するという約束として読むことはできません。飲食店の紹介文とオンラインショップの案内では、入力も目的も異なります。実際の業務に合わせた評価データで、情報の欠落、事実誤認、文章形式を併せて確認することが大切です。
5. 学習コストと推論コストを分ける
LoRAは学習する変数を減らしますが、ベースモデルの読み込みや入力の計算に必要な資源まではなくしません。学習時のメモリ使用量は、モデルの大きさ、入力長、バッチサイズ、数値精度にも左右されます。アダプターファイルが小さいだけで、一定容量のGPUで必ず学習できるとは判断できません。
学習後は、二つの行列の積をスケーリングした補正値を元の重みに加えてマージできます。マージ後の重みで計算すれば、補正経路を別に実行する必要はありません。これはデプロイ時の選択肢であり、分離したアダプターを切り替えて使う構成も可能です。マージしないすべてのサービスで追加の遅延がゼロになる、と一般化するのは不適切です。
Hugging Face PEFTの公式文書も、LoRAの設定とマージを説明しています。ただしmerge_and_unloadで通常のモデルにすると、その結果ではアダプターの無効化や切り替えなどのPEFT固有機能をそのまま利用できません。業務ごとの小さなファイルを管理する便利さと、マージ済みモデルを実行する便利さを踏まえて運用を決めます。
rを大きくしても、結果が必ず良くなるわけではありません。学習データや適用位置が適切でなければ、コストが増えても期待する品質を得られない場合があります。同じ業務用評価データで設定を比較すれば、何を変えて改善したのかを説明しやすくなります。
6. 開発と特許相談に向けた技術的な違いの整理
開発チームは、ベースモデルとバージョン、学習データの構成、LoRAを適用した位置とr、デプロイ時のマージの有無を記録しておくとよいでしょう。どのベースモデルで作成したアダプターかを結び付けて管理すれば、不適切な組合せを減らせます。品質比較には評価データと生成設定の記録も役立ちます。
以下は論文の実験結果ではなく、技術相談を準備するための独立した特許実務上の観点です。自社開発を「LoRAでコストを減らした」という結果だけで説明するのではなく、どの入力から補正値を選ぶのか、業務別データをどう構成するのか、アダプターとベースモデルの組合せをどう管理するのかを、処理の順序に沿って整理します。
例えば、業務の切り替え時に誤ったアダプターが接続される問題を解決したなら、識別に使う情報、選択・適用のタイミング、誤接続を防ぐ流れが説明の中心です。これは新たな登録特許の存在を示すものでも、特許取得を保証するものでもありません。既知のLoRA構造と追加した具体的な処理を分けることで、違いを議論しやすくなります。
関連するPagedAttentionは推論中のKVキャッシュの保存を、FlashAttention-2はアテンション計算の作業配分を扱います。LoRAが焦点を当てるのは、モデルを業務に適応させる際の学習対象です。負担が学習側にあるのか推論側にあるのかを先に分けると、各技術を検討する目的が明確になります。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
AI開発における具体的な技術の違いをIPLEXと整理しませんか。AI分野のプロジェクト、関連書籍、相談案内をご覧ください。
LoRA論文:Low-Rank Adaptation of Large Language Models
Hugging Face PEFT:統合モデルの保存と機能の違い
PagedAttention入門:vLLMのKVキャッシュとGPUメモリー管理
FlashAttention-2を読む:長い文脈のアテンションをGPUで効率化する仕組み