
長い入力ではメモリ転送もボトルネックになる
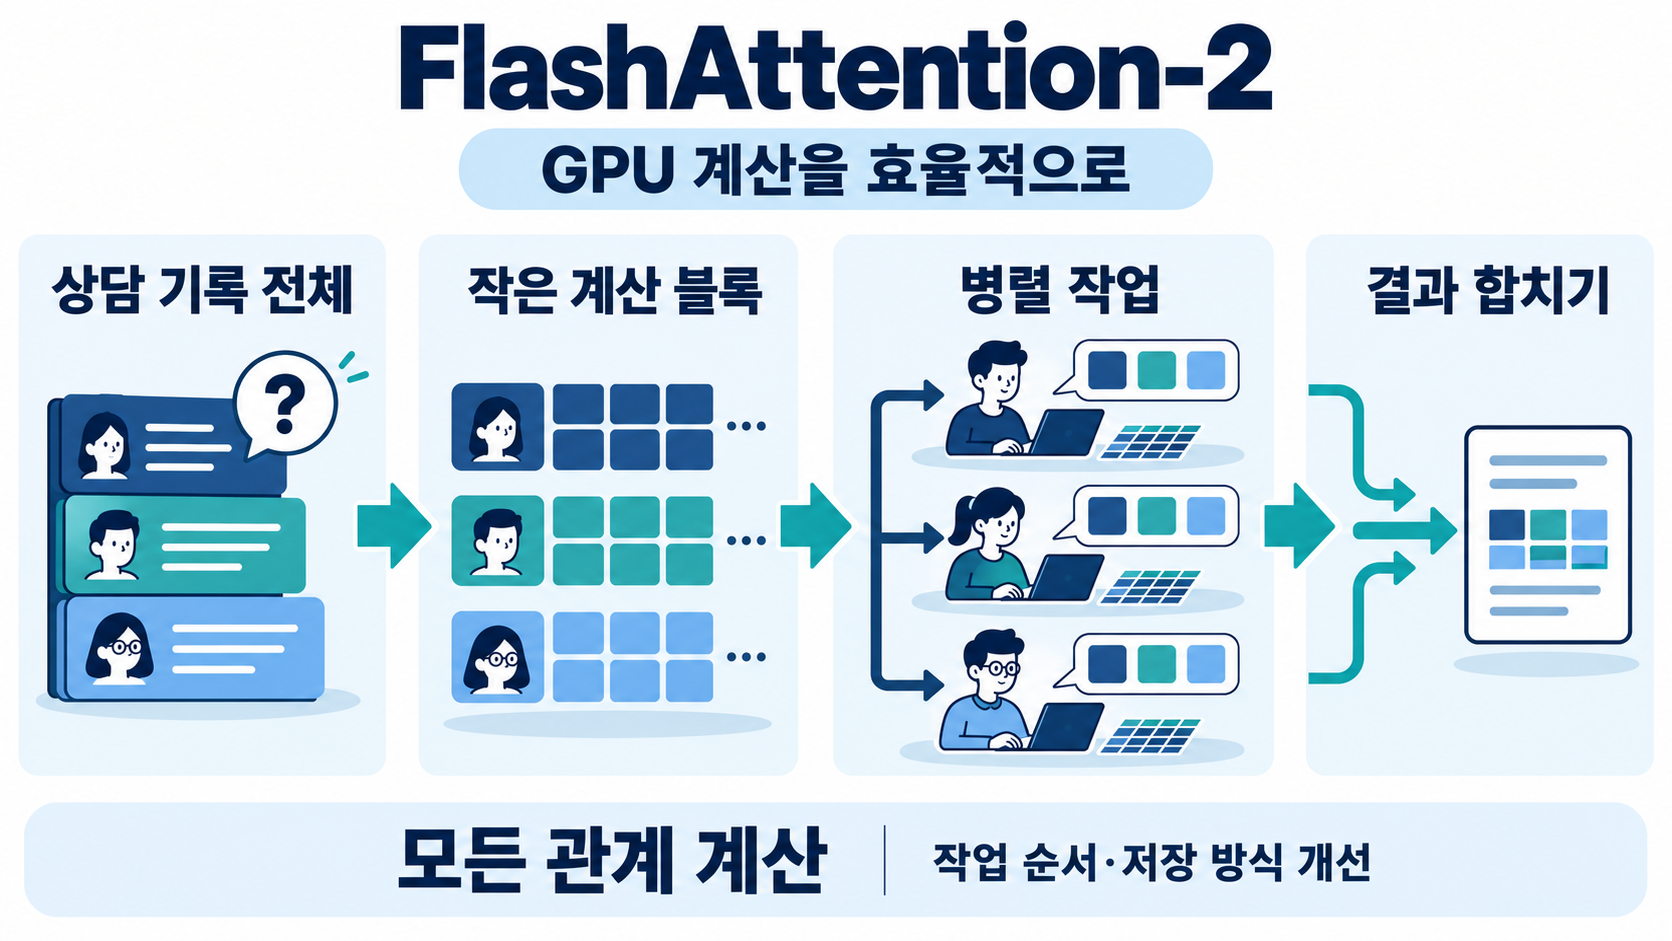
2023年7月17日にarXivへ初投稿されたTri DaoのFlashAttention-2は、アテンションをGPU上でどう実行するかを扱う研究です。トークンはテキストを処理する単位であり、アテンションはその表現を比較して情報の重みを計算します。従来の実装では大きなスコア行列や確率行列をメモリに展開するため、系列が長くなると保存容量と転送の負担が増えます。
例えば、長い顧客対応履歴から「発送済み注文の配送先を変更できるか」を判断する架空の場面を考えます。これは計算を理解するための例で、論文の実験や実サービスの成果ではありません。GPUの演算能力が高くても、必要なデータの到着を待つ時間が長ければ十分に活用できません。
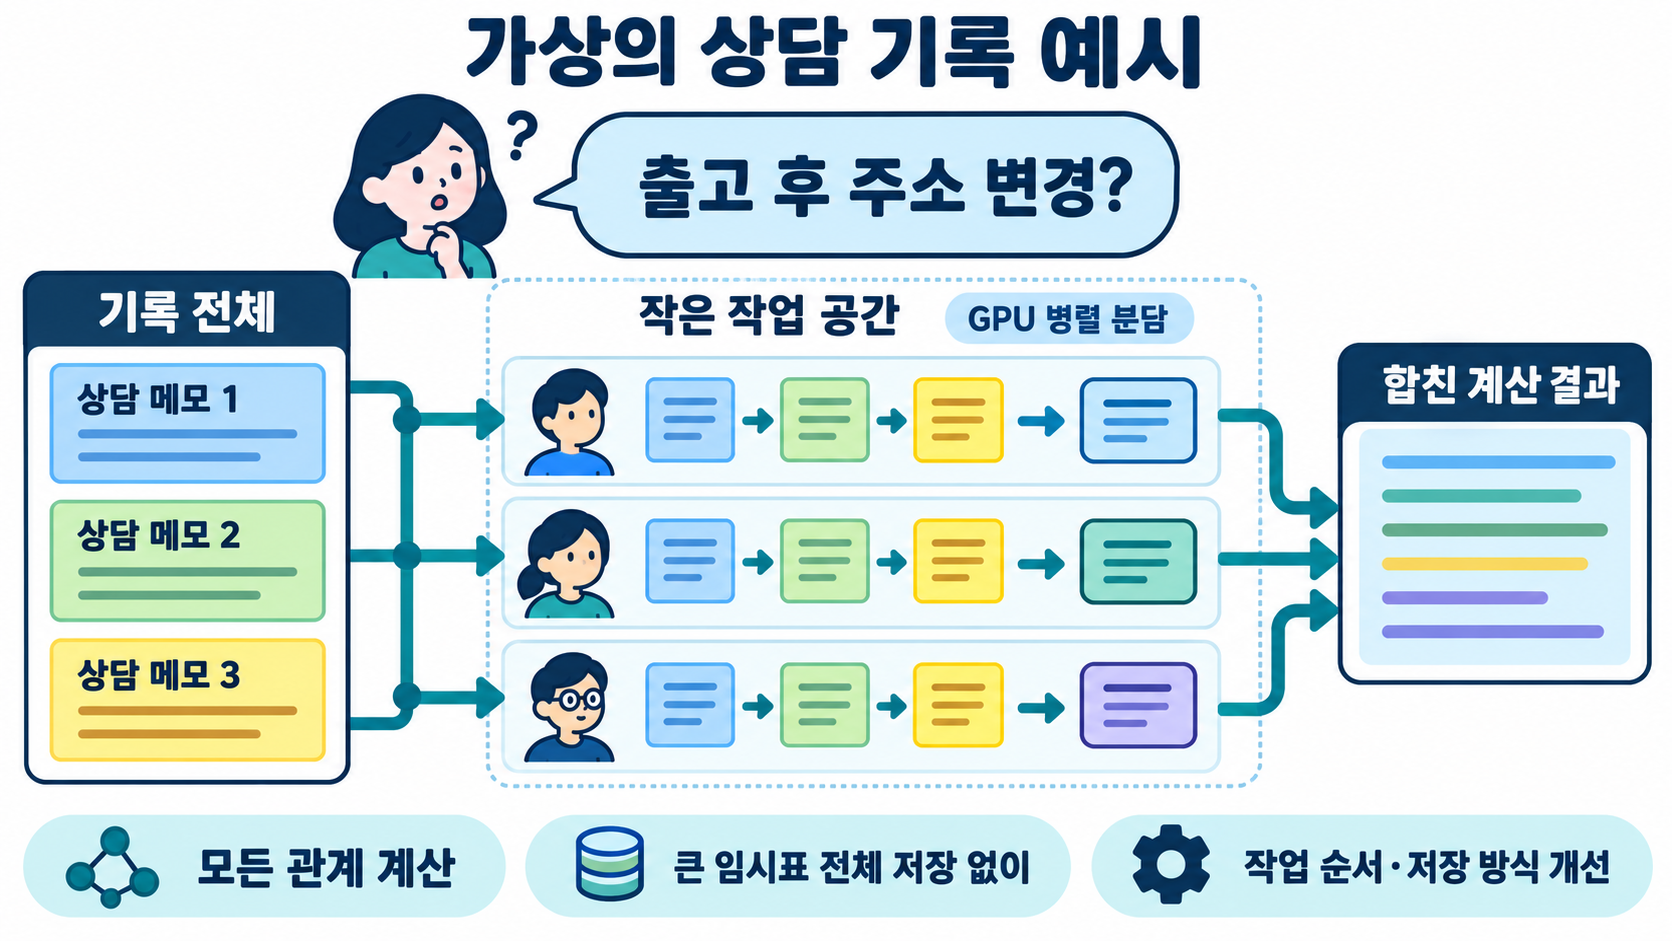
タイル分割でも全体の正規化を保つ
入力を小さなブロックに分け、高速なオンチップメモリで処理し、巨大な中間行列をHBMに保存しない仕組みは、初代FlashAttentionから受け継いでいます。オンラインsoftmaxでは、統計量と途中の出力を更新・再スケーリングし、系列全体で正規化した結果を得ます。各ブロックを独立に正規化して足すだけでは、同じ計算になりません。
顧客対応の例なら、小さな作業台でメモの束を処理し、途中の要約を更新するイメージです。実際のモデルは図中の人間の判断ではなく、数値化されたトークンを演算します。疎な近似に置き換える手法ではありませんが、浮動小数点の演算順序による微小な差は生じ得ます。出力と勾配は許容誤差内で比較するもので、ビット単位の一致を保証する意味ではありません。
GPUの稼働率を高める三つの工夫
第一に、再スケーリングや境界・因果マスクの処理など、行列積以外の演算を減らし、GPUの高速な行列演算器を生かします。第二に、バッチとヘッドだけでなく系列方向にも処理を分割します。長い入力のためバッチサイズが小さくても、より多くの演算ユニットに仕事を割り当てられます。
第三に、順伝播ではクエリーQをワープごとに分け、キーKと値Vを共有します。各ワープが出力の担当部分を計算するため、共有メモリを介した中間結果の交換や集約を減らせます。数式だけでなく、データ移動と仕事の分担を見直すことが改善の中心です。
約2倍という数値の対象を確認する
著者はA100 80GB SXM4上のアテンションカーネルで、初代FlashAttentionに対して約2倍の高速化を報告しています。系列長512から約16k、ヘッド次元64・128、因果マスクの有無を比較し、バッチ全体のトークン数を16kにそろえた実験です。ここで測っているのはアテンション部分です。
一方、A100 80GB SXM4を8基使ったGPTの学習実験では、全体の学習速度は最大約1.3倍でした。13億・27億パラメータのモデルと、約2k・8kの文脈長を比較しています。他の演算や通信は残るため、別のGPUやチャットサービスでも応答が2倍速くなるとはいえません。計算量は依然として系列長の二乗に比例し、省メモリ化だけで読解精度が上がるわけでもありません。
実装上の差を検証可能な形で残す
同じモデルと入力で、GPU、系列長、バッチサイズ、メモリ使用量、処理時間を記録します。長いプロンプトを最初に読み込むprefillと、一トークンずつ生成するdecodeも分けて測定します。両者ではボトルネックが異なる可能性があります。本記事の原図は、その仕組みを説明する概念図です。
技術資料では、保存しなくなった中間行列、処理を分割する位置、中間値の通信削減を、フロー図と条件をそろえた比較実験で示すと有用です。アイピレックスはAI発明の具体的な構成と効果を検討します。ベンチマークが速いことだけで、特許性が認められるわけではありません。