
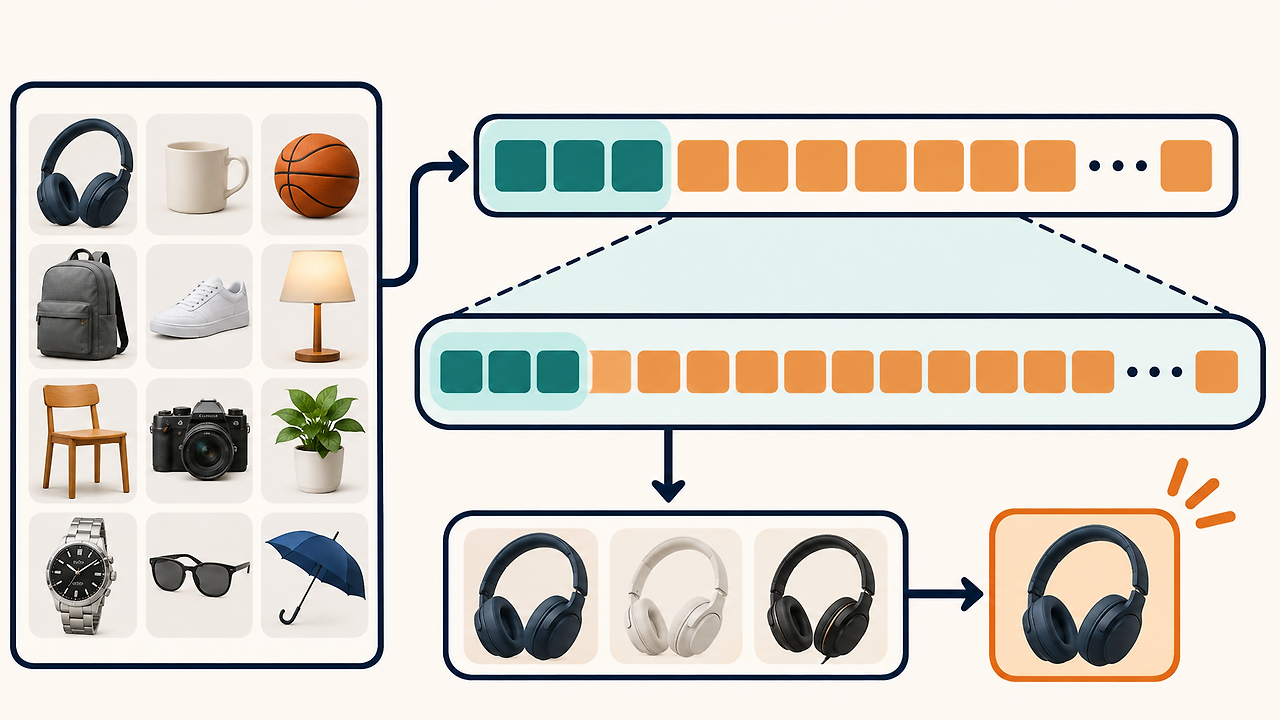
商品写真を最初からすべて詳しく比較すると、計算量が増えます。Matryoshka Representation Learningは、画像の埋め込みベクトルの短い先頭部分でも検索に使えるよう、複数の長さを同時に学習します。架空の商品一覧とImageNet-1Kの実験を通じ、短いベクトルで候補を絞り、全体で順位を付け直す方法を見ていきます。
1. 画像検索には何個の数値が必要か
青い取っ手付きカップの写真を受け取り、ファイル名には撮影日しかないとします。数千枚の商品写真から探すには内容を比較する必要がありますが、最初からすべての取っ手、縁、模様を細かく比べる必要があるでしょうか。
画像モデルが写真から作る数値列を埋め込み、その要素数を次元数と呼びます。ベクトル間の距離を比較すれば近い画像を候補にできます。この処理を多数の写真で繰り返すため、次元数も検索コストに影響します。
KusupatiらがNeurIPS 2022で発表したMatryoshka Representation Learningは、同じ埋め込みの先頭をどの長さで使うかに着目します。短い表現で広く候補を探し、詳しく区別したい候補には長い表現を使います。
2. 一つの出力に複数の長さを学習させる
画像実験では、モデルの出力を2,048要素とし、先頭8、16、32次元などを指定します。16次元と32次元は別々に生成した出力ではなく、一つの出力の同じ先頭部分を切り出したものです。
学習では指定した長さごとに画像のクラスを予測し、正解との誤差を求めます。その損失を合わせて共通のモデルを更新するため、短い先頭部分の予測も学習に寄与します。学習後に単に切り詰めるだけの方法とは異なります。
画像分類では長さごとの分類器を使いますが、検索では学習済みの表現間の距離を比較します。16次元で検索するなら、問い合わせ画像と検索対象画像の両方から先頭16要素を取り出します。
3. 商品候補を絞ってから再比較する
架空の商品一覧にボトル、マグカップ、紙コップ、取っ手のないカップが混在しているとします。アップロードした青いカップをベクトル化し、同じモデルで事前に計算した商品ベクトルの短い先頭部分と比較して候補を残します。
次の段階では、残った候補について同じベクトルの長い部分を使い、距離を再計算します。二つの青いカップが、細かな違いを反映して順位を入れ替えるかもしれません。ただし、特定の次元が特定の色や部品を表すと仮定する例ではありません。
最初の段階は対象を減らし、次の段階はその順位を精密化します。必要なカップが最初の候補から漏れると、再順位付けで復活することはありません。候補数は検索品質と計算量を併せて判断する必要があります。
4. ImageNet-1Kで報告された結果
研究ではResNet50の表現を使い、ImageNet-1Kから問い合わせと同じクラスの画像を検索しました。先頭16次元で200件を選び、全2,048次元で並べ直す条件を評価しています。公式補足資料の表8と表11には、距離に基づく厳密検索の結果が掲載されています。
同じMRL表現を使った全2,048次元の一段階検索はmAP@10が65.20%、16次元で候補を選び全体で再順位付けした場合は65.27%でした。mAP@10は上位10件で関連画像がどのように順位付けされたかを複数の問い合わせで集計する指標です。この条件では両者の品質が近いことを示します。
対応する検索計算量は、問い合わせ当たり2,624 MFLOPsと21 MFLOPsです。MFLOPsは浮動小数点演算を百万回単位で表します。利用者が感じる応答時間には埋め込みの生成や保存先へのアクセスも含まれるため、別に測る必要があります。
5. 次元数と候補数の選び方
短い先頭部分を使うほど画像ごとの比較要素は減りますが、よく似た画像が多い場合には必要な候補を落とす可能性があります。より難しいImageNet-4Kの比較では、最初の検索に64次元を使う条件も示されています。16次元・200件は一つの実験設定です。
何を関連画像とみなすかも用途によって変わります。商品分類なら色違いの同型カップが役立つ一方、SKUの特定では似た別商品を区別する必要があります。関連性を先に定義して比較すると、どの段階で品質が落ちたかを把握しやすくなります。
再順位付けには、候補の長いベクトルを読み出せることが必要です。短いベクトルの索引をどこまで小さくするかと、全体をどこに保存するかは別の設計項目です。演算量、読み出し時間、保存容量を分けて記録します。
6. 技術検討に使える比較記録
同じ商品一覧で、全体ベクトルによる検索と先頭部分での候補選択を比較します。まず必要な候補が残ったか、次に再順位付け後の位置を記録すれば、初段の取りこぼしと後段の順位問題を区別できます。
照明が異なる写真、部分的な切り抜き、別角度の撮影も比較対象になります。鮮明な写真の結果だけでは実利用を代表できません。平均時間に加え、遅い要求が生じた条件を見ることで、候補数や読み出し方式の調整に役立ちます。
特許検討用には、学習で評価した長さ、候補の選択方法、二段目で再利用する情報を一連の処理として整理します。同じ一覧で条件を変えた結果があれば、表現学習と検索設計それぞれの効果を説明しやすくなります。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
商品一覧は架空の例です。精度と演算量の数値は論文の実験条件に限られ、実サービスの性能を保証しません。
Googleの文書理解特許:見出し・本文・画像の配置を併せて読み取る仕組み
Lost in the Middleを読む:根拠文書を置く位置で回答は変わるか
埋め込みモデルと検索処理を整理する際は、IPLEXのAIプロジェクトと相談準備資料をご覧ください。