
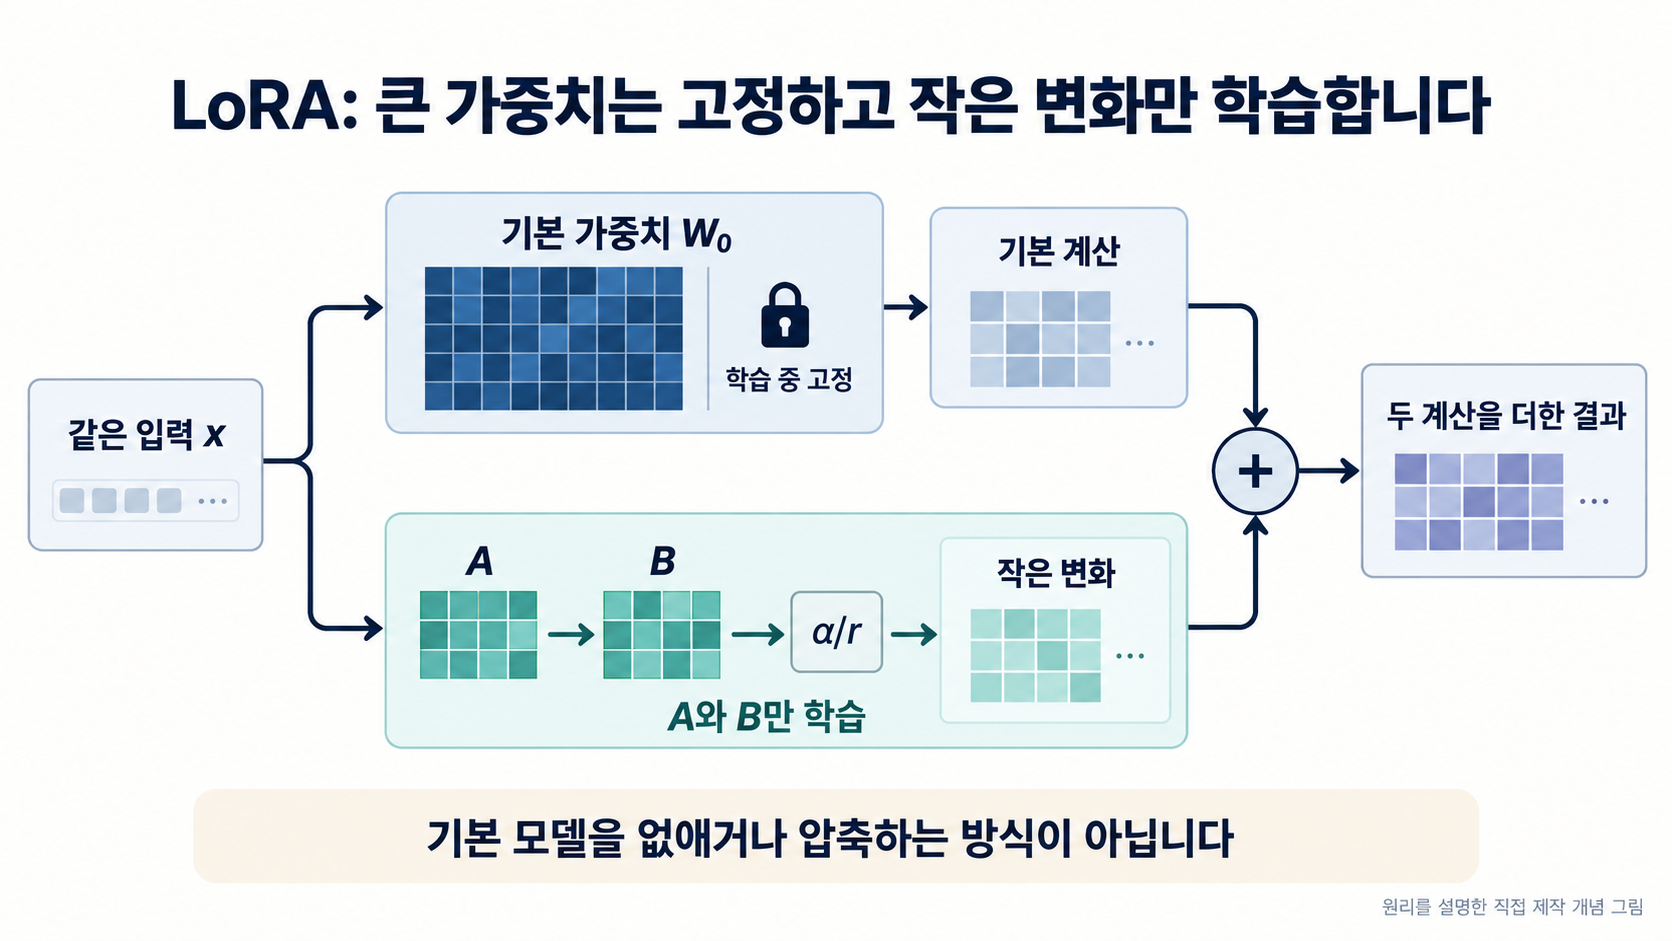
LoRA保留并冻结已经训练好的AI模型权重,只学习由两个小矩阵表示的变化量。其目的,是减轻企业为不同业务调整和保存整套模型的负担。下面通过一个假设的网店客服场景和原论文实验,说明哪些部分变小了,哪些资源仍然不可缺少。
本文分析Edward J. Hu、Yelong Shen等研究者的《LoRA: Low-Rank Adaptation of Large Language Models》,以arXiv v2为依据。该论文于2021年6月17日首次公开,v2修订日期为2021年10月16日。
1. 为不同业务调整模型,负担从何而来
同一个语言模型用于客户咨询和商品介绍时,输出要求并不相同。客服可能需要按顺序清楚解释办理步骤,商品介绍则需要以统一格式呈现特点。利用这些业务示例继续训练,就是微调。问题在于,每次适配都必须更新模型中的全部权重吗?
权重是模型内部影响信息如何进入下一步计算的数值。全量微调将原有权重广泛纳入训练范围。对于大模型,除了待更新的数值,还需要管理梯度和优化器状态;如果为每项业务分别保存完整模型,存储负担也会增加。
LoRA的出发点是保留预训练模型,把适应新业务所需的变化用更少的可训练数值表示。它并非删除原模型,也不是换成一个更小的模型,而是在既有计算旁增加一条小规模的可训练补偿路径。
2. 保留原计算,只训练权重的变化量
可以把模型中的一次计算看成一个由数值组成的矩阵。设原权重矩阵为W₀,LoRA用两个小矩阵A和B的乘积表示需要加入的变化量。同一个输入分别经过W₀和A→B两条路径,再将两路输出相加。
关键是冻结W₀,只训练A和B。论文将计算写成W₀x + BAx,并用α/r对补偿量进行缩放。x表示输入,r是两个小矩阵之间的中间维度。冻结并不意味着停止原路径的计算,而是继续使用这些权重,同时不通过训练更新其数值。
低秩限制的是表示变化量所能使用的独立方向数量。与逐个训练大矩阵的所有元素不同,两张小矩阵通过较窄的中间维度构成更新。r越小,可训练数值越少,但能够表达的变化也受到约束。这不是挑出不重要的词语或文档并将其丢弃的方法。
如果原权重矩阵为d行k列,它有d×k个元素。A的形状为r×k,B为d×r,两者共有r×k + d×r个可训练元素。增加适用的层数或权重类型,整体训练量也会增加,因此不能仅凭r判断整个模型的训练成本。
3. 网店客服示例与小矩阵的参数数量
假设一家网店整理了客服人员编写的答复示例,将“怎样申请换货?”与按步骤说明办理流程的回答配对用于训练。基础模型的权重保持不变,LoRA的小矩阵则朝着缩小模型输出与训练示例之间差异的方向调整。
若另有商品介绍的训练示例,也可以为同一个基础模型学习并保存另一组补偿参数。使用时选择对应业务的适配器即可。这里的适配器,是指训练得到的补偿参数集合。建立两个适配器不会自动融合两种能力,也不意味着它们能直接用于不同的基础模型。
以一个假设计算说明数量差异:一张4,096行、4,096列的权重矩阵共有16,777,216个元素,若全部更新,这些元素都属于训练对象。采用r=8的LoRA时,A为8×4,096,B为4,096×8,合计65,536个可训练元素。
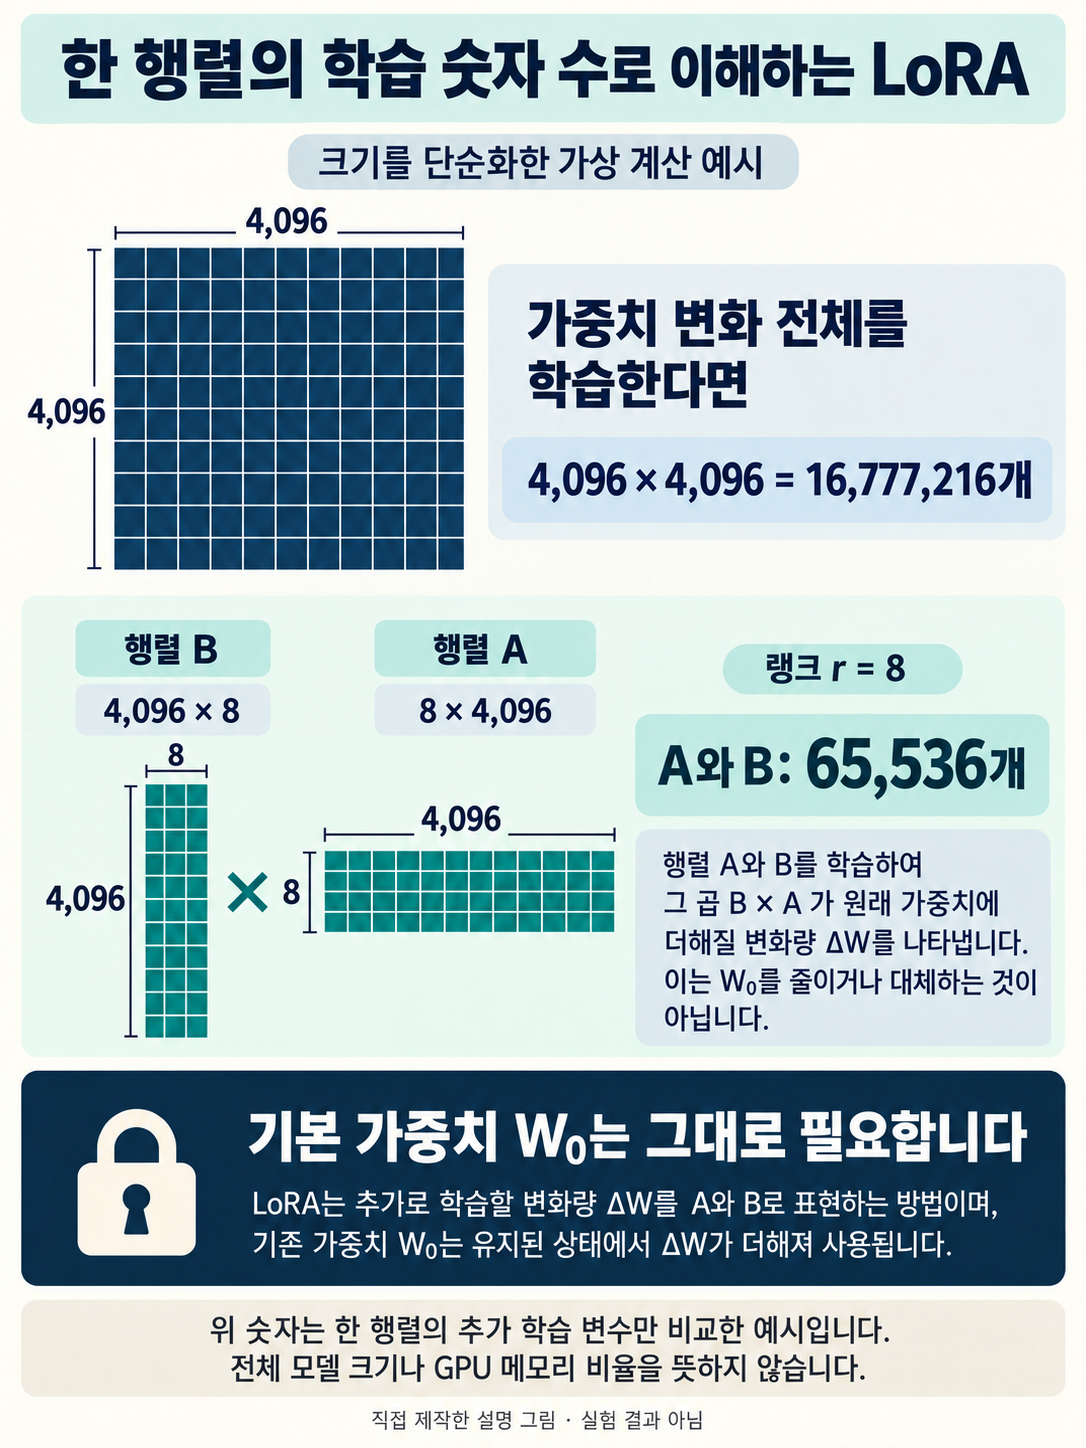
这说明了业务专属补偿参数为何可以较小。不过,实际客服除了合适的表达方式,还需要最新的换货政策和订单信息。示例中的事实有误,也会影响训练。模型适配与准确、及时地提供业务信息,需要一起设计。
4. 如何理解原论文的实验数字
arXiv v2表3比较了GPT-2 Medium在E2E NLG Challenge上的表现。该任务根据给定的餐厅属性及其取值生成介绍文字,属于从结构化数据生成文本。下表仅摘录同一比较中的两行。
| 方法 | 可训练参数 | BLEU |
|---|---|---|
| 全量微调 | 354.92M | 68.2 |
| LoRA | 0.35M | 70.4 ± 0.1 |
M表示百万,表中统计的是可训练参数,而非整个模型的参数总量。BLEU衡量生成文本与参考文本在表达上的重合程度,不是客服回答正确的概率,也不是事实准确率的百分比。在这一实验中,LoRA显著减少了训练对象,同时报告了高于所选基准的BLEU分数。
LoRA对注意力中的查询和值投影权重分别采用r=4。附录D.3及表11说明,训练遍历完整数据集5次,即5个epoch,生成时的束搜索宽度为10。作者使用三个随机种子,分别选取各次运行中最佳epoch的结果,再计算平均值。±0.1是表中报告的置信区间表示;全量微调一行则引用了先前研究的基准结果。
因此,不能将这些数字理解为所有企业的客服回答都会改善。餐厅介绍与网店咨询的输入和目标不同,需要用目标业务的独立评估数据,同时考察信息遗漏、事实错误和输出格式。
5. 训练成本与推理成本需要分别考虑
LoRA减少了参与训练的变量,却不会消除加载基础模型和处理输入所需的资源。训练内存还受到模型规模、输入长度、批量大小和数值精度影响。仅凭适配器文件很小,不能断言它一定能在某种显存容量的GPU上完成训练。
训练完成后,可以将两个矩阵的乘积按比例缩放后加到原权重中,形成合并后的权重。使用合并权重推理时,无须单独执行补偿路径。合并是部署选项,也可以保留独立适配器并按需切换。不能一概声称所有未合并的服务都不会产生额外延迟。
Hugging Face PEFT官方文档介绍了LoRA配置和权重合并。但使用merge_and_unload得到普通模型后,结果模型不再保留禁用或切换适配器等PEFT专用功能。需要权衡管理多个业务小文件的便利性与运行合并模型的便利性,确定实际部署方式。
r更大也不一定带来更好的结果。如果训练数据或应用位置不合适,增加成本未必能够获得预期质量。使用同一套业务评估数据比较设置,有助于说明究竟是哪项调整带来了改善。
6. 开发记录与专利实务中的技术差异
开发团队宜记录基础模型及版本、训练数据的组成、LoRA的应用位置和r,以及部署时是否合并权重。把适配器与训练时所用的基础模型关联管理,有助于减少错误组合。比较质量时,也应保留评估数据和生成设置。
以下是为技术咨询做准备的独立专利实务视角,并非论文实验的结论。说明自主开发内容时,不宜只写“通过LoRA降低成本”,而应按处理顺序讲清楚:依据哪些输入选择补偿参数,如何组织业务训练数据,以及如何管理适配器与基础模型的对应关系。
例如,若开发解决了业务切换时误接适配器的问题,技术说明的重点就是用于识别的信息、选择和应用的时点,以及防止错误的处理流程。这不代表出现了一项新的授权专利,也不保证能够获得授权。将已知的LoRA结构与团队增加的具体处理分开,有助于讨论真正的技术差异。
延伸阅读中的PagedAttention处理推理期间KV缓存的存储问题,FlashAttention-2处理注意力计算的任务分配问题,LoRA则关注适配模型时哪些参数参与训练。先分清业务瓶颈在训练还是推理,有助于明确采用每项技术的目的。
图中保留原始标注与形态,相关内容在正文中说明。
IPLEX协助梳理AI开发中的具体技术差异。欢迎了解我们的AI项目、相关著作和咨询服务。
LoRA论文:Low-Rank Adaptation of Large Language Models
Hugging Face PEFT:合并模型的保存及功能差异
读懂PagedAttention:vLLM的KV缓存与GPU显存管理
读懂FlashAttention-2:让长上下文注意力更高效地运行在GPU上