
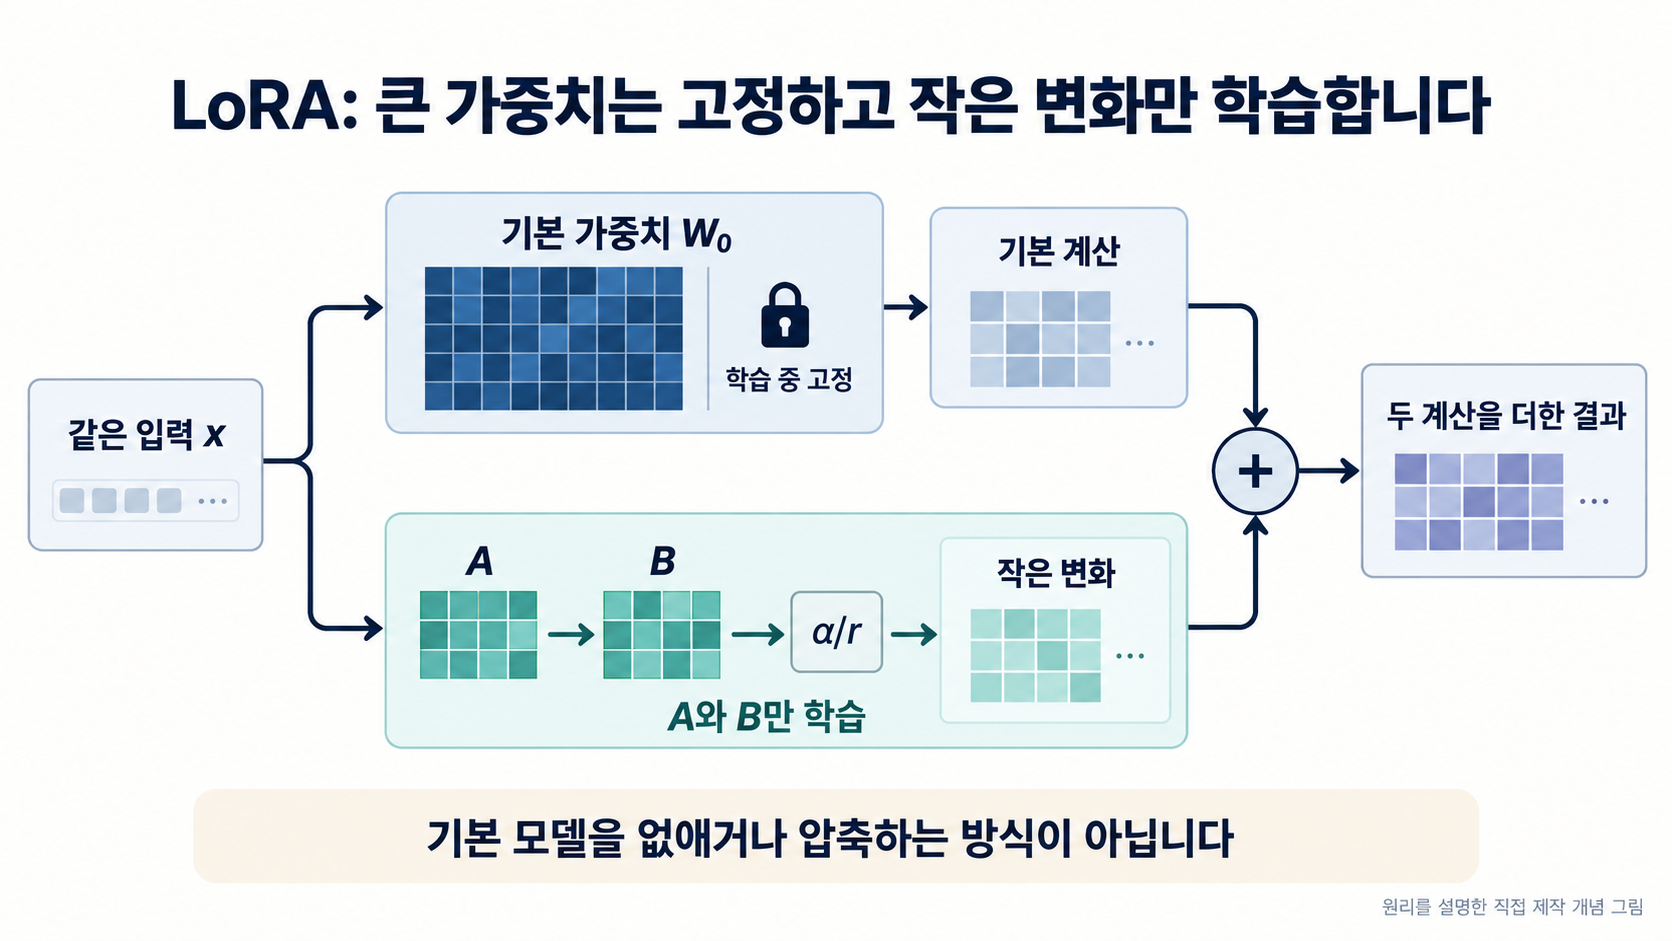
LoRA оставляет веса предварительно обученной модели ИИ неизменными и обучает только поправку, представленную двумя небольшими матрицами. Подход призван уменьшить затраты на адаптацию и хранение отдельных вариантов модели для разных задач бизнеса. На условном примере интернет-магазина и на данных исходной статьи рассмотрим, что именно уменьшается, а что по-прежнему необходимо.
В основе разбора — статья Edward J. Hu, Yelong Shen и соавторов «LoRA: Low-Rank Adaptation of Large Language Models», версия arXiv v2. Первая версия опубликована 17 июня 2021 года, рассматриваемая редакция — 16 октября 2021 года.
1. Откуда возникает нагрузка при адаптации модели к разным задачам
Даже одной и той же языковой модели нужны разные образцы для ответов клиентам и описаний товаров. В ответе службы поддержки важно спокойно и последовательно изложить порядок действий, а в описании товара — представить характеристики в заданном формате. Обучение на таких примерах называют дообучением, или fine-tuning. Обязательно ли при этом каждый раз обновлять все веса?
Веса — числовые параметры модели, влияющие на передачу информации к следующему вычислению. При полном дообучении обучаемыми становятся исходные веса по всей модели. Для крупной модели приходится хранить не только обновляемые значения, но и градиенты, и состояния оптимизатора. Отдельные полные копии для каждой задачи увеличивают требования к хранилищу.
LoRA исходит из возможности использовать уже обученную модель, представив нужные для новой задачи изменения меньшим числом обучаемых значений. Исходную модель не удаляют и не заменяют уменьшенной. К существующим вычислениям добавляют небольшой путь коррекции и обучают именно его.
2. Исходное вычисление сохраняется, обучается поправка
Рассмотрим одно из вычислений модели как умножение на матрицу — прямоугольную таблицу чисел. Пусть исходная матрица весов обозначена W₀. В LoRA добавляемое изменение представляют произведением двух небольших матриц A и B. Один и тот же вход проходит через W₀ и по пути A→B, после чего результаты складываются.
Принципиально, что W₀ заморожена, а обучаются только A и B. В статье вычисление записано как W₀x + BAx; поправку дополнительно масштабируют коэффициентом α/r. Здесь x — вход, а r — промежуточная размерность, соединяющая две небольшие матрицы. Замораживание не останавливает исходное вычисление: веса продолжают использоваться, но их значения не обновляются в ходе обучения.
Низкий ранг ограничивает число независимых направлений, которыми можно выразить изменение. Вместо независимого обучения всех элементов большой матрицы поправку строят через две матрицы с узкой промежуточной размерностью. При меньшем r обучаемых значений меньше, но и возможные изменения ограничены сильнее. Это не отбор и удаление якобы малозначимых слов или документов.
Если исходная матрица имеет d строк и k столбцов, она содержит d×k элементов. Размер A равен r×k, размер B — d×r, поэтому обучаются r×k + d×r элементов. Чем больше слоёв и видов весов охвачено LoRA, тем больше общий объём обучения. Одного значения r недостаточно для оценки затрат на всю модель.
3. Пример интернет-магазина и количество параметров
Предположим, интернет-магазин собрал примеры ответов, написанных сотрудниками поддержки. Вопрос «Как оформить обмен?» сопоставляют с ответом, последовательно объясняющим нужные действия. Веса базовой модели фиксированы, а небольшие матрицы LoRA изменяются так, чтобы уменьшить расхождение между выходом модели и обучающими примерами.
Отдельные примеры описаний товаров позволяют обучить и сохранить другую поправку для той же базовой модели. При использовании выбирают адаптер, соответствующий задаче. Под адаптером здесь понимается набор обученных параметров коррекции. Два адаптера не объединяют свои возможности автоматически и не становятся от этого совместимыми с другой базовой моделью.
Для условного расчёта возьмём одну матрицу весов размером 4 096×4 096. При обновлении всех элементов обучаемых значений будет 16 777 216. В LoRA с r=8 матрица A имеет размер 8×4 096, а B — 4 096×8, что в сумме даёт 65 536 обучаемых элементов.
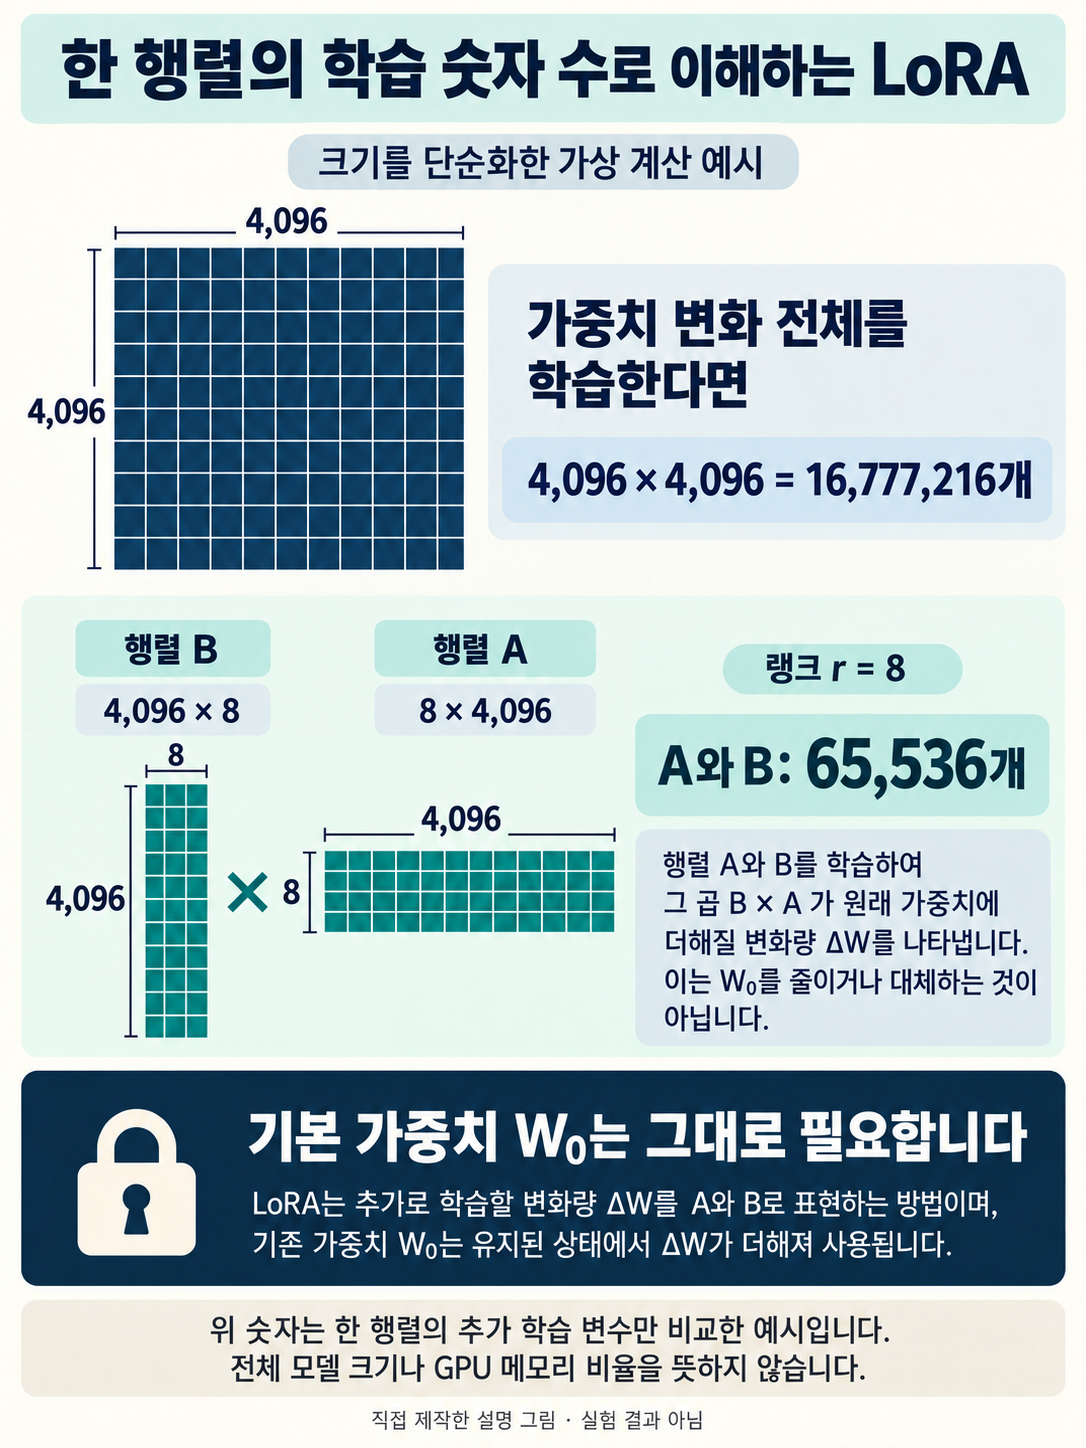
Так становится понятно, почему поправку для каждой задачи можно хранить компактно. Однако для реального ответа клиенту нужны не только подходящие формулировки, но и действующие правила обмена и сведения о заказе. Ошибки в фактах обучающих примеров влияют на обучение. Адаптацию модели и подачу достоверной актуальной информации о бизнесе следует проектировать совместно.
4. Что показывают цифры исходного эксперимента
В таблице 3 версии v2 сравнивается GPT-2 Medium на задаче E2E NLG Challenge. Модель получает характеристики ресторана и их значения, а затем составляет описание: это генерация текста по структурированным данным. Ниже приведены только две строки из исходного сравнения.
| Метод | Обучаемые параметры | BLEU |
|---|---|---|
| Полное дообучение | 354.92M | 68.2 |
| LoRA | 0.35M | 70.4 ± 0.1 |
M означает миллион, а число параметров относится к обучаемой части, не к общему размеру модели. BLEU оценивает совпадение выражений в сгенерированном и эталонном текстах. Это не вероятность правильного ответа клиенту и не процент фактической достоверности. В данном эксперименте LoRA значительно сократила число обучаемых параметров и показала более высокий BLEU, чем выбранный базовый вариант.
Для матриц проекций запросов и значений в механизме внимания использован ранг r=4. Согласно приложению D.3 и таблице 11, обучение длилось пять полных проходов по данным, то есть пять эпох, а при генерации применялся лучевой поиск шириной 10. Авторы усреднили результаты по трём начальным значениям генератора случайных чисел, выбрав лучшую эпоху каждого запуска. ±0.1 — обозначение доверительного интервала в таблице; результат полного дообучения заимствован из предыдущей работы.
Поэтому цифры не следует воспринимать как обещание улучшить ответы поддержки любой компании. Описание ресторана и консультация покупателя отличаются входными данными и целью. На отдельном наборе оценки для нужной задачи следует совместно проверять пропуски информации, фактические ошибки и формат ответа.
5. Затраты на обучение и инференс нужно разделять
LoRA уменьшает число обучаемых переменных, но не отменяет ресурсы, необходимые для загрузки базовой модели и обработки входа. Потребление памяти при обучении зависит также от размера модели, длины входа, размера пакета и численной точности. Маленький файл адаптера сам по себе не гарантирует возможность обучения на GPU с определённым объёмом памяти.
После обучения произведение двух матриц с учётом масштабирования можно добавить к исходным весам. При вычислении с объединёнными весами отдельный путь коррекции не требуется. Объединение — один из вариантов развёртывания; можно оставить адаптеры раздельными и переключать их. Нельзя обобщать, что в любой системе без объединения дополнительная задержка отсутствует.
Официальная документация Hugging Face PEFT описывает настройку LoRA и объединение весов. Но после merge_and_unload получается обычная модель без специальных возможностей PEFT, в том числе отключения или переключения адаптера. При выборе схемы эксплуатации нужно учитывать и удобство хранения небольших файлов для разных задач, и удобство исполнения объединённой модели.
Увеличение r также не всегда улучшает результат. Если данные или точки подключения матриц выбраны неудачно, рост затрат может не дать желаемого качества. Сравнение настроек на одном и том же наборе оценки для задачи помогает понять и объяснить, какое изменение привело к улучшению.
6. Как описать технические отличия для разработки и патентной консультации
Команде разработки полезно фиксировать базовую модель и её версию, состав обучающих данных, места применения LoRA и ранг r, а также факт объединения весов при развёртывании. Связь адаптера с моделью, на которой он обучен, помогает избегать несовместимых сочетаний. Для сравнения качества следует сохранять также оценочные данные и настройки генерации.
Далее приведён самостоятельный взгляд с позиции патентной практики для подготовки технической консультации, а не вывод из экспериментов статьи. Описывая собственную разработку, недостаточно ограничиться результатом «снижение затрат с помощью LoRA». Важно последовательно раскрыть, какие входные данные определяют выбор поправки, как формируются наборы для разных задач и как управляется соответствие адаптера базовой модели.
Например, если разработка предотвращает подключение неверного адаптера при смене задачи, основой технического описания будут идентифицирующая информация, момент выбора и применения, а также порядок предотвращения ошибки. Это не утверждение о наличии нового выданного патента и не гарантия получения патента. Разделение известной архитектуры LoRA и конкретной добавленной обработки помогает обсуждать действительное отличие.
Для сопоставления: PagedAttention рассматривает хранение KV-кэша во время инференса, а FlashAttention-2 — распределение работы при вычислении внимания. LoRA сосредоточена на том, какие параметры обучаются при адаптации модели. Если сначала определить, возникает ли основная нагрузка на этапе обучения или инференса, цель рассмотрения каждой технологии станет яснее.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Связанная практика: патенты в области ИИ
IPLEX поможет систематизировать конкретные технические отличия вашей разработки в области ИИ. Ознакомьтесь с нашими проектами, публикациями и возможностями консультации.
Статья LoRA: Low-Rank Adaptation of Large Language Models
Официальная документация Hugging Face PEFT
PDF статьи LoRA: раздел 4.1, таблица 3, приложение D.3 и таблица 11
Официальная реализация и эксперименты Microsoft LoRA
Hugging Face PEFT: сохранение объединённой модели и различия возможностей
PagedAttention: управление KV-кэшем и памятью GPU в vLLM
FlashAttention-2: эффективное вычисление внимания на GPU для длинного контекста