
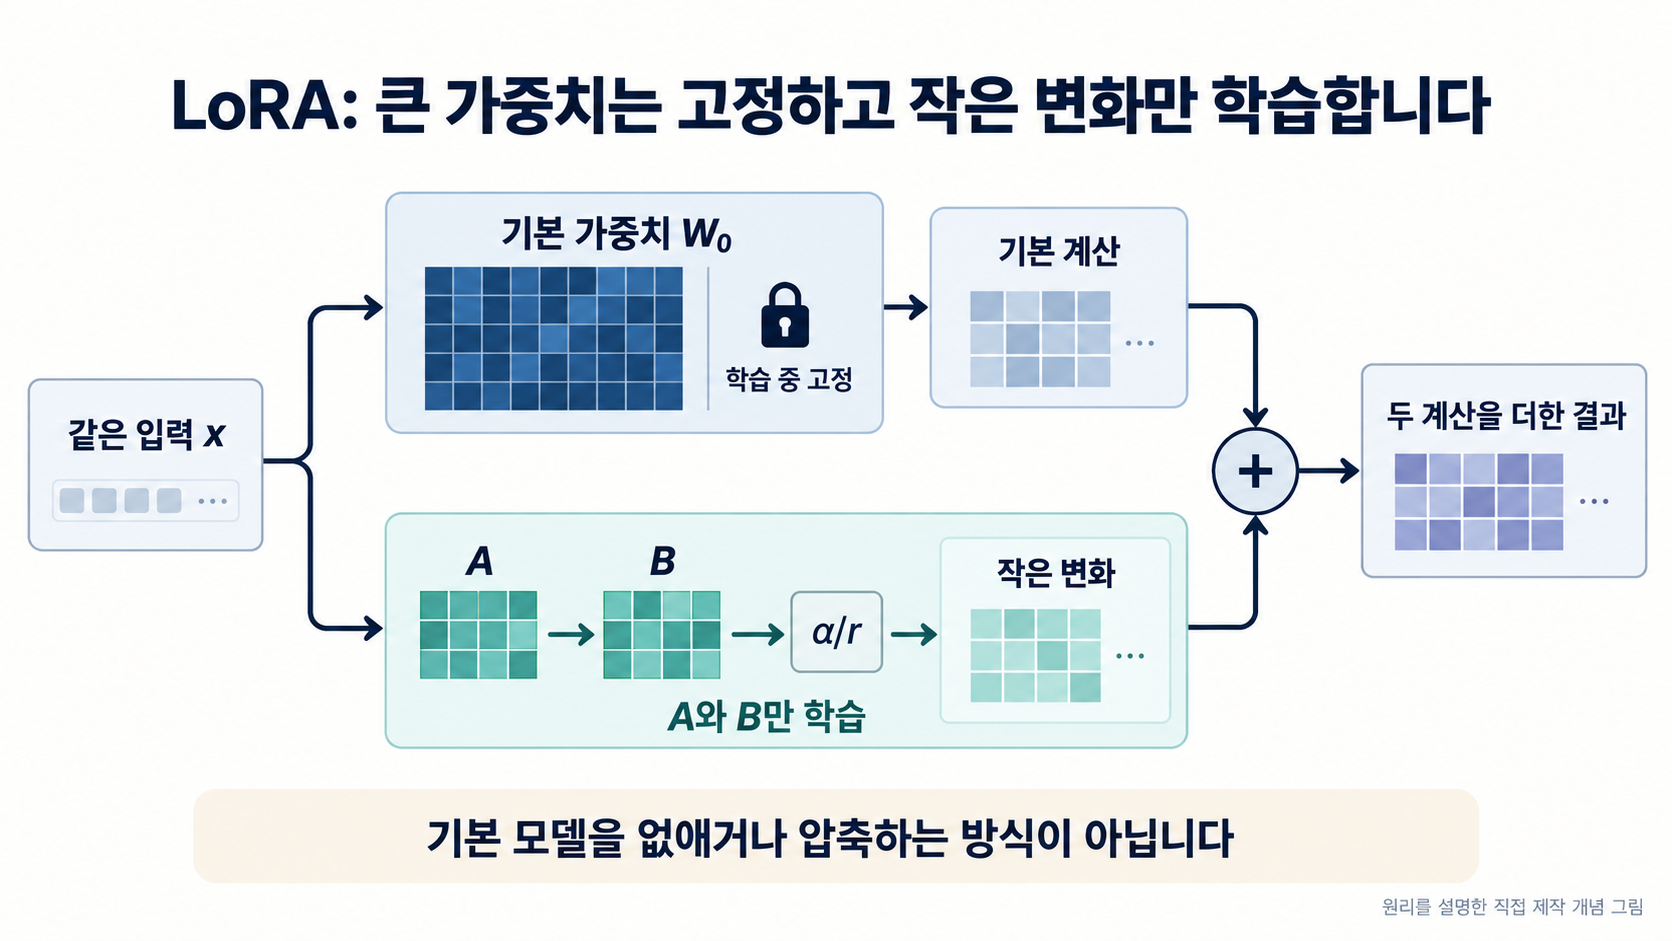
LoRA mantiene fijos los pesos de un modelo de IA preentrenado y aprende únicamente una modificación representada por dos matrices pequeñas. Su propósito es reducir la carga de ajustar y almacenar un modelo completo para cada necesidad empresarial. Un ejemplo hipotético de atención al cliente de una tienda en línea y los experimentos del artículo permiten distinguir qué se reduce y qué sigue siendo necesario.
El análisis se basa en la versión 2 de arXiv de LoRA: Low-Rank Adaptation of Large Language Models, de Edward J. Hu, Yelong Shen y sus coautores. El trabajo se publicó inicialmente el 17 de junio de 2021 y esa versión se revisó el 16 de octubre de 2021.
1. Por qué adaptar un modelo a cada tarea aumenta la carga de trabajo
La atención al cliente y la descripción de productos requieren textos distintos, aunque utilicen el mismo modelo de lenguaje. Una respuesta de soporte puede necesitar explicar los pasos con claridad y en orden; una descripción comercial, presentar las características en un formato uniforme. Entrenar con ejemplos de esas tareas se denomina ajuste fino. La cuestión es si resulta necesario modificar todos los pesos cada vez.
Los pesos son valores internos del modelo que influyen en cómo la información pasa al siguiente cálculo. El ajuste fino completo incluye en el entrenamiento el conjunto de los pesos existentes. En un modelo grande hay que gestionar, además de los valores que se actualizan, los gradientes y los estados del optimizador. Conservar una copia íntegra para cada tarea también exige espacio de almacenamiento.
LoRA plantea conservar el modelo preentrenado y representar los cambios necesarios para una tarea con menos valores entrenables. No elimina el modelo original ni lo sustituye por otro más pequeño. Añade una vía de corrección de tamaño reducido al cálculo existente y entrena esa vía.
2. Mantener el cálculo original y aprender solo la modificación
Podemos representar uno de los cálculos del modelo mediante una matriz, es decir, una tabla de números. Si la matriz de pesos original es W₀, LoRA expresa la modificación como el producto de dos matrices más pequeñas, A y B. La misma entrada recorre la vía W₀ y la vía A→B, y sus resultados se suman.
La clave consiste en mantener W₀ fija y entrenar únicamente A y B. El artículo expresa el cálculo como W₀x + BAx y aplica además el factor de escala α/r a la corrección. La variable x es la entrada; r es la dimensión intermedia que conecta ambas matrices. Congelar los pesos no interrumpe el cálculo original: siguen utilizándose, pero el entrenamiento no modifica sus valores.
El rango bajo limita el número de direcciones independientes con las que puede representarse la actualización. En lugar de entrenar cada elemento de una matriz grande por separado, dos matrices construyen el cambio a través de una dimensión intermedia reducida. Un r menor disminuye los valores entrenables, pero también restringe las modificaciones posibles. No se trata de descartar palabras o documentos considerados poco importantes.
Una matriz de pesos de d filas y k columnas contiene d×k elementos. A tiene dimensiones r×k y B, d×r, de modo que ambas suman r×k + d×r elementos entrenables. Si se aplica LoRA a más capas o a más tipos de pesos, aumenta el entrenamiento total. Por tanto, el rango por sí solo no determina el coste de entrenar el modelo completo.
3. Una tienda en línea y un ejemplo de tamaño de matrices
Supongamos que una tienda recopila respuestas preparadas por su equipo de atención al cliente. Empareja la pregunta «¿Cómo solicito un cambio?» con una respuesta que explica los pasos necesarios. Los pesos del modelo base permanecen fijos, mientras que las pequeñas matrices de LoRA se ajustan para reducir la diferencia entre los ejemplos de entrenamiento y la salida del modelo.
Si existen otros ejemplos para redactar descripciones de productos, puede aprenderse y guardarse otra corrección para el mismo modelo base. Al utilizarlo, se selecciona el adaptador correspondiente a la tarea. Aquí, adaptador significa el conjunto de parámetros de corrección aprendido. Crear dos adaptadores no combina automáticamente sus capacidades ni garantiza su compatibilidad con otro modelo base.
Como cálculo puramente ilustrativo, consideremos una matriz de 4.096 filas y 4.096 columnas. Si se actualizan todos sus elementos, se entrenan 16.777.216 valores. Con LoRA y r=8, A contiene 8×4.096 elementos y B, 4.096×8: en total, 65.536 valores entrenables.
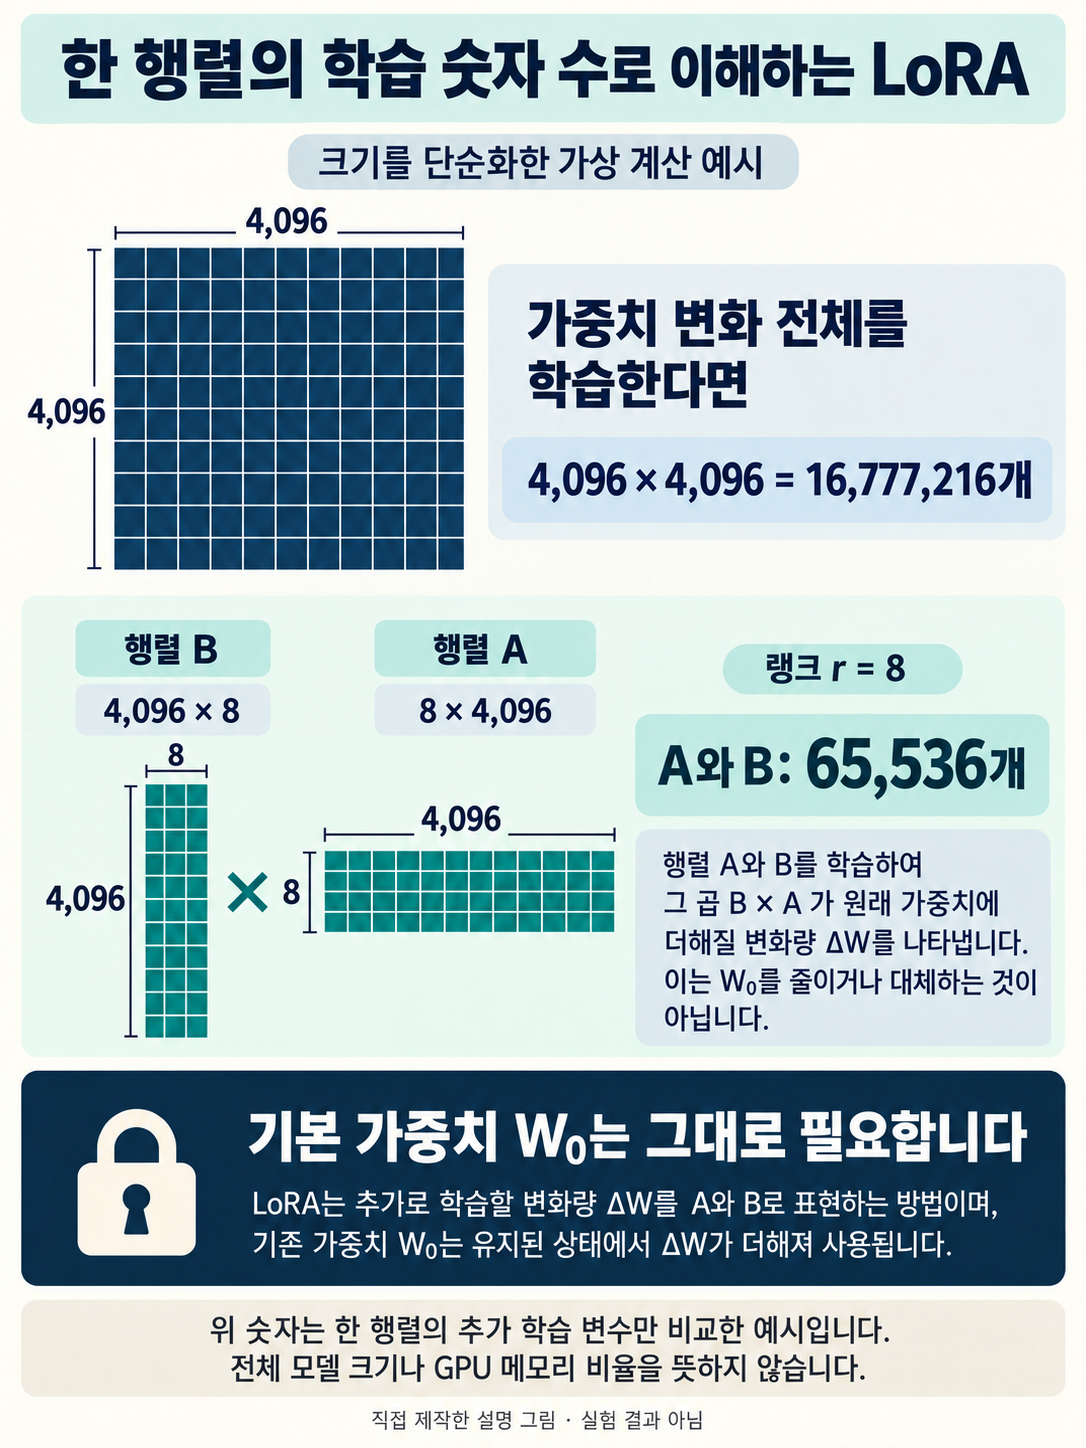
La diferencia explica por qué la corrección que se guarda para cada tarea puede ser pequeña. Sin embargo, la atención real al cliente también necesita la política de cambios vigente y los datos del pedido, además del estilo de redacción. Los errores fácticos de los ejemplos afectan al aprendizaje. La adaptación del modelo y el suministro de información empresarial actualizada y correcta deben diseñarse conjuntamente.
4. Cómo interpretar las cifras del experimento original
La tabla 3 de la versión 2 compara GPT-2 Medium en E2E NLG Challenge. Es una tarea de generación de texto a partir de datos: se proporcionan atributos de un restaurante y sus valores, y se genera una descripción. La tabla siguiente recoge únicamente dos filas de esa comparación.
| Método | Parámetros entrenables | BLEU |
|---|---|---|
| Ajuste fino completo | 354.92M | 68.2 |
| LoRA | 0.35M | 70.4 ± 0.1 |
M significa un millón, y las cifras cuentan los parámetros entrenables, no el tamaño total del modelo. BLEU mide la coincidencia de expresiones entre el texto generado y uno de referencia. No representa la probabilidad de que una respuesta de atención al cliente sea correcta ni un porcentaje de exactitud factual. En este experimento, LoRA redujo notablemente los parámetros entrenables y obtuvo un BLEU superior al de la referencia seleccionada.
LoRA aplicó r=4 tanto a los pesos de proyección de consultas como a los de valores del mecanismo de atención. El apéndice D.3 y la tabla 11 indican cinco recorridos completos de los datos de entrenamiento, es decir, cinco épocas, y una anchura de búsqueda en haz de 10 durante la generación. Los autores promediaron tres semillas aleatorias, escogiendo la mejor época de cada ejecución. El ±0.1 es la notación del intervalo de confianza que figura en la tabla; el resultado del ajuste fino completo procede de un trabajo anterior.
Estas cifras no prometen una mejora de las respuestas de soporte de cualquier empresa. Las descripciones de restaurantes y las consultas de una tienda tienen entradas y objetivos distintos. Se necesitan datos de evaluación propios de la tarea para examinar conjuntamente las omisiones, los errores fácticos y el formato del texto.
5. El coste de entrenamiento no equivale al coste de inferencia
LoRA reduce las variables que se entrenan, pero no elimina los recursos necesarios para cargar el modelo base y procesar las entradas. La memoria de entrenamiento también depende del tamaño del modelo, la longitud de entrada, el tamaño del lote y la precisión numérica. Un archivo de adaptador pequeño no demuestra que el entrenamiento vaya a caber en una GPU de determinada capacidad.
Una vez terminado el entrenamiento, el producto de las dos matrices, con su factor de escala, puede sumarse a los pesos originales. La inferencia con esos pesos fusionados no necesita ejecutar por separado la vía de corrección. Fusionar es una opción de despliegue; otra consiste en mantener los adaptadores separados y alternarlos. No sería correcto afirmar que todos los servicios sin fusión tienen una latencia adicional nula.
La documentación oficial de Hugging Face PEFT explica la configuración de LoRA y la fusión de pesos. Sin embargo, merge_and_unload devuelve un modelo convencional que ya no conserva las funciones específicas de PEFT para desactivar o cambiar el adaptador. La decisión operativa debe ponderar la comodidad de gestionar pequeños archivos por tarea frente a la de ejecutar un modelo fusionado.
Aumentar r tampoco asegura mejores resultados. Si los datos de entrenamiento o los puntos de aplicación no son adecuados, el coste puede crecer sin alcanzar la calidad buscada. Comparar configuraciones con los mismos datos de evaluación de la tarea ayuda a explicar qué modificación produjo una mejora.
6. Documentar las diferencias técnicas para el desarrollo y las patentes
Conviene registrar el modelo base y su versión, la composición de los datos de entrenamiento, los puntos donde se aplica LoRA, el rango r y si los pesos se fusionan para el despliegue. Vincular cada adaptador con el modelo base empleado para entrenarlo ayuda a evitar combinaciones incompatibles. Las comparaciones de calidad deben conservar también los datos de evaluación y la configuración de generación.
Lo que sigue es una perspectiva independiente de práctica de patentes para preparar una consulta técnica, no una conclusión experimental del artículo. En lugar de describir un desarrollo propio solo como «reducir costes con LoRA», interesa explicar la secuencia de procesamiento: qué entradas determinan la corrección elegida, cómo se organizan los datos de cada tarea y cómo se gestiona la correspondencia entre adaptadores y modelos base.
Si un desarrollo evita conectar un adaptador incorrecto al cambiar de tarea, la explicación técnica se centra en la información que permite identificarlo, el momento de selección y aplicación, y el flujo que impide el error. Esto no afirma que exista una nueva patente concedida ni garantiza la concesión. Separar la arquitectura conocida de LoRA del procesamiento concreto añadido facilita el análisis de la diferencia técnica.
Como lecturas relacionadas, PagedAttention aborda el almacenamiento de la caché KV durante la inferencia y FlashAttention-2, la distribución del trabajo de cálculo de la atención. LoRA se centra en los parámetros que se entrenan al adaptar el modelo. Distinguir primero si la limitación aparece durante el entrenamiento o la inferencia aclara para qué se estudia cada técnica.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Servicio relacionado: patentes de IA
IPLEX le ayuda a concretar las diferencias técnicas de su desarrollo de IA. Consulte nuestros proyectos, publicaciones y servicios de asesoramiento en esta materia.
Conozca la experiencia de IPLEX en IA
Artículo de LoRA: Low-Rank Adaptation of Large Language Models
Documentación oficial de Hugging Face PEFT
PDF de LoRA: apartado 4.1, tabla 3, apéndice D.3 y tabla 11
Implementación y experimentos oficiales de Microsoft LoRA
Hugging Face PEFT: guardado de modelos fusionados y diferencias funcionales
PagedAttention: cómo vLLM gestiona la caché KV y la memoria GPU
FlashAttention-2: atención eficiente en GPU para contextos largos