
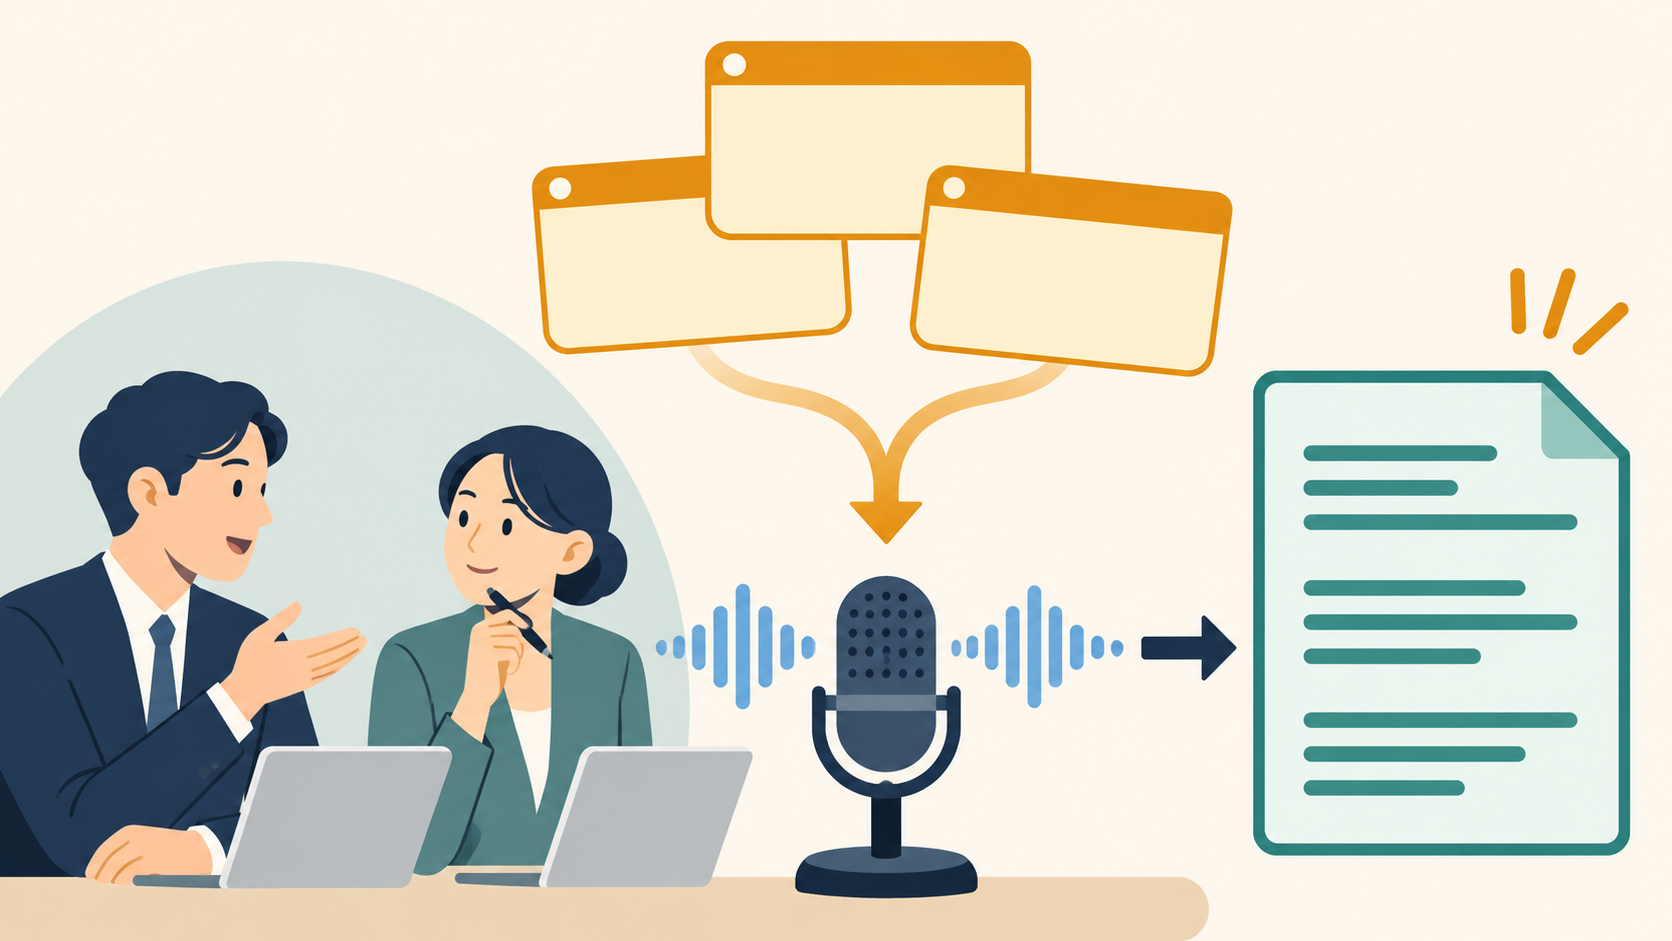
会議の発言をほぼ正しく文字起こしできても、製品コードを一つ取り違えれば記録の意味が変わります。iFLYTEKと中国科学技術大学の特許は、候補語を手がかりに音声を捉え、その音声を使って候補語を絞る処理を示しています。
1. 短いコードが記録を左右する
試作品の検討会でAX-17とAX-70を使う場面を考えます。末尾の違いを誤ると、担当者が別の試験記録を参照してしまう可能性があります。
音声認識では、一般的な表現に比べて社内固有の名称や略語の学習例が少ない場合があります。共通する音だけでは二つのコードを区別できません。
両者の共同出願による欧州特許EP4156176B1は2025年9月10日に特許付与が公告されました。文字起こしの途中で、会議に関連する候補語を参照する技術です。
2. 音声と候補語を別々に符号化する
まず音声とホットワードの一覧を別々に符号化します。ここでいうホットワードは文脈に応じた候補語であり、必ずしも音声アシスタントの起動語ではありません。
会議ごとの名称や略語を用意しても、その語が実際に発話されたとは限りません。候補一覧は音声の根拠を補う情報です。
この一覧を復号処理の中で利用する点が重要です。完成した文章の文字列を後から一括置換する処理とは異なります。
3. 二つの注意機構で情報をやり取りする
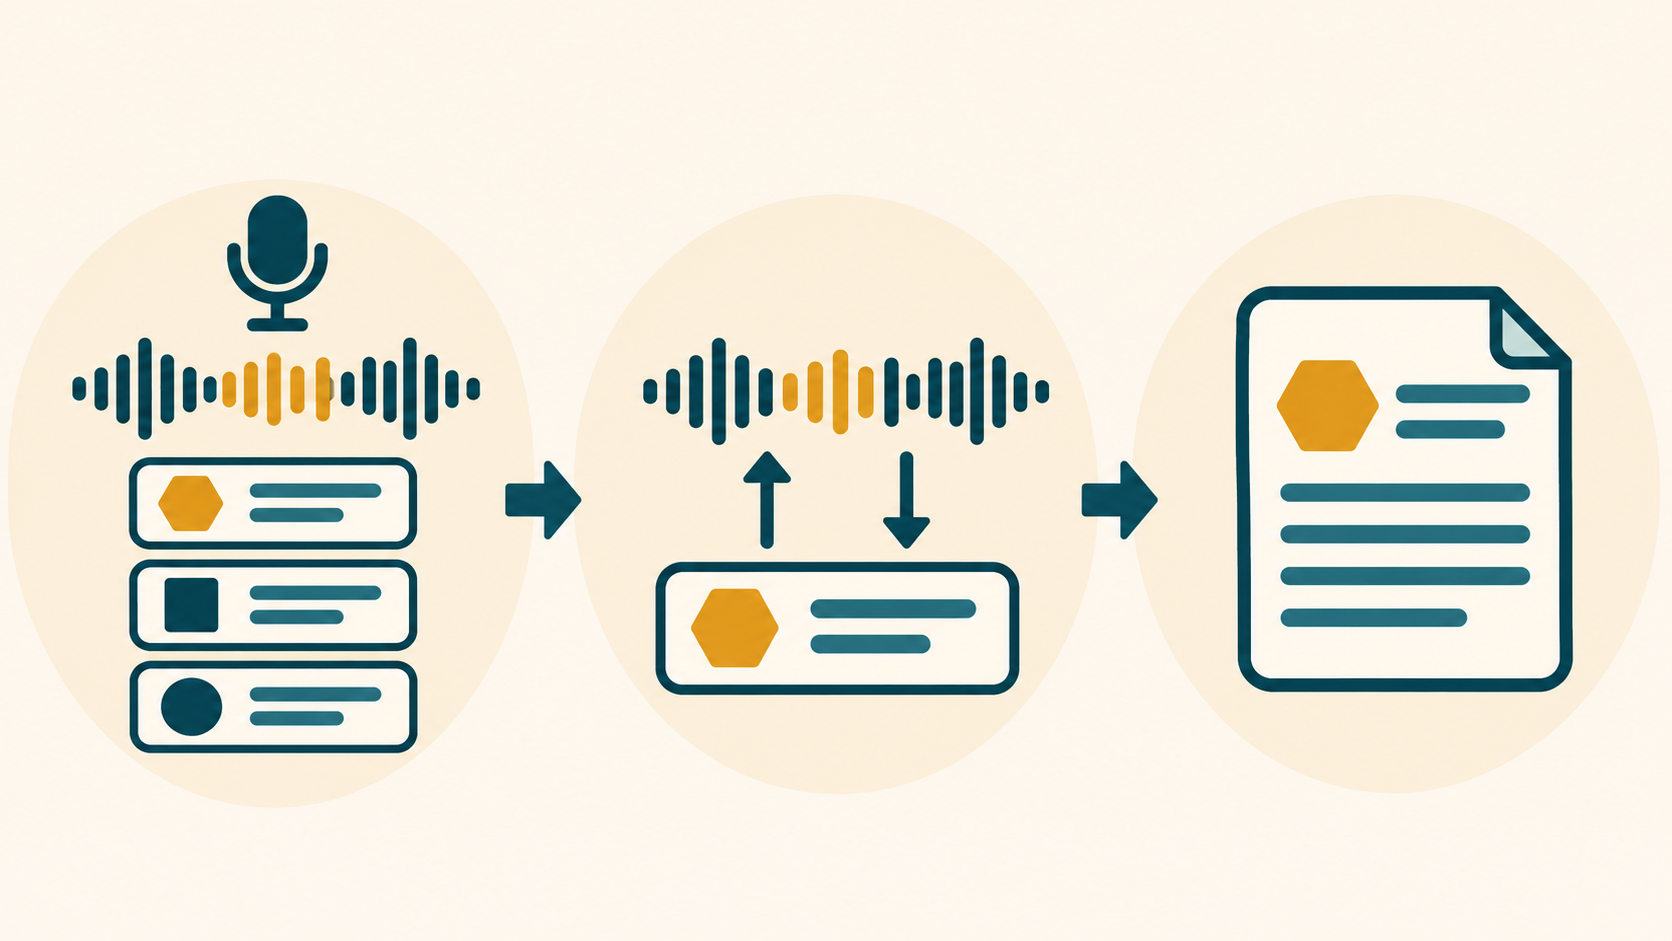
第1の注意機構は、候補語の符号化結果と、それまでの復号情報を表すデコーダーの状態を使い、必要な音声特徴を選びます。
第2の注意機構は、その音声特徴に基づいて候補語を評価します。音声側と候補語側の特徴を組み合わせ、復号と分類に渡します。
通常の文字、動的に加えた候補語に加え、ホットワードに該当しない場合も扱います。語を登録しただけで、その語を必ず出力する仕組みではありません。
4. AX-17とAX-70を聞き分ける例
仮想の会議では、AXという共通部分から両方のコードが候補になります。その後の音や復号中の文脈が、末尾の違いを判断する材料です。
図は候補語と音声が相互に判断を支える流れを示したものです。認識精度の実測値や、市販サービスでの入力対応を示すものではありません。
評価には一般語や一覧にない発言も含めます。候補語を強く優先しすぎると、別の発言に登録語を誤って挿入するおそれがあります。
5. 特許とサービスの対応範囲
参照したXFYUNのリアルタイム文字起こし資料では、標準サービスのカスタム語はUTF-8の中国語文字に限定され、数字と英字は対象外です。AX-17は特許の説明例であり、このサービスで登録できる入力例ではありません。
AINOTE 2の公式紹介は、文字起こし、翻訳、会議要約をそれぞれ製品機能として説明しています。それだけで特定の請求項を実施しているとは判断できません。
コードの誤認識は翻訳や要約にも引き継がれます。最終的な文章の読みやすさだけを見ても、最初の対象識別の誤りは分かりません。
6. 比較と技術整理の要点
会議の目的に合わせて候補語の範囲と版を管理します。全体の誤り率に加え、重要コードの再現率、候補語の誤挿入、通常語への影響を確認します。
技術を整理する際は、二つの符号器、デコーダー状態の入力、注意機構の順序、一般候補と文脈候補の評価方法を具体化します。
提案する処理、サービスの入力制約、実測結果を分けて記録します。同じ音声を使い、文脈情報を利用する場合と利用しない場合を比較すると違いを説明しやすくなります。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
会議と製品コードは仮想例です。製品紹介のみから特定の請求項の実施を確認したものではありません。
ソクラAIの個別学習特許:同じ問題を間違えても次の問題が変わる理由
NVIDIAの早期枝刈り:小さなネットワークを選ぶ時期の判断
音声認識と文脈を用いた復号技術の整理には、IPLEXのAIプロジェクトと相談準備資料をご覧ください。