
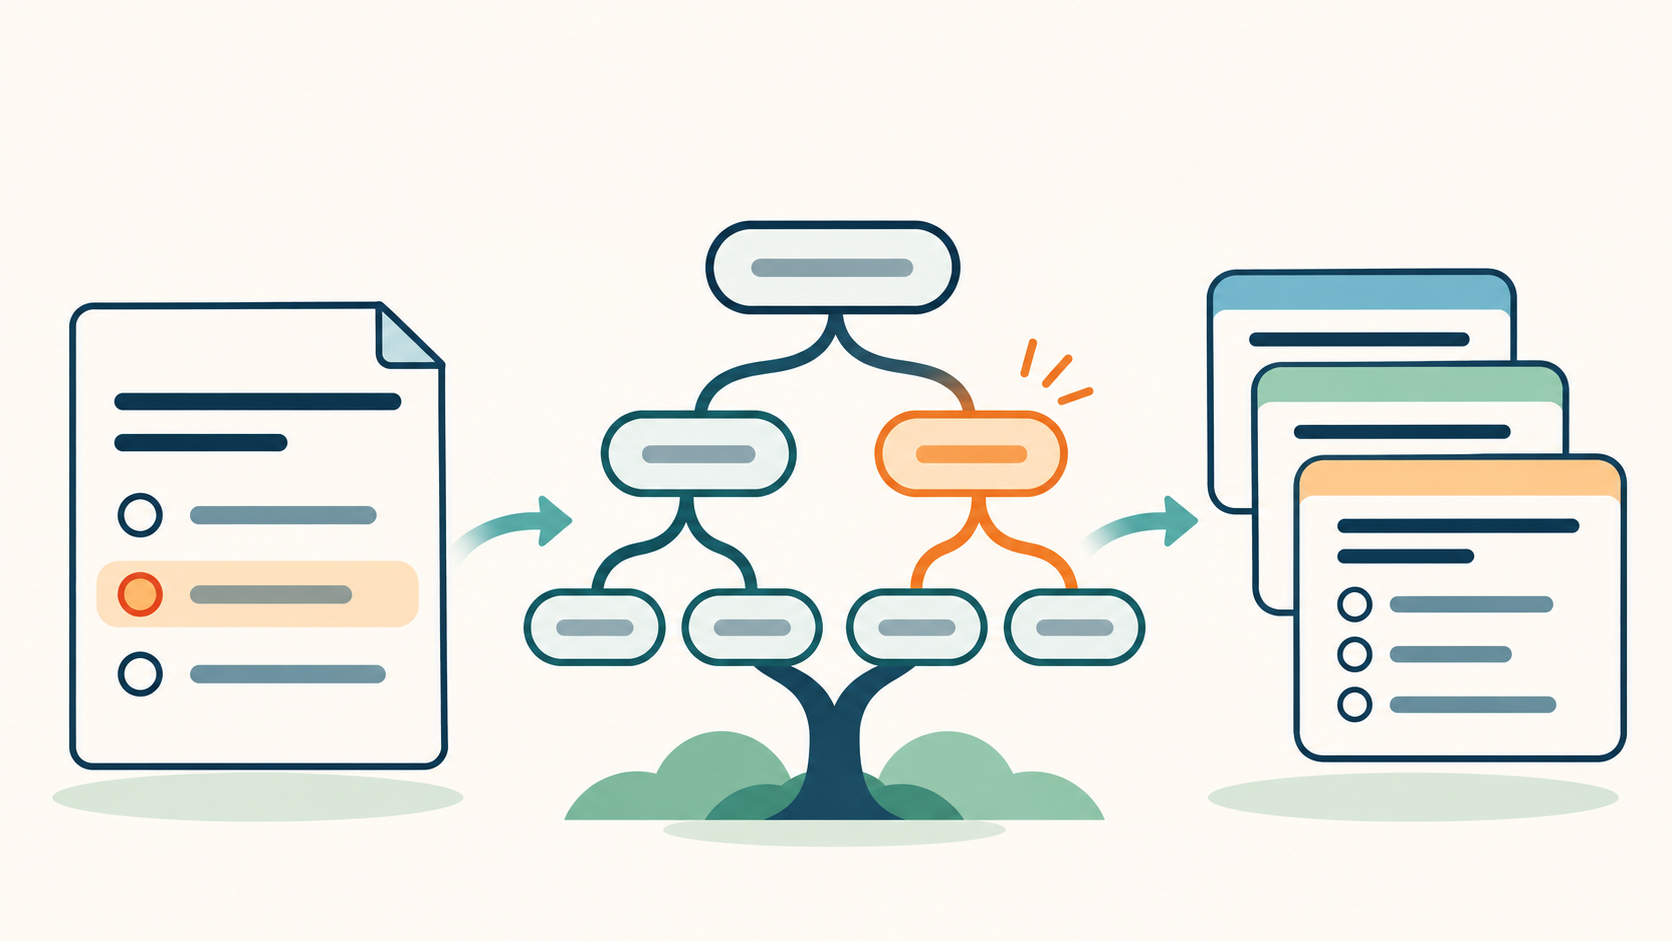
同じ問題を間違えた二人でも、選んだ誤答が違えばつまずいた概念も異なる可能性があります。Riiidが出願したUS11238749B2は、誤答選択肢に学習概念のタグを付け、解答履歴から習熟度を更新して次の問題を推薦する方法を記載しています。架空の英語問題で仕組みを説明し、ソクラAIが公表するSantaの機能は別に整理します。
同じ点数でも必要な練習は異なる
同じ英文法問題で、一人は昨日の出来事に現在形を使い、もう一人は過去形を選びながら複数主語に単数形の動詞を合わせたとします。採点ではどちらも誤答一つですが、必要な練習は異なり得ます。
問題番号や単元だけを記録すると、二人に同じ問題を出し直しがちです。選択した誤答の情報を残せば、時制を確認すべきか、主語と動詞の一致を確認すべきか検討できます。
Riiidの米国特許US11238749B2は2022年2月1日に登録され、選択肢へのタグ付け、概念別の習熟度更新、問題の個別化を扱います。Riiidはその後、社名をSocra AIへ変更しました。
学習概念と誤答選択肢を表現する
記載された処理では、学習要素を木構造に整理します。英文法から動詞へ、さらに時制や一致へと分けるイメージです。個々の要素をタグで識別し、複数のタグを分析に適したグループへまとめます。
問題データベースには問題と答えだけでなく、各誤答選択肢に対応するタグも保存します。一つの選択肢に複数のタグを付ける場合があり、コアタグは主に確認したい出題意図を表します。
細かなタグは誤解の可能性を区別する助けになりますが、解答履歴が少ないと各タグについて十分な情報が得られません。タグをまとめた分析グループで、複数の問題を通じた記録を扱います。
解答履歴を習熟度の指標へ変える
学習者が端末から答えを送信すると、分析サーバーが問題データベースの情報と照合します。分析グループごとに管理する指標を、特許はconquest rateと呼びます。ここでは推定習熟度として説明します。
誤答時の例では、出題意図に対応するコアの誤答選択肢と、学習者が実際に選んだ選択肢の両方を使います。選択肢に複数タグがあれば重みを分配し、同じタグへの寄与を合算します。時制と一致の双方に関係する選択は、両方の項目に反映できます。
新しい結果を取り込む際、以前の指標の影響を弱めることもできます。古い誤答と直近の解答が同じ影響を持ち続けると、既に学んだ概念が弱点として残るためです。単純な正解数に加え、選択肢の構造と変化する履歴を考慮する方法です。
これは解答パターンからの推定です。問題の読み違いや偶然の選択もあり得るため、分析グループ内での繰り返しの傾向と、その後の更新が重要です。理解状態を直接測る値ではありません。
架空の英語問題で考える
英文を「The reports ___ ready yesterday.」とします。正解はwereです。areは複数形に合いますがyesterdayと時制が一致せず、wasは過去形でも複数主語に合いません。前者に時制、後者に主語と動詞の一致のタグを付けることができます。
同様の誤答が複数の問題で続くなら、一人目には時間表現と時制を結び付ける練習、二人目には複数主語に合う動詞を選ぶ練習を出す設計が考えられます。これはタグと推薦の関係を説明する架空例です。
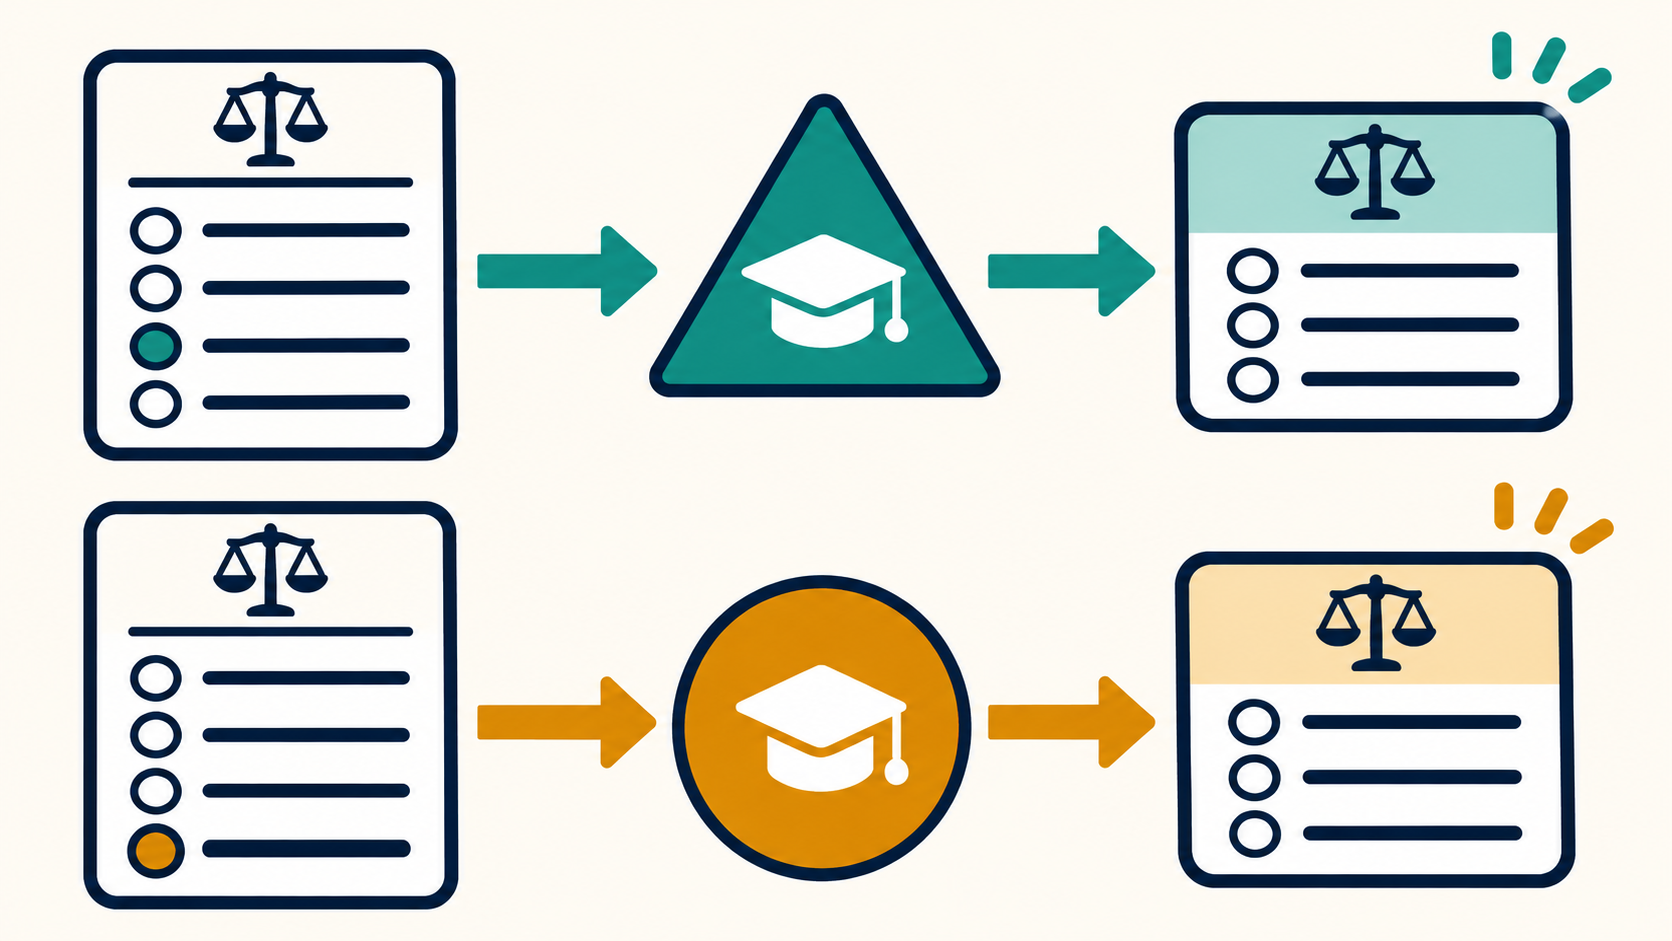
明細書には、弱い分析グループのタグをコアとする問題や、以前間違えた問題と誤答タグ構成が似た問題を選ぶ例があります。端末の解答を受け、サーバーがタグ情報で状態を更新し、データベースの候補から次の問題を返す流れです。
Santaが公表している機能
ソクラAIはSantaをTOEIC・TOEFL向けのAI学習サービスとして紹介しています。試験に特化した得点予測、弱点分析、学習戦略の推薦と、その後の学習に応じた更新を説明しています。これらは会社の公表内容であり、特定の請求項の実施や学習成果を保証する証拠ではありません。
推薦の理由を説明できる記録
開発では、まず選択肢へのタグ付け基準をそろえます。ある担当者が時制、別の担当者が語彙の誤りと分類すれば、推薦も変わります。基準と例外を文書化し、担当者間の判断の一致を調べると、注釈付けの品質を把握できます。
正答率が近くても誤答パターンが異なる学習者を比較します。元のタグ、選択肢、更新された分析グループ、候補、最終問題を記録し、複数タグの選択肢や履歴の少ない利用者も含めます。
特許の観点では、入力と候補を絞る規則を具体化します。正誤数だけの設計、誤答タグを使う設計、過去の重みを調整する設計を同条件で比べれば、各処理の寄与が明確になります。IPLEXは、こうした処理段階と観察結果を技術説明として整理する相談に対応します。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
英語問題は架空です。特許の技術的記載の一部を解説し、Santaの製品説明と請求項の実施判断を区別しています。
Googleの文書理解特許:見出し・本文・画像の配置を併せて読み取る仕組み
ノタのAIモデル圧縮特許:中間の入出力を保存し、小さくした層群を再学習する仕組み
個別学習や推薦技術の整理には、IPLEXのAIプロジェクトと相談準備資料をご覧ください。