
Стенограмма может правильно передавать обычные фразы, но путать важный код изделия. Патент iFLYTEK и Научно-технического университета Китая использует кандидаты из словаря для выделения звуковых признаков, а затем сопоставляет с этими признаками сами термины.
1. Почему важен короткий код
Представим обсуждение прототипов AX-17 и AX-70. Ошибка в окончании способна направить сотрудника к другому протоколу испытаний или изменить повестку следующей встречи.
В обучающих данных обычно больше общеупотребительных выражений, чем внутренних названий компании. Совпадающего звучания начала кода недостаточно для правильного выбора.
О выдаче совместного европейского патента EP4156176B1 объявлено 10 сентября 2025 года. В нём описан учёт подготовленного словаря непосредственно при преобразовании речи в текст.
2. Отдельное кодирование звука и словаря
Аудио и список контекстных терминов кодируются раздельно. Термин hotword здесь означает подходящее для ситуации слово, а не обязательно команду активации помощника.
В список можно включить названия и сокращения конкретной встречи. Наличие слова в списке ещё не означает, что оно прозвучало: нужны акустические основания.
Словарь участвует в декодировании. Это отличается от массовой замены фрагментов уже готовой стенограммы.
3. Последовательность двух механизмов внимания
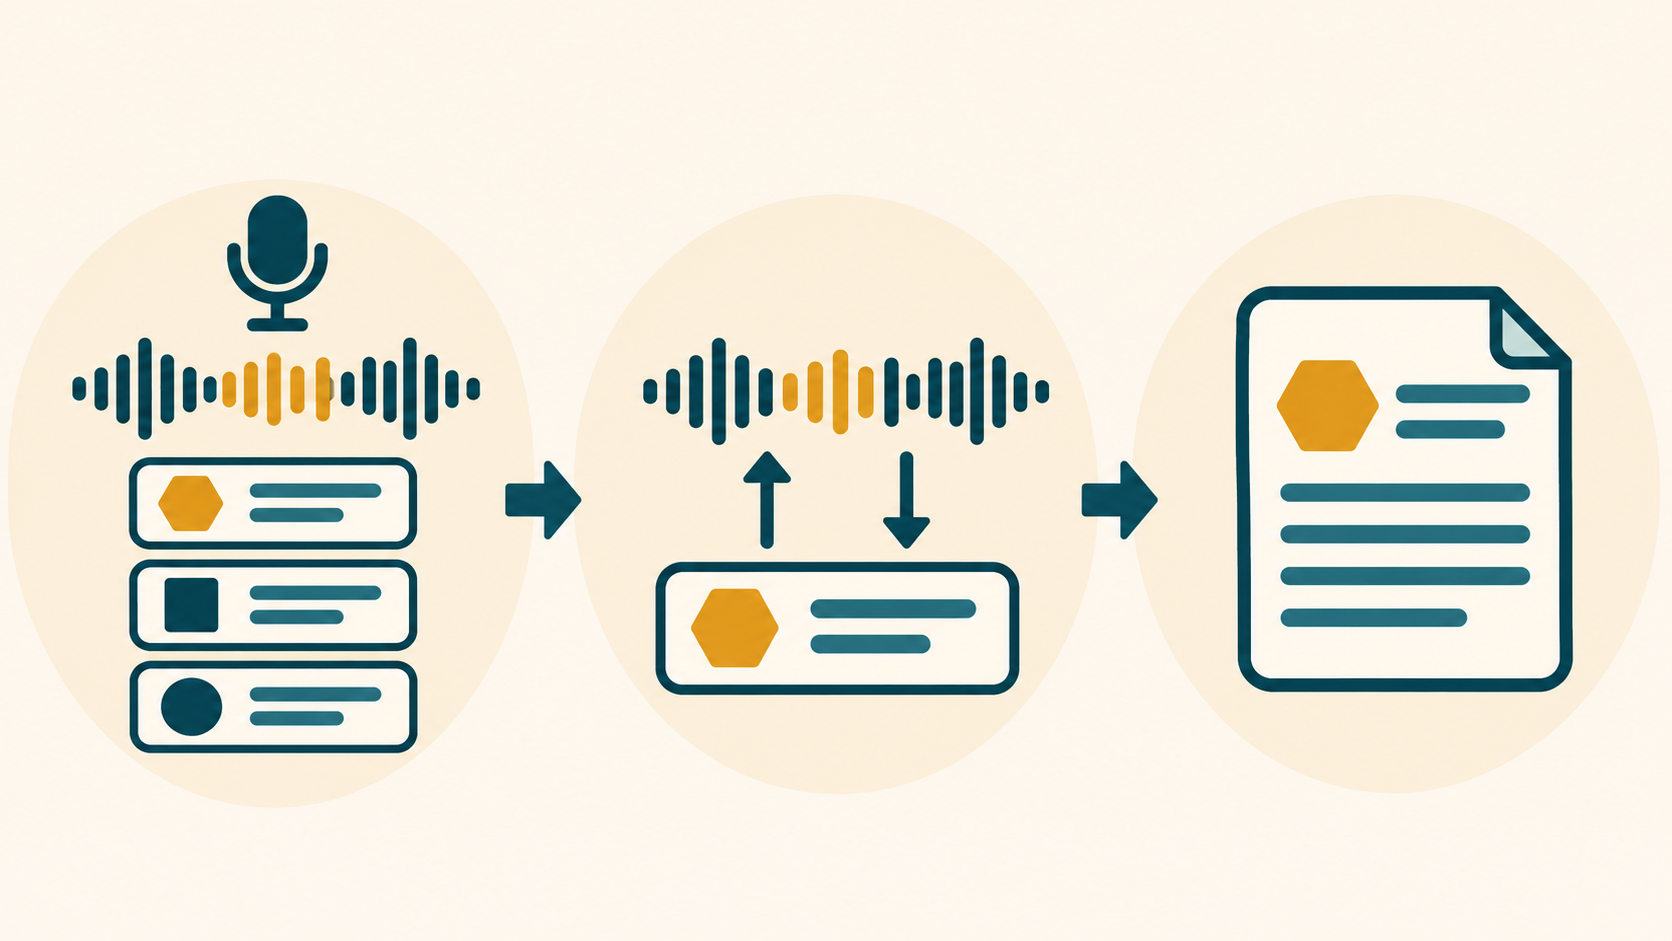
Первый механизм использует кодирование терминов и состояние декодера, отражающее ранее декодированную информацию, чтобы выделить необходимый аудиопризнак.
Второй механизм на основе этого аудиопризнака оценивает кандидатов из словаря. Звуковые и словарные признаки объединяются для декодирования и классификации.
Классификатор рассматривает обычные символы, динамически добавленные термины и вариант отсутствия подходящего термина. Добавление слова не предписывает принудительно вставлять его в текст.
4. Условный пример AX-17 и AX-70
В воображаемой встрече общее начало AX позволяет рассматривать оба кода. Последующее звучание и контекст декодирования помогают различить окончания.
Иллюстрация объясняет взаимное сопоставление словаря и звука. Она не представляет измеренную точность и не подтверждает поддержку этих кодов коммерческим сервисом.
В испытания следует включать обычные слова и выражения вне списка. Чрезмерное предпочтение словаря может привести к вставке термина вместо действительно произнесённой фразы.
5. Патент и возможности сервиса
Изученная документация XFYUN по транскрибации в реальном времени допускает в стандартном сервисе пользовательские термины из китайских символов UTF-8, исключая цифры и латинские буквы. AX-17 служит примером механизма патента, а не допустимого ввода этого сервиса.
Официальная страница AINOTE 2 отдельно описывает транскрибацию, перевод и подготовку краткого содержания встреч. Эти сведения не доказывают реализацию конкретных пунктов формулы патента.
Ошибка в коде может перейти в перевод и итоговое резюме. Проверка только связности конечного текста способна скрыть исходную ошибку идентификации.
6. Что фиксировать при разработке
Нужно определять состав и версию словаря для каждой встречи. Наряду с общей частотой ошибок оценивают восстановление важных кодов, ложные вставки и влияние на обычные слова.
В техническом описании следует указать оба кодировщика, использование состояния декодера, порядок внимания и способ оценки обычных и контекстных кандидатов.
Предлагаемый механизм, ограничения сервиса и измеренные результаты фиксируют отдельно. Сравнение одного аудио с контекстной обработкой и без неё помогает показать техническое различие.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Встреча и коды условные; описание продукта не подтверждает реализацию конкретных пунктов формулы патента.
Документация XFYUN по транскрибации
Официальная информация об AINOTE 2
Патент Socra AI на персонализацию обучения: разные ошибки — разные следующие задания
Ранняя обрезка NVIDIA: когда структура меньшей сети достаточно устойчива
Ознакомьтесь с проектами ИИ и материалами IPLEX для обсуждения распознавания речи и контекстного декодирования.
Опыт патентного поверенного Ким Ёндока в области ИИ