
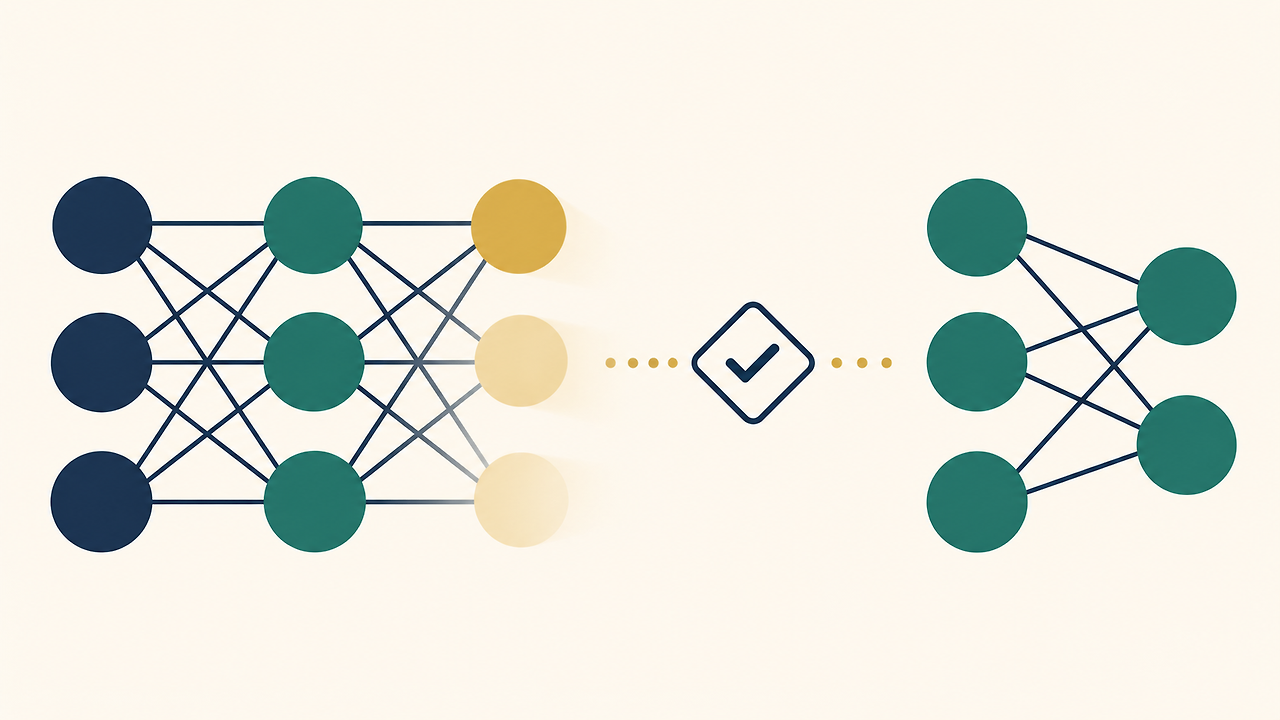
学習の完了前にネットワークを小さくできれば、その後の計算を減らせます。ただし初期の重要度が低いだけでは不要とは断定できません。NVIDIAの特許は、候補部分ネットワークの構造が安定したかを判断材料にします。
1. 削る対象と時期は別の判断
ニューラルネットワークは、計算ノードの層と学習する重みから構成されます。構造的な枝刈りではノードなどを取り除き、以後の学習対象を小さくします。
重要度には重みの大きさや勾配に基づく感度などを使えます。候補を選ぶ指標と、その構造が十分安定したかを見る指標は役割が異なります。
NVIDIAのUS12792915B2は2021年3月15日出願、2026年11月10日付与です。ノードの重要度、候補構造、安定性、早期枝刈りを結び付けています。
2. 初期の順位は暫定的
学習初期に重要度が低いノードでも、後で役立つ可能性があります。直ちに削ると、容量の配分が固まる前に学習を制限しかねません。
そのため、最初の順位を最終結果とせず、学習中に候補となる部分ネットワークを観測します。
どのノードを残すかと、いつその選択を実行するかを分け、両方の条件を記録することが大切です。
3. EPIが比較するもの
同じ著者らのCVPR 2022論文はEarly Pruning Indicator(EPI)を説明しています。重要度順に選んだノードについて、層ごとの残存数で候補構造を表します。
現在と過去の複数エポックの構造類似度を平均します。アルゴリズム2では、しきい値以上であり、直前5回の各評価値以上という条件で、次のエポックを枝刈り段階に移します。
層ごとの数が近くても、同じノードや重みが保たれているとは限りません。容量配分の安定を示す指標であり、学習終了や精度を保証するものではありません。
4. 文書分類を想定した例
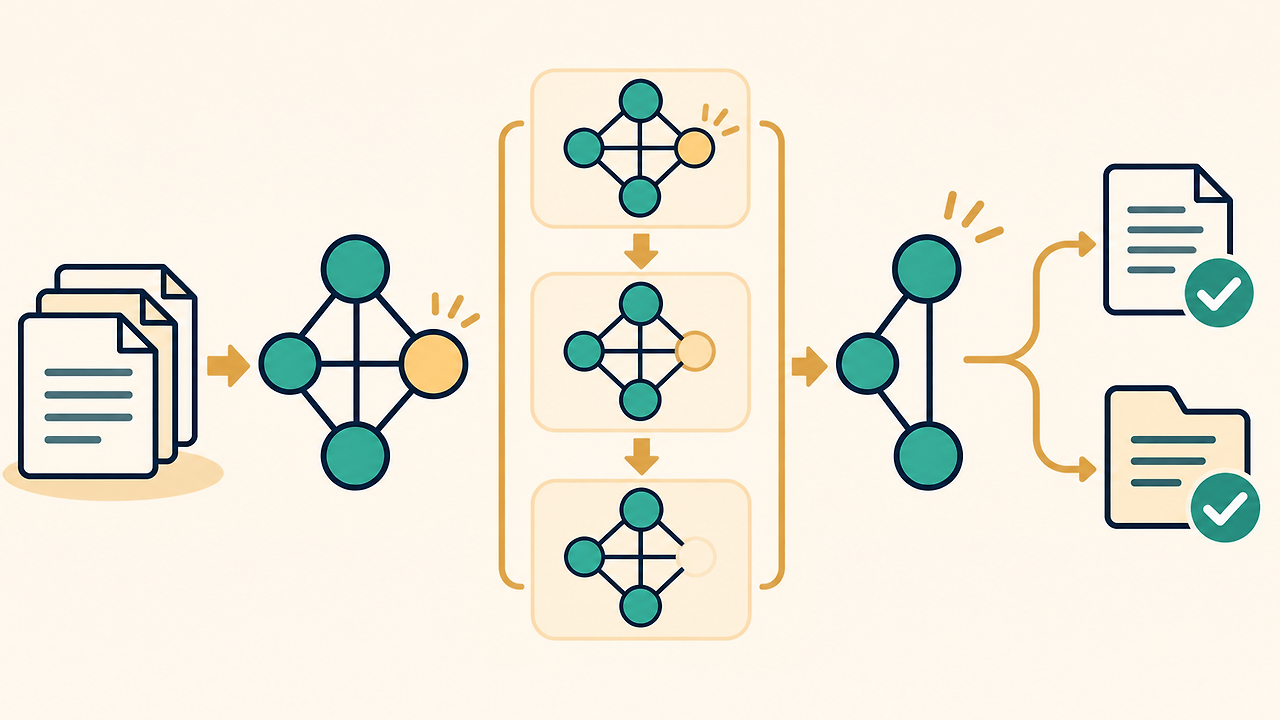
購買部門が注文書、納品書、請求書を分類する場面を考えます。初期には浅い層と深い層で重要なノード数の配分が変わる可能性があります。
所定の基準で配分が安定したら、順位の低いノードを削り、小さくしたネットワークの学習を続けます。文書の種類や学習データを削る処理ではありません。
図は流れの仮想例で、削減効果の実測値ではありません。似た文書を区別できるかなど、学習に使わないデータで品質を確認する必要があります。
5. 事前学習済みモデルの圧縮との違い
NVIDIA Model OptimizerのMinitronは、事前学習済みチェックポイントから始め、較正データによる重要度を使って幅や深さを縮める流れです。
性能回復には追加学習や知識蒸留を行います。元の学習途中で枝刈り時期を決める方式とは開始点が異なります。
どちらもモデル縮小ですが、利用できる情報や学習費用の計上範囲が違います。ツール名だけで特許の処理を実施しているとは判断できません。
6. 技術と効果の記録
重要度の基準、残すノード数、安定性の推移、しきい値、実行エポックを記録します。条件を揃え、全体を最後まで学習する場合と早期に削る場合を比較します。
学習資源の削減と、実機での推論速度は別々に測ります。構造が小さいだけでは特定の実装の待ち時間は決まりません。
技術資料では、選択条件と実行時期を、その後の学習と測定品質までつなげます。モデルサイズからの推測と観測結果を区別します。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
文書分類は仮想例です。EPIは構造安定性の指標であり、精度や製品での実施を保証しません。
ノタのAIモデル圧縮特許:中間の入出力を保存し、小さくした層群を再学習する仕組み
ソクラAIの個別学習特許:同じ問題を間違えても次の問題が変わる理由
モデル圧縮と学習制御の技術整理には、IPLEXのAIプロジェクトと相談準備資料をご覧ください。