
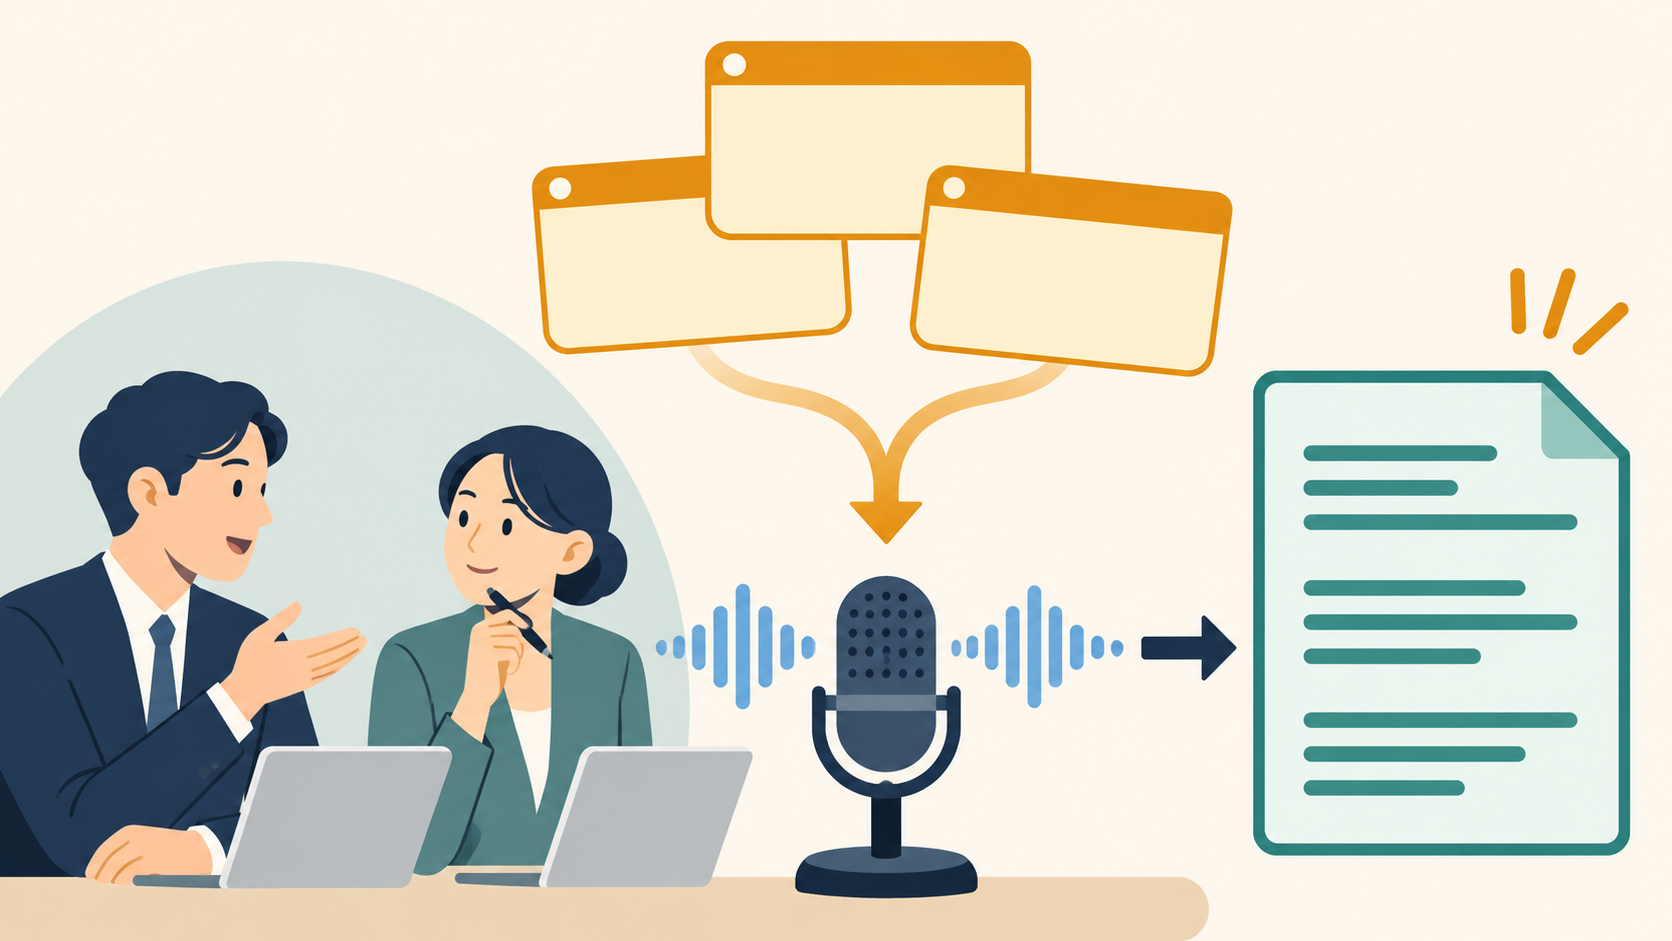
会议转写即使大部分文字正确,一个产品代码的错误也可能影响后续工作。科大讯飞与中国科学技术大学的专利利用候选术语寻找相关音频特征,再用音频特征判断候选术语。
1. 短代码为何容易出错
假设研发会议讨论AX-17和AX-70两款样机。若末尾数字被误写,负责人可能调取错误的测试记录,或误记下一次会议的议题。
语音识别模型对常用表达较熟悉,对特定公司的名称和缩写则未必有足够训练样本。两个代码共有的声音不能单独决定识别结果。
科大讯飞与中国科学技术大学共同申请的欧洲专利EP4156176B1于2025年9月10日授权公告,描述了在解码过程中参考相关术语列表的方案。
2. 分别编码音频与热词
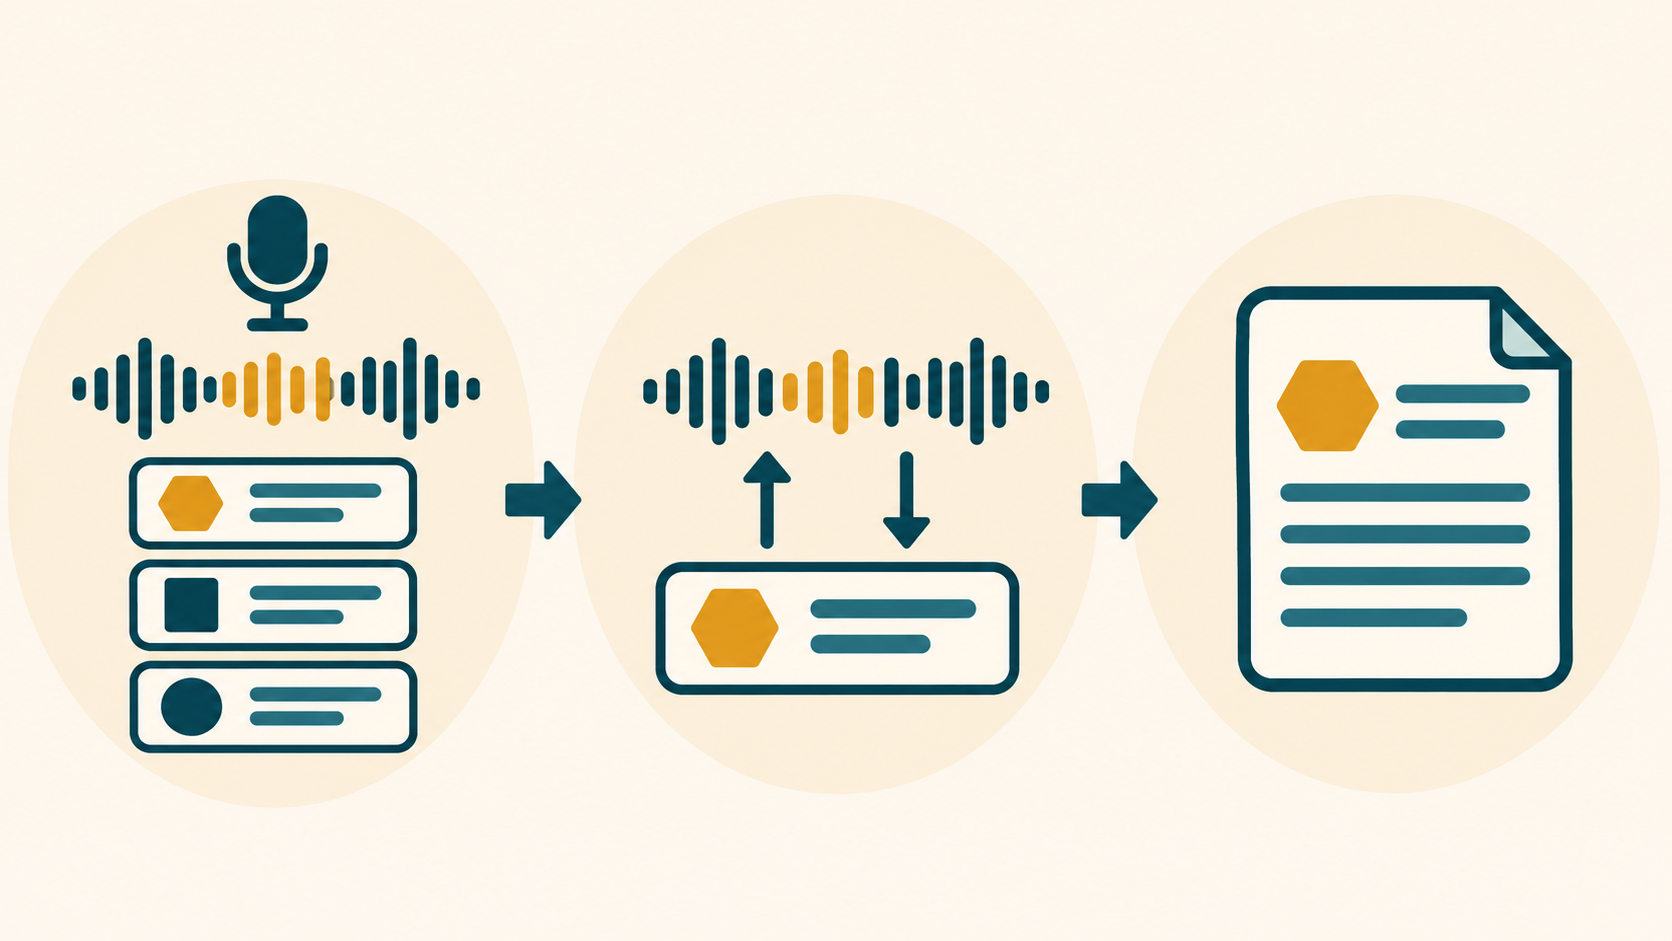
系统分别对待识别音频和候选热词进行编码。这里的热词是与当前场景相关的术语,不一定是唤醒语音助手的口令。
会议主题对应的名称、缩写可以构成候选列表,但列入候选并不证明说话人确实说了该词,仍需声音证据。
列表参与语音转写过程中的解码,而不是在已经生成的文本中进行批量替换。描述技术方案时应保留这一处理次序。
3. 两级注意力如何配合
第一级注意力结合热词编码和解码器状态,从音频编码中提取当前所需的特征;解码器状态反映此前已解码的信息。
第二级注意力以该音频特征为依据,对热词编码进行选择和加权,再将两类特征组合用于解码及分类。
分类器同时考虑常用字符、动态加入的热词候选以及非热词情况。因此,添加热词并不等于要求系统强制输出该词。
4. 区分AX-17与AX-70的假设场景
在示例会议中,AX这一共有音段可能使两个代码同时成为候选。后续声音和当前解码上下文帮助区分不同结尾。
配图说明候选术语和音频相互提供约束的流程,不是实测准确率,也不表示某项商业服务支持输入这两个代码。
测试还需覆盖普通词和列表之外的表达。若过度偏向热词,系统可能在无关语句中错误插入候选词。
5. 专利方案与实际产品应分别理解
所引用的讯飞开放平台实时语音转写文档说明,标准服务的个性化热词采用UTF-8中文字符,不支持数字和英文字母。因此AX-17只用于解释专利机制,不能作为该服务支持的输入示例。
AINOTE 2官方产品资料分别介绍转写、翻译和会议总结。这些功能介绍不能直接证明产品实施了特定专利权利要求。
代码识别错误还可能进入翻译和总结结果。只检查最终文字是否流畅,容易忽略最初的对象识别错误。
6. 评估与技术交底的重点
应按会议用途管理候选列表的范围和版本。除整体错误率外,还要检查关键代码是否准确恢复、热词误插入情况及对普通词的影响。
整理技术方案时,应记录两个编码器、解码器状态的使用方式、两级注意力顺序以及普通候选与热词候选的评分方法。
把提出的机制、服务输入限制与实际测量结果分别记录。在同一音频上比较有无上下文处理的结果,有助于说明技术差异。
图中保留原始标注与形态,相关内容在正文中说明。
会议及产品代码为假设示例;产品介绍不等于对特定权利要求实施情况的确认。
Socra AI个性化学习专利:同一道错题为何推荐不同的下一题
了解语音识别与上下文解码技术的整理方式,可参阅IPLEX的AI项目及咨询准备资料。